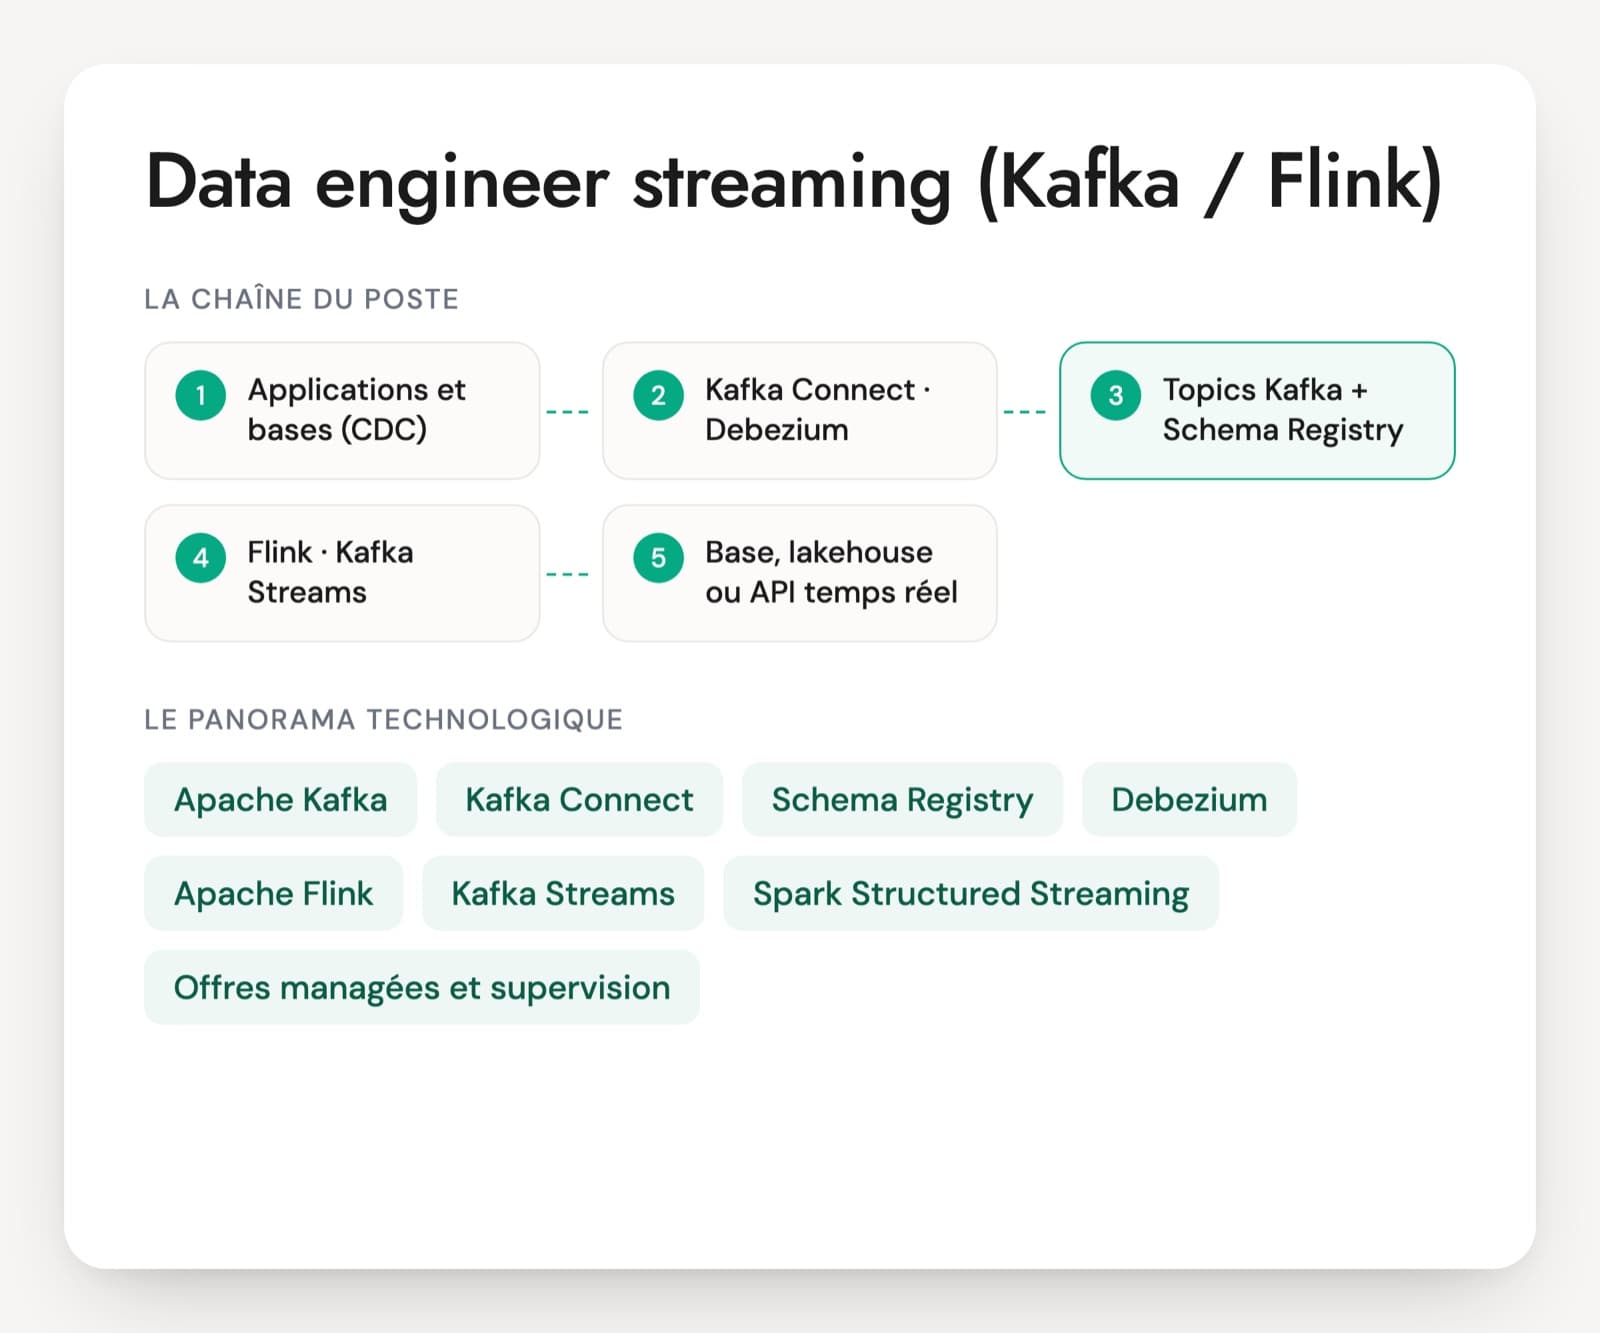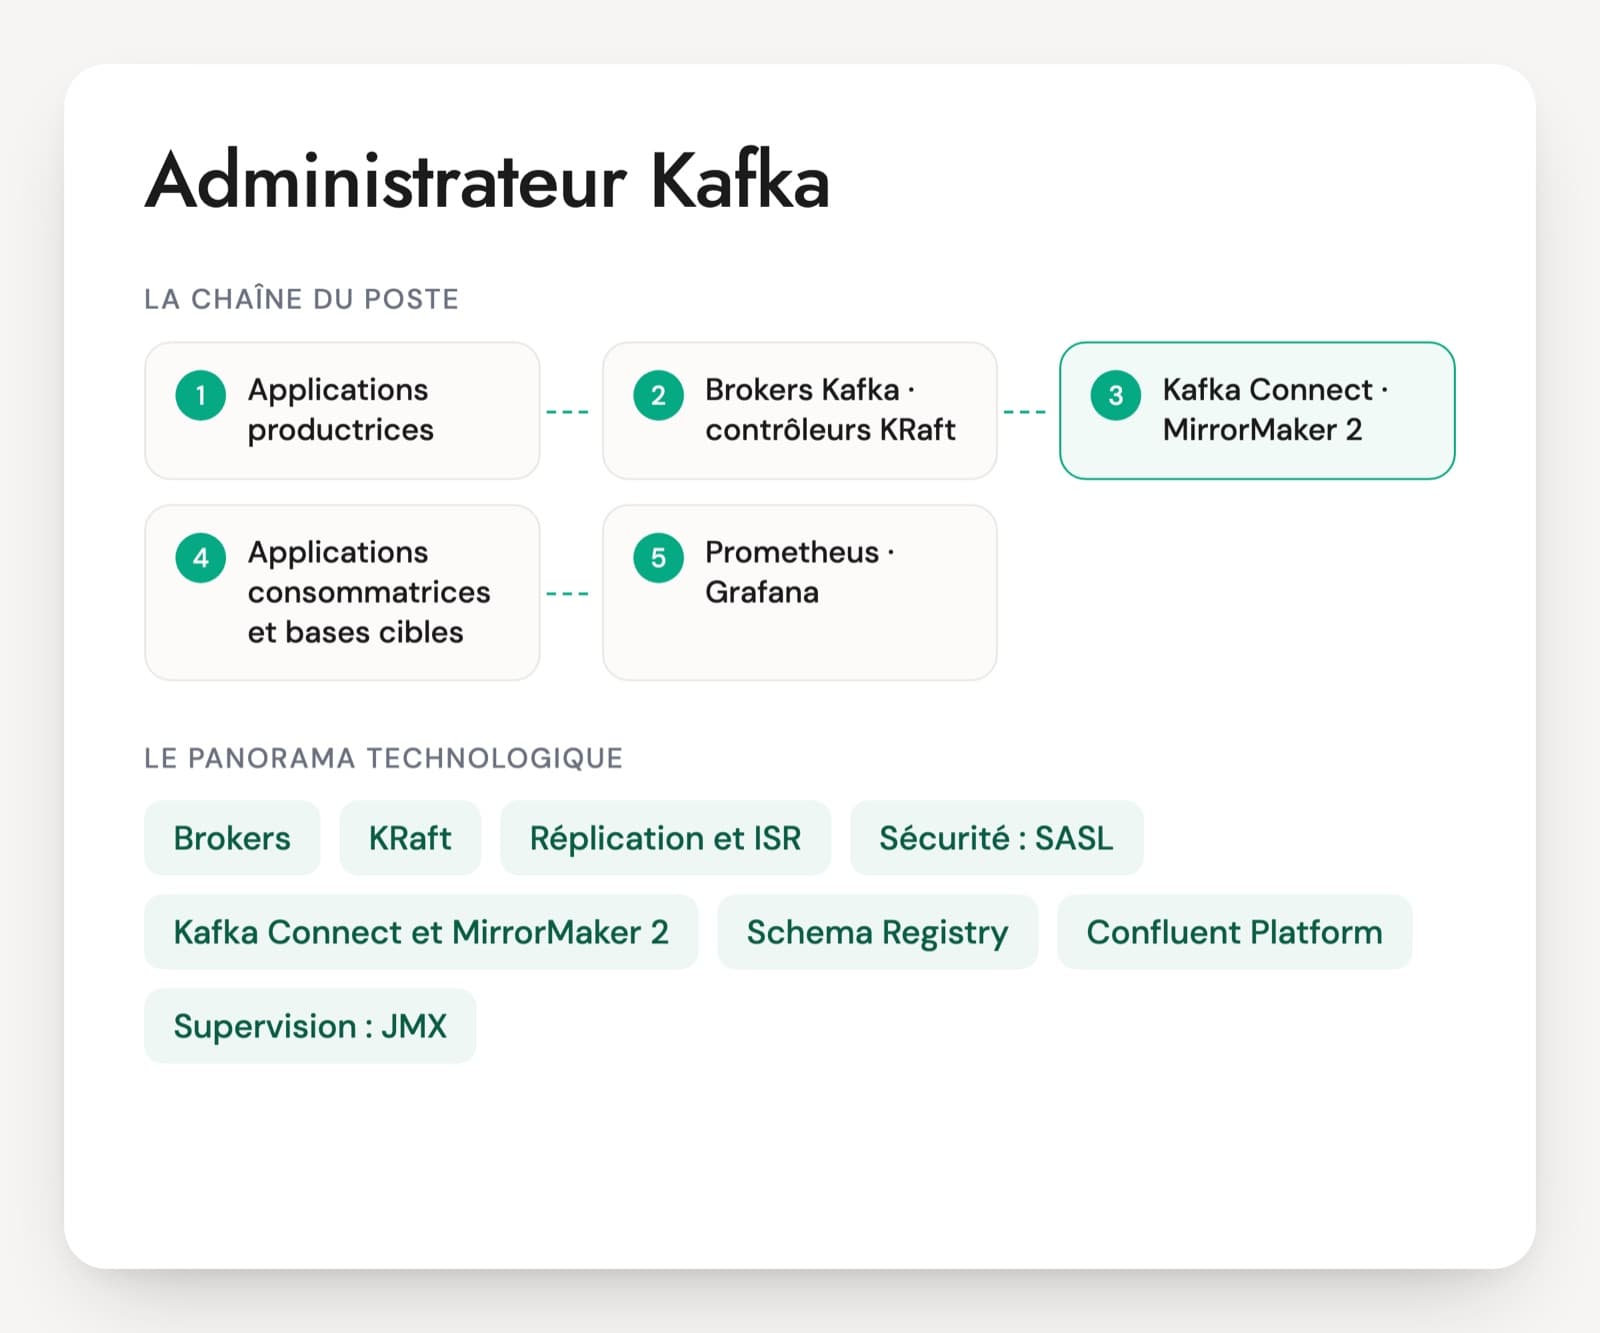
Les questions d'entretien d'un administrateur Kafka ne ressemblent pas à celles d'un data engineer streaming. L'un écrit les applications qui lisent et publient des messages. L'autre tient le cluster : installation des brokers, réplication, droits d'accès, supervision, montées de version et astreinte. Sur Free-Work, les missions s'intitulent souvent expert Kafka ou Confluent et demandent l'administration de clusters en mode KRaft, Kafka Connect, Schema Registry, Ansible et Kubernetes.
La difficulté, c'est que beaucoup de CV citent Kafka après l'avoir utilisé comme client. Un développeur sait ce qu'est un topic et un offset. Il a rarement réassigné des partitions sans saturer le réseau, migré un cluster ZooKeeper vers KRaft ou expliqué pourquoi un acquittement acks=all ne protège de rien quand min.insync.replicas vaut 1. Depuis la version 4.0, ZooKeeper n'existe plus dans Kafka, et les clusters anciens doivent passer par une migration qu'il faut savoir raconter.
Un junior se juge sur la réplication et les acquittements, inutile d'aller plus loin. Chez un senior, le récit d'une montée de version faite sans coupure, avec le plan de retour arrière prévu, montre s'il a vraiment tenu un cluster. La mise en situation de 20 minutes reprend justement un cluster vieillissant.
Ce que recouvre l'exploitation d'un cluster Kafka
Brokers, topics et partitions
Les brokers sont les serveurs qui stockent les messages. Chaque topic est découpé en partitions réparties entre eux, et c'est l'administrateur qui fixe les règles de création, de rétention et de nommage. Une partition ne se supprime pas une fois créée, d'où l'intérêt de demander comment la personne choisit leur nombre.
KRaft (fin de ZooKeeper)
KRaft est le mécanisme interne qui gère les métadonnées du cluster et l'élection des leaders. Il a remplacé ZooKeeper, retiré de Kafka en version 4.0. Beaucoup d'entreprises ont encore des clusters 3.x sous ZooKeeper à migrer, ce qui en fait un sujet d'entretien concret.
Réplication et ISR
Chaque partition est copiée sur plusieurs brokers. Les copies à jour forment l'ISR (in-sync replicas). Le trio facteur de réplication, min.insync.replicas et acks côté producteur décide si un message acquitté peut encore être perdu. Un administrateur doit savoir l'expliquer sans hésiter.
Sécurité : SASL, TLS et ACL
L'authentification passe par SASL (SCRAM, OAuth) ou par certificats TLS, et les ACL définissent quelle application lit ou écrit dans quel topic. Les quotas limitent le débit d'une équipe trop gourmande. Sur un cluster partagé, c'est souvent la partie la plus négligée.
Kafka Connect et MirrorMaker 2
Kafka Connect fait tourner des connecteurs qui chargent ou déchargent des données depuis des bases, des fichiers ou du stockage objet, Debezium compris pour la capture des changements. MirrorMaker 2, bâti sur Connect, réplique un cluster vers un autre, pour un site de secours par exemple. L'administrateur exploite ces clusters Connect en plus des brokers.
Schema Registry
Le registre stocke les schémas Avro, Protobuf ou JSON des messages et refuse ceux qui casseraient les consommateurs. Il garde ses données dans un topic Kafka. L'administrateur le rend disponible et fixe le niveau de compatibilité par défaut.
Confluent Platform, Strimzi et offres managées
Confluent Platform ajoute à Kafka des outils d'administration, un contrôle d'accès par rôles et des connecteurs. Strimzi est un opérateur open source pour faire tourner Kafka sur Kubernetes. Confluent Cloud et Amazon MSK proposent Kafka en service managé. Le poste change beaucoup selon ce choix, précisez-le dans l'annonce.
Supervision : JMX, Prometheus, Grafana, Cruise Control
Kafka expose ses métriques en JMX, collectées le plus souvent par Prometheus et affichées dans Grafana. Les compteurs à surveiller sont les partitions hors ligne, sous-répliquées ou sous le seuil min ISR, la latence des requêtes et le retard des consommateurs. Cruise Control aide à rééquilibrer la charge entre brokers.
Le profil se trouve sous plusieurs titres : administrateur Kafka, expert Kafka Confluent, ingénieur de production middleware, ingénieur DataOps. Dans les grands comptes, Kafka sert souvent de socle d'échange entre applications, et la mission dure un an ou plus avec une part d'astreinte. Dans une équipe plus petite, la même personne gère aussi Kafka Connect, le Schema Registry et parfois Elasticsearch ou Cassandra. Les environnements diffèrent beaucoup : machines virtuelles installées avec Ansible, Kubernetes avec Strimzi, ou service managé où l'exploitation se limite aux droits, aux topics et à la supervision. Demandez lequel la personne a réellement tenu. La certification Confluent Certified Administrator for Apache Kafka atteste les bases, l'expérience de production se vérifie par des incidents racontés en détail.
Les savoir-faire à contrôler chez un administrateur Kafka
- Réplication, ISR et durabilité des messages
- Quorum KRaft et montées de version
- Authentification, ACL et quotas
- Supervision et gestion d'incidents
- Capacité et réassignation des partitions
- Kafka Connect, Schema Registry et MirrorMaker 2
Cinq questions à poser à un administrateur Kafka
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Un topic a un facteur de réplication de 3 et min.insync.replicas à 1. Pourquoi est-ce un réglage risqué, même si les producteurs envoient avec acks=all ?
Une bonne réponseAvec acks=all, le leader attend seulement les répliques présentes dans l'ISR. Si l'ISR se réduit au leader, un message est acquitté alors qu'il n'existe qu'en un exemplaire, et la perte de ce broker le fait disparaître. Le réglage courant pour des données importantes est un facteur de 3, min.insync.replicas à 2, acks=all et l'élection d'un leader hors ISR désactivée. La personne cite le prix à payer : avec deux brokers en panne, les producteurs reçoivent une erreur NotEnoughReplicas au lieu d'écrire.
Signal d'alerte« acks=all garantit trois copies », ou aucune idée de ce qu'est l'ISR. Un profil qui n'a jamais entendu parler de min.insync.replicas.
Question 2 · senior
Vous devez passer en Kafka 4 un cluster 3.x qui tourne encore avec ZooKeeper. Quel chemin suivez-vous ?
Une bonne réponseKafka 4 ne sait plus fonctionner avec ZooKeeper, donc la migration des métadonnées vers KRaft se fait d'abord, sur une version 3.x qui la prend en charge (la 3.9 sert de version de transition). On déploie un quorum de contrôleurs, on passe par la phase où les deux systèmes coexistent, on redémarre les brokers en mode KRaft puis on finalise. Ensuite seulement, montée en 4.x broker par broker. La personne vérifie aussi les clients trop anciens, Java 17 côté brokers et la disparition de MirrorMaker 1.
Signal d'alerte« On arrête tout et on réinstalle », sans plan pour les données ni les clients. Ou ignorer que ZooKeeper a été retiré.
Question 3 · confirmé
Une nouvelle application doit écrire dans un seul topic et lire dans un autre. Comment lui ouvrez-vous l'accès ?
Une bonne réponseUne identité propre à l'application (utilisateur SCRAM, certificat ou client OAuth), une connexion par un listener SASL_SSL, puis des ACL au plus juste : Write sur le premier topic, Read sur le second et Read sur son groupe de consommateurs. Le cluster refuse tout accès sans ACL explicite. Un quota de débit peut s'ajouter. Le tout est déclaré dans un dépôt Git (Terraform, ressources Strimzi ou outil maison) et relu avant application.
Signal d'alerteUn compte partagé par toutes les applications, un listener en clair « parce que le réseau est interne », ou une ACL sur tous les topics avec un joker.
Question 4 · confirmé
L'alerte UnderMinIsrPartitionCount se déclenche à 3 h du matin. Que faites-vous dans les dix premières minutes ?
Une bonne réponseD'abord l'impact : les producteurs en acks=all n'écrivent plus sur ces partitions. Puis la liste des partitions touchées (kafka-topics avec l'option des partitions sous le min ISR) et le broker en cause. Les causes habituelles sont un broker arrêté, un disque plein ou lent, de longues pauses du ramasse-miettes Java ou un problème réseau. La personne corrige la cause et refuse d'activer l'élection hors ISR sans décision explicite du métier, puisqu'elle accepte de perdre des messages.
Signal d'alerteRedémarrer tous les brokers en même temps, ou activer tout de suite l'élection hors ISR pour faire disparaître l'alerte.
Question 5 · confirmé
Vous ajoutez deux brokers à un cluster saturé. Le lendemain, ils ne portent presque aucune donnée. Pourquoi, et que faites-vous ?
Une bonne réponseKafka ne déplace pas les partitions existantes vers un nouveau broker, seuls les topics créés ensuite en profitent. Il faut un plan de réassignation (kafka-reassign-partitions avec generate, execute et verify) ou un outil comme Cruise Control. Le transfert est limité par un throttle pour ne pas saturer le réseau, se fait par lots en heure creuse, et le throttle est retiré à la fin. Une élection des leaders préférés rééquilibre ensuite la charge.
Signal d'alerteCroire que Kafka rééquilibre tout seul, ou lancer la réassignation de tout le cluster d'un coup sans limiter le débit.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Recruter un administrateur Kafka : réponses aux questions courantes
Quelle différence entre un administrateur Kafka et un data engineer Kafka ?
Le data engineer écrit les applications : producteurs, consommateurs, traitements Kafka Streams ou Flink, schémas des événements. L'administrateur tient la plateforme sur laquelle ces applications tournent. Il installe et met à jour les brokers, règle la réplication, gère les droits et les quotas, surveille le cluster et intervient en astreinte. Les deux profils se recoupent sur la compréhension des partitions et des offsets. En entretien, un développeur décroche dès qu'on parle de réassignation, de quorum KRaft ou d'ACL.
Quelles compétences attendre d'un administrateur Kafka confirmé ?
La réplication et ses réglages de durabilité, l'exploitation en mode KRaft et la migration depuis ZooKeeper, la sécurité avec SASL, TLS et ACL, la supervision des métriques JMX et la réassignation de partitions. Ajoutez Linux, l'automatisation avec Ansible ou Kubernetes et Strimzi selon votre environnement, et souvent Kafka Connect et le Schema Registry. Pour une mission avec astreinte, demandez des incidents vécus avec leur cause et la correction apportée.
La certification Confluent pour administrateurs suffit-elle ?
La certification Confluent Certified Administrator for Apache Kafka montre que la personne connaît l'architecture, la configuration et la sécurité du cluster. Elle ne prouve pas qu'elle a migré un cluster vers KRaft, rattrapé une partition hors ligne ou dimensionné des brokers. Utilisez-la comme indice de sérieux, puis demandez un incident précis et une opération lourde menée de bout en bout, avec les commandes et les métriques consultées.
Quel test technique proposer à un administrateur Kafka ?
Un exercice de diagnostic fonctionne mieux qu'un questionnaire. Montrez la sortie d'un kafka-topics --describe avec des partitions sous-répliquées, ou une capture de tableau de bord pendant un incident, et demandez à la personne ce qu'elle regarde ensuite et dans quel ordre. Un plan de montée de version à écrire en vingt minutes donne aussi une bonne idée de sa rigueur. Faites-la parler pendant l'exercice pour suivre son raisonnement.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.