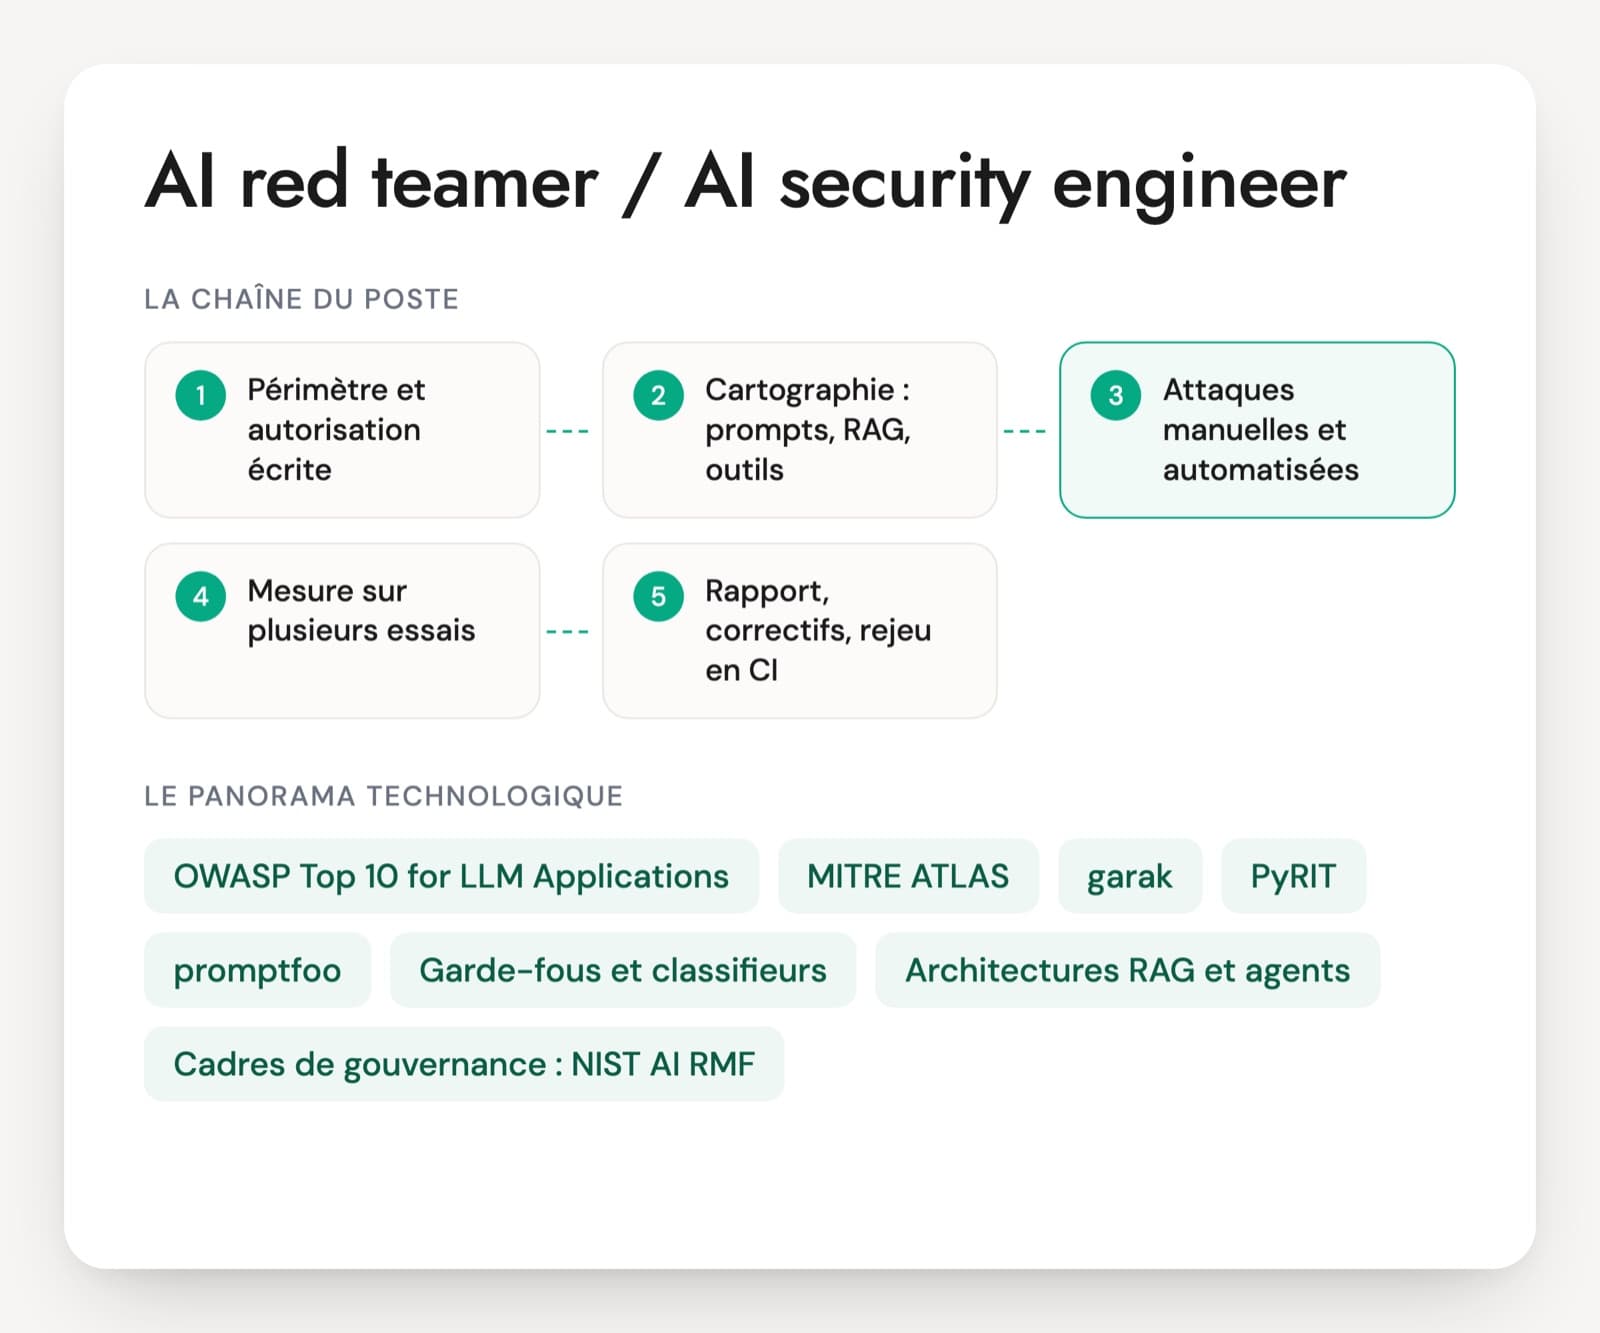
Un AI red teamer, souvent appelé AI security engineer dans les offres, mène des tests offensifs sur des applications à base de LLM : injections de prompt, jailbreaks, détournement des outils d'un agent, fuites de données par un RAG. Il automatise ses campagnes en Python, s'appuie sur l'OWASP Top 10 for LLM et sur MITRE ATLAS, puis rédige des rapports de vulnérabilité exploitables par les équipes produit. Les offres françaises viennent surtout de grands comptes, d'ESN et de cabinets de cybersécurité.
La difficulté du recrutement tient au double profil. Un pentesteur applicatif sait exploiter une faille et écrire un rapport, sans toujours comprendre comment un modèle lit un document ou choisit un outil. Un profil venu de la data science connaît les modèles mais rarement la rigueur d'une campagne offensive, avec son périmètre, ses preuves et sa sévérité. Les deux parlent volontiers de jailbreak.
Une fois l'origine du profil identifiée lors d'un premier échange, ces questions prennent leur place. Une campagne bien cadrée sur un seul chatbot suffit pour un junior. On attend d'un senior qu'il ait testé un agent qui appelle des outils et qu'il sache coter la sévérité d'une injection indirecte. Le cas pratique joint simule un assistant RH agentique.
Référentiels et outils d'attaque d'un AI red teamer
OWASP Top 10 for LLM Applications
La liste de référence des risques d'une application à base de LLM, dans sa version 2025 : injection de prompt, divulgation d'informations sensibles, fuite du prompt système, autonomie excessive d'un agent, consommation non bornée, faiblesses des bases vectorielles. Un AI red teamer s'en sert pour couvrir son périmètre et classer ses trouvailles. Une personne qui la récite sans exemple vécu reste à creuser.
MITRE ATLAS
Une base de connaissances des tactiques et techniques d'attaque contre les systèmes d'IA, construite sur le modèle de MITRE ATT&CK et illustrée d'études de cas. Là où l'OWASP décrit des risques côté application, ATLAS décrit le chemin de l'attaquant. Les offres françaises la citent souvent avec l'OWASP.
garak
Un scanner open source de vulnérabilités de LLM hébergé par NVIDIA. Il envoie des séries d'attaques (les probes) à un modèle ou à un point d'accès, puis des détecteurs jugent si la réponse trahit une faiblesse. Pratique pour un balayage large, il ne connaît rien du métier ni des outils de l'application testée.
PyRIT
Le framework Python de Microsoft pour scénariser des attaques contre des systèmes d'IA générative, désormais publié sous l'organisation microsoft sur GitHub. On y combine des cibles, des convertisseurs qui transforment les messages (encodage, traduction), des évaluateurs et des attaques en plusieurs tours comme Crescendo ou TAP.
promptfoo
Un outil open source de tests de LLM qui propose un module de red teaming par plugins (contenus interdits, contrôles d'accès cassés) et par stratégies d'attaque. Il se branche dans une chaîne CI pour rejouer les attaques à chaque changement de prompt ou de modèle. Les campagnes automatiques consomment des tokens, donc un coût à surveiller.
Garde-fous et classifieurs
NeMo Guardrails, Llama Guard et Prompt Guard chez Meta, Prompt Shields dans Azure AI Content Safety : des filtres qui tentent de repérer une injection ou un contenu interdit en entrée et en sortie. Le red teamer mesure leur taux de contournement. Un candidat qui les présente comme une protection complète n'a pas encore cherché à les contourner.
Architectures RAG et agents
Le terrain d'attaque principal : bases vectorielles, connecteurs vers SharePoint ou une GED, appels de fonctions, serveurs MCP, agents qui enchaînent plusieurs outils. Pour attaquer ces chaînes, il faut savoir d'où vient chaque morceau de texte que lit le modèle et ce que chaque outil a le droit de faire.
Cadres de gouvernance : NIST AI RMF, AI Act, ANSSI
Le NIST AI RMF et sa taxonomie des attaques adverses servent de vocabulaire commun. L'AI Act demande des tests adverses documentés aux fournisseurs de modèles à usage général à risque systémique, et de la robustesse face aux attaques propres à l'IA pour les systèmes à haut risque. L'ANSSI a publié des recommandations de sécurité pour les systèmes d'IA générative.
Le poste reste rare en France et ses intitulés varient : AI red teamer, AI security engineer, pentesteur IA, consultant sécurité des LLM. Dans un cabinet de cybersécurité ou une ESN, il enchaîne des audits courts chez des clients qui ouvrent un assistant au public ou à leurs salariés. Chez un éditeur ou un grand compte, il teste en continu les nouvelles versions et outille les équipes produit avec des tests de régression. Les offres demandent en général plusieurs années de sécurité offensive, du Python et une connaissance pratique des RAG et des agents. Un autre profil existe, plus tourné vers le contenu (toxicité, biais, désinformation), souvent recruté en freelance pour évaluer des modèles : précisez lequel vous cherchez avant l'entretien.
Les compétences offensives à contrôler chez un AI red teamer
- Injection de prompt directe et indirecte
- Jailbreaks et contournement des garde-fous
- Sécurité des agents et de leurs outils
- Fuites de données par le RAG et le modèle
- Automatisation et mesure des attaques
- Remédiation et rapport de vulnérabilité
Un AI red teamer devant cinq scénarios d'attaque
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Un assistant RAG résume des contrats envoyés par des clients. Comment testez-vous une injection de prompt cachée dans l'un de ces documents ?
Une bonne réponseC'est une injection indirecte. Il cache des instructions dans un document de test : texte blanc sur fond blanc, métadonnées, pied de page, texte dans une image si un OCR tourne. Il y place un marqueur observable, par exemple un mot précis à faire écrire ou une URL qu'il contrôle à faire appeler. Il varie la position et la langue, rejoue plusieurs fois, puis mesure l'effet réel : résumé faussé, contenu d'un autre document divulgué, outil déclenché.
Signal d'alerteTaper « ignore les instructions précédentes » dans la fenêtre de chat et s'arrêter là. Confondre injection directe et indirecte, ou conclure après un seul essai.
Question 2 · senior
Un agent lit les e-mails entrants et affiche ses réponses en Markdown dans une interface web. Par où une donnée peut-elle sortir sans qu'aucun outil d'envoi ne soit appelé ?
Une bonne réponsePar le rendu. Une image Markdown dont l'URL contient la donnée encodée fait partir une requête du navigateur vers le serveur de l'attaquant dès l'affichage. Même chose avec un lien cliquable ou un aperçu de lien généré côté serveur. Il le démontre avec un e-mail piégé qui demande à l'agent de glisser l'historique dans une URL d'image. Correctifs : pas d'images externes ou une liste de domaines autorisés, une politique CSP, la sortie du modèle traitée comme une donnée non fiable.
Signal d'alerte« Sans outil d'envoi, rien ne peut sortir. » Ou ne regarder que les appels d'outils de l'agent, jamais ce que fait l'interface avec sa réponse.
Question 3 · confirmé
Votre jailbreak passe une fois sur dix. Comment le rapportez-vous, et comment le client vérifie-t-il sa correction ?
Une bonne réponseAvec un taux mesuré sur un nombre d'essais annoncé, cinquante ou cent par exemple, et les conditions : modèle et version, température, prompt système, date. Il fournit la conversation complète et un script de rejeu (PyRIT, promptfoo ou garak). Après correctif, il rejoue le même jeu et des variantes (paraphrase, encodage, autre langue), pour écarter un correctif qui ne bloque que la phrase exacte. Le cas rejoint ensuite les tests de régression.
Signal d'alerteUne capture d'écran unique en guise de preuve. « Pas reproductible à chaque fois, donc pas grave. » Ou un seul essai pour valider la correction.
Question 4 · confirmé
Dans un chatbot interne branché sur SharePoint, un stagiaire obtient des extraits de notes RH. Où cherchez-vous la faille ?
Une bonne réponseDans le contrôle d'accès de la recherche, pas dans le prompt. Les morceaux indexés dans la base vectorielle ont-ils gardé les droits du document source ? Le filtre est-il appliqué côté serveur avec l'identité de l'utilisateur ? Les droits sont-ils resynchronisés quand ils changent dans SharePoint ? Il teste avec deux comptes aux droits différents et des requêtes ciblées. Il classe le résultat en divulgation d'informations sensibles et en faiblesse de la base vectorielle.
Signal d'alerte« On ajoute au prompt système l'interdiction de citer les documents RH. » Ou partir à la recherche d'un jailbreak alors que le modèle a simplement reçu des documents qu'il n'aurait jamais dû voir.
Question 5 · senior
Vous avez prouvé qu'un document piégé fait envoyer un e-mail par l'agent. Que recommandez-vous, et dans quel ordre ?
Une bonne réponseD'abord réduire ce qu'une injection réussie peut faire. Droits minimaux sur les outils (destinataires internes seulement, lecture seule ailleurs), confirmation humaine pour les actions sensibles, contenu non fiable séparé et marqué dans le contexte. Puis des filtres de détection en complément, et la journalisation de chaque appel d'outil. Un senior cite les architectures qui isolent le contenu non fiable du modèle qui planifie (dual LLM, CaMeL) et admet qu'aucun filtre ne supprime le risque.
Signal d'alerteRenforcer le prompt système comme unique mesure, ou bloquer la phrase « ignore previous instructions » et considérer la faille close.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Recruter un AI security engineer : les points qui reviennent
Quelle différence entre un AI red teamer et un pentesteur applicatif ?
Le pentesteur cherche des failles dans du code et des configurations dont le comportement est stable. L'AI red teamer attaque un système dont la réponse varie d'un essai à l'autre et qui lit des instructions dans des données : un e-mail, une page web, un document indexé. Il doit donc mesurer des taux de réussite et suivre le chemin du texte jusqu'aux outils de l'agent. Beaucoup viennent du pentest, et les bases (périmètre, preuve, sévérité) restent les mêmes.
Vaut-il mieux un passé en cybersécurité ou en machine learning ?
Les offres françaises demandent surtout de la sécurité offensive, avec une connaissance pratique des RAG et des agents. Un profil sécurité apprend plus vite le fonctionnement d'un LLM qu'un profil data n'acquiert la méthode d'un audit. Pour attaquer des modèles open weights (suffixes adverses, empoisonnement, extraction), un bagage en machine learning devient utile. Décidez selon votre périmètre : applications construites sur des API de modèles, ou modèles entraînés et hébergés chez vous.
Quel test technique proposer à un AI red teamer ?
Un petit environnement volontairement vulnérable : un assistant avec un RAG de quelques documents et un outil d'envoi factice. Laissez une heure pour obtenir une fuite ou une action non prévue, puis demandez une fiche de vulnérabilité avec les étapes de reproduction et une recommandation. Vous jugez en même temps l'attaque, la mesure et l'écriture. L'exercice se fait mieux en direct, la personne commentant ses essais à voix haute.
Quelles preuves de pratique chercher sur le CV ?
Les certifications de sécurité offensive attestent le socle du pentest. Côté IA, regardez des productions vérifiables : rapports ou articles publics, contributions à garak, PyRIT ou promptfoo, signalements de failles à des programmes de bug bounty d'éditeurs de modèles, résultats de CTF consacrés aux LLM. En entretien, faites raconter une campagne du périmètre à la correction, avec le taux de réussite de l'attaque principale.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.