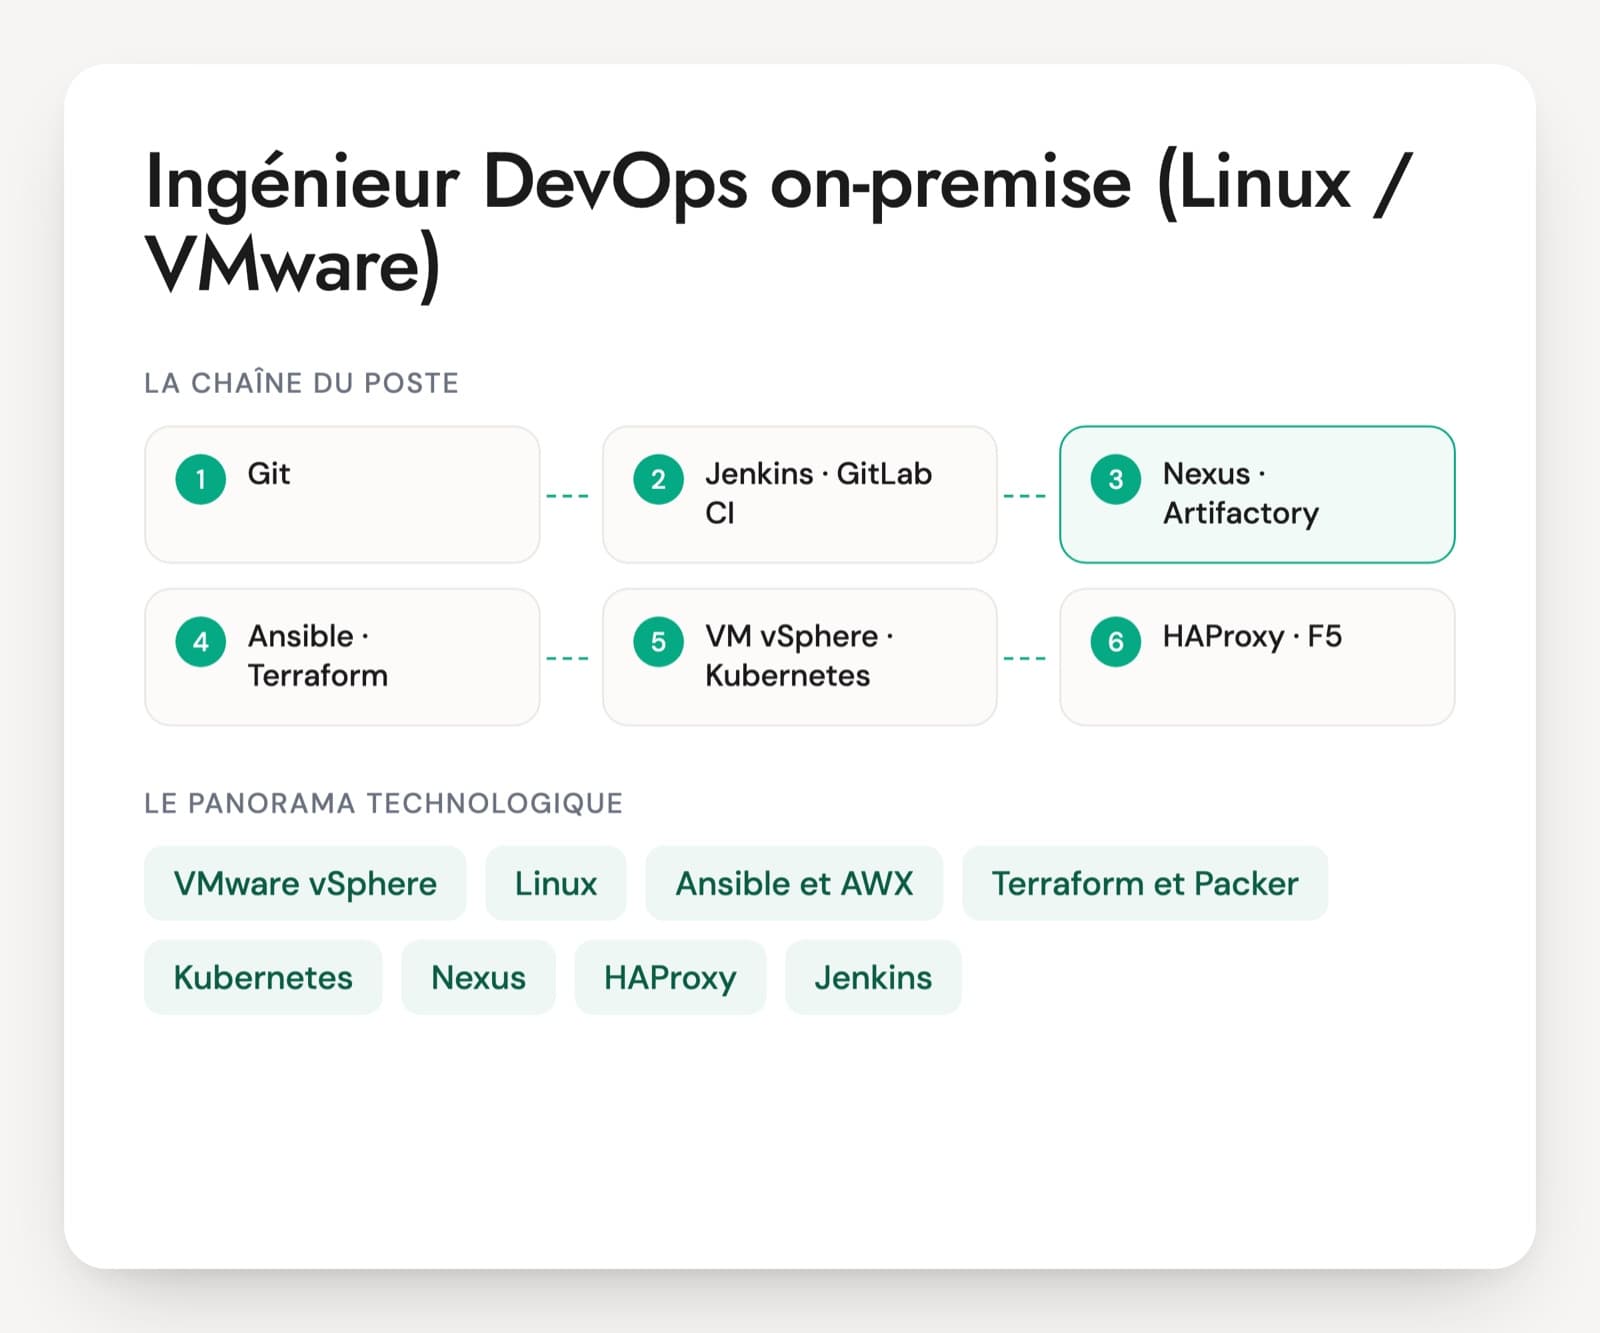
Un ingénieur DevOps on-premise travaille sur l'infrastructure que l'entreprise possède ou loue chez un hébergeur : des hôtes VMware vSphere, des serveurs Red Hat ou Rocky Linux, un Kubernetes installé avec kubeadm ou RKE2, parfois un OpenShift. Les offres citent Ansible ou AWX, Terraform avec le provider vSphere, Jenkins ou GitLab CI auto-hébergés, Nexus ou Artifactory, HAProxy ou F5, et des middlewares comme Tomcat, JBoss ou Nginx.
Le risque principal vient des profils formés sur un cloud public. Ils écrivent du Terraform et des pipelines propres, mais n'ont jamais eu à sortir par un proxy, à faire reconnaître une CA interne ou à installer un cluster sans accès à internet. Ici, un build qui échoue parce que Docker Hub est injoignable fait partie du quotidien. L'inverse existe aussi. Un administrateur système solide peut encore configurer ses serveurs avec des scripts lancés en SSH et appeler cela de l'automatisation.
Le périmètre varie beaucoup : ce que l'équipe opère elle-même (stockage, réseau, sauvegardes) et ce qui reste à d'autres équipes. Le candidat décrit le dernier correctif de sécurité appliqué à tout un parc, de la préparation au retour arrière prévu. Le PDF joint propose un entretien complet sur six axes, avec un cas pratique sur un parc de 200 VM.
Les outils d'un ingénieur DevOps on-premise, du datacenter au cluster
VMware vSphere (ESXi, vCenter)
La couche de virtualisation de la plupart des datacenters. ESXi fait tourner les VM sur chaque hôte, vCenter pilote l'ensemble : clusters, modèles, placement des VM. Le DevOps ne l'administre pas toujours, mais il y crée ses VM par API, avec Terraform ou Ansible. Depuis le rachat de VMware par Broadcom et la refonte des licences, beaucoup d'équipes revoient leurs contrats, et certaines étudient une sortie.
Linux (RHEL, Rocky, Debian, Ubuntu)
Le socle de tout le reste : systemd, SELinux, LVM, réseau, dépôts de paquets internes. Un bon profil diagnostique un serveur en ligne de commande et sait patcher un parc par vagues, sans tout redémarrer en même temps. L'évaluation commence par là.
Ansible et AWX
L'outil de configuration le plus cité des offres on-premise. Les playbooks décrivent l'état attendu des serveurs. AWX, ou Ansible Automation Platform chez Red Hat, les lance avec des inventaires, des droits et un historique. Sur des centaines de machines, les vrais sujets sont l'inventaire dynamique, l'idempotence des rôles et la durée d'exécution.
Terraform et Packer
Packer fabrique les modèles de VM (image Linux durcie, agent de supervision, certificats internes) et Terraform crée les VM à partir de ces modèles avec le provider vSphere. Sans cloud, l'état Terraform doit être stocké en interne. OpenTofu, le fork open source de Terraform, apparaît aussi sur les CV.
Kubernetes ou OpenShift auto-hébergé
Sur site, le cluster n'arrive pas tout prêt. Il faut l'installer (kubeadm, RKE2 ou l'installateur OpenShift), lui fournir un équilibreur pour les services exposés, un stockage persistant et un registre d'images. Les montées de version et les certificats du cluster sont à la charge de l'équipe.
Nexus ou Artifactory
Le dépôt d'artefacts interne. Il sert de proxy vers Maven Central, npm, PyPI ou Docker Hub et stocke les livrables maison. Quand le datacenter n'a pas d'accès direct à internet, tous les builds passent par lui. Sonatype distribue Nexus Repository en Community Edition gratuite et en éditions payantes.
HAProxy, F5 et DNS interne
Les load balancers répartissent le trafic entre les serveurs et portent souvent la terminaison TLS. Le DNS interne et l'autorité de certification de l'entreprise décident si un service est joignable et reconnu. Une bonne part des incidents on-premise se règle à cet endroit.
Jenkins ou GitLab CI auto-hébergé
La chaîne d'intégration tourne elle aussi dans le datacenter, avec ses agents ou runners sur des VM. Le DevOps la maintient en plus de l'utiliser : mises à jour, plugins, agents, accès au réseau interne. Il doit avoir déjà assuré cette maintenance, pas seulement écrit des pipelines.
Tomcat, JBoss et Nginx
Beaucoup d'applications tournent encore sur des serveurs d'applications Java installés sur VM. Déployer un WAR, régler les pools de connexions et la rotation des journaux fait partie du poste, avant ou à côté de la conteneurisation.
Le poste se trouve dans les organisations qui gardent leur infrastructure dans leurs datacenters ou chez un hébergeur, souvent avec des équipes séparées pour le réseau, le stockage et la sécurité. L'ingénieur DevOps on-premise passe donc par des demandes d'ouverture de flux et des fenêtres de changement, ce qu'un profil venu du cloud découvre parfois en arrivant. Les certifications Red Hat (RHCSA pour l'administration, RHCE désormais déclinée en Ansible ou en Enterprise Linux) et la CKA pour Kubernetes attestent un socle. Depuis la refonte des licences VMware par Broadcom, des équipes étudient une sortie vers Proxmox VE, Nutanix ou OpenShift Virtualization. Dans ce cas s'ajoutent des questions de migration de VM.
Les savoir-faire attendus d'un DevOps on-premise
- Linux en production et correctifs de parc
- Ansible à grande échelle
- Création de VM vSphere par le code
- Kubernetes ou OpenShift auto-hébergé
- Dépôts d'artefacts et builds sans internet
- Load balancing, DNS et certificats internes
Cinq questions techniques pour un ingénieur DevOps sur VMware et Linux
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · senior
Un playbook Ansible met deux heures à passer sur 800 serveurs et en laisse une trentaine en échec. Que changez-vous ?
Une bonne réponseIl regarde d'abord où le temps passe, avec le callback qui chronomètre les tâches. Ensuite : plus de forks, le pipelining SSH, la stratégie free quand l'ordre ne compte pas, une collecte des facts réduite ou mise en cache, et moins de boucles qui ouvrent une connexion par élément (une liste de paquets installée en un seul appel). Pour les échecs, une relance limitée aux hôtes en erreur avec --limit, et serial avec max_fail_percentage pour qu'une erreur ne parte pas sur tout le parc.
Signal d'alerteRelancer le playbook à la main sur des listes de serveurs copiées dans un fichier, ou accepter deux heures « parce que c'est Ansible ». Aucune idée de l'endroit où le temps passe.
Question 2 · confirmé
Une équipe attend chaque nouvelle VM pendant deux semaines. Comment automatisez-vous la création d'une VM Linux prête à l'emploi sur vSphere ?
Une bonne réponseUn modèle construit par Packer à partir d'une image d'installation et reconstruit régulièrement (correctifs, agent de supervision, CA interne). Terraform clone ce modèle avec le provider vSphere et fixe CPU, mémoire, disques, réseau et dossier. Le nom et l'adresse IP passent par la personnalisation VMware ou cloud-init. Ansible termine la configuration, puis la VM est enregistrée dans le DNS et l'inventaire. Le tout part d'une merge request, avec un plan relu.
Signal d'alerteCloner à la main une VM existante dans vCenter, avec ses anciennes clés SSH et son identifiant machine, ou un script PowerCLI que lui seul sait lancer.
Question 3 · confirmé
Le datacenter n'a aucun accès direct à internet. Comment vos builds récupèrent-ils leurs dépendances Maven et npm, et leurs images de base ?
Une bonne réponsePar un dépôt interne, Nexus ou Artifactory, configuré en proxy des dépôts publics et seul autorisé à sortir, souvent par le proxy de l'entreprise. Les outils de build pointent dessus (settings.xml, .npmrc, miroir de registre pour Docker ou containerd). Les images de base sont recopiées et figées par version. La CA interne est installée dans les images et dans le magasin de certificats Java, faute de quoi les appels TLS échouent.
Signal d'alerteOuvrir internet au cas par cas sur les agents de build, ou désactiver la vérification des certificats (curl -k, strict-ssl à false) pour que ça passe.
Question 4 · confirmé
Les certificats d'un cluster Kubernetes installé avec kubeadm expirent dans dix jours. Que faites-vous, et comment évitez-vous que cela se reproduise ?
Une bonne réponsekubeadm certs check-expiration pour voir l'état, puis kubeadm certs renew sur chaque nœud du plan de contrôle et le redémarrage des pods statiques (API server, controller manager, scheduler, etcd). Les certificats des kubelets se renouvellent seuls si la rotation est active. Il sait qu'une montée de version avec kubeadm renouvelle aussi les certificats, et il pose une alerte sur leur échéance.
Signal d'alerteDécouvrir le problème le jour où kubectl ne répond plus, ou réinstaller le cluster.
Question 5 · junior à confirmé
Sur votre cluster sur site, un Service de type LoadBalancer reste en Pending. Pourquoi, et comment exposez-vous l'application ?
Une bonne réponseSans cloud, aucun contrôleur ne fournit d'adresse externe. Il faut MetalLB (en mode L2 ou BGP, avec une plage d'adresses réservée auprès de l'équipe réseau), kube-vip, ou un ingress controller exposé en NodePort derrière le HAProxy ou le F5 déjà en place. Sur OpenShift, les routes et le routeur d'ingress par défaut couvrent ce besoin.
Signal d'alerte« Il faut attendre », ou supprimer et recréer le service sans comprendre qu'aucun équilibreur n'existe dans le cluster.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
DevOps sur site : questions fréquentes
Qu'est-ce qui sépare un DevOps on-premise d'un DevOps cloud ?
Le socle est le même : Linux, Git, CI/CD, conteneurs, Terraform et Ansible. L'écart tient à ce qu'un cloud fournit et qu'il faut ici installer et opérer soi-même : la création des VM sur vSphere, le load balancer, le stockage des clusters, le registre d'images, les certificats et l'accès aux dépendances sans internet. Un profil cloud peut s'adapter, surtout s'il a déjà travaillé avec des équipes réseau et des contraintes de datacenter.
Quelle place donner aux certifications Red Hat et VMware ?
Une indication, pas une exigence. La RHCSA couvre l'administration Linux, la RHCE se décline désormais par domaine (Ansible ou Enterprise Linux), et les certifications VMware attestent la connaissance de vSphere. Aucune ne montre qu'une personne a déjà patché un parc de production ou repris un cluster existant. Compte plutôt un incident vécu sur un serveur ou une montée de version menée de bout en bout, avec les étapes et le retour arrière prévu.
Quelle mise en situation donner à un DevOps on-premise ?
Un exercice court en entretien vaut mieux qu'un long test technique à rendre. L'exercice part d'un playbook Ansible qui casse au second passage, ou d'une VM qui ne joint pas un service interne, avec un diagnostic à voix haute. On voit vite si la personne pense idempotence, DNS, proxy et certificats, ou si elle tâtonne. Une machine isolée est nécessaire pour qu'elle tape réellement des commandes.
Un administrateur Linux pour ce poste, est-ce une bonne piste ?
Souvent, et c'est un parcours fréquent sur les postes on-premise. L'administrateur connaît déjà le système, le réseau et les contraintes de production. L'entretien vérifie ce qui manque le plus souvent : écrire du code versionné et testé plutôt que des scripts, passer par des merge requests, décrire l'infrastructure dans Terraform ou Ansible plutôt qu'à la main. Les questions sur l'idempotence et sur les modèles de VM montrent vite où en est la personne.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.