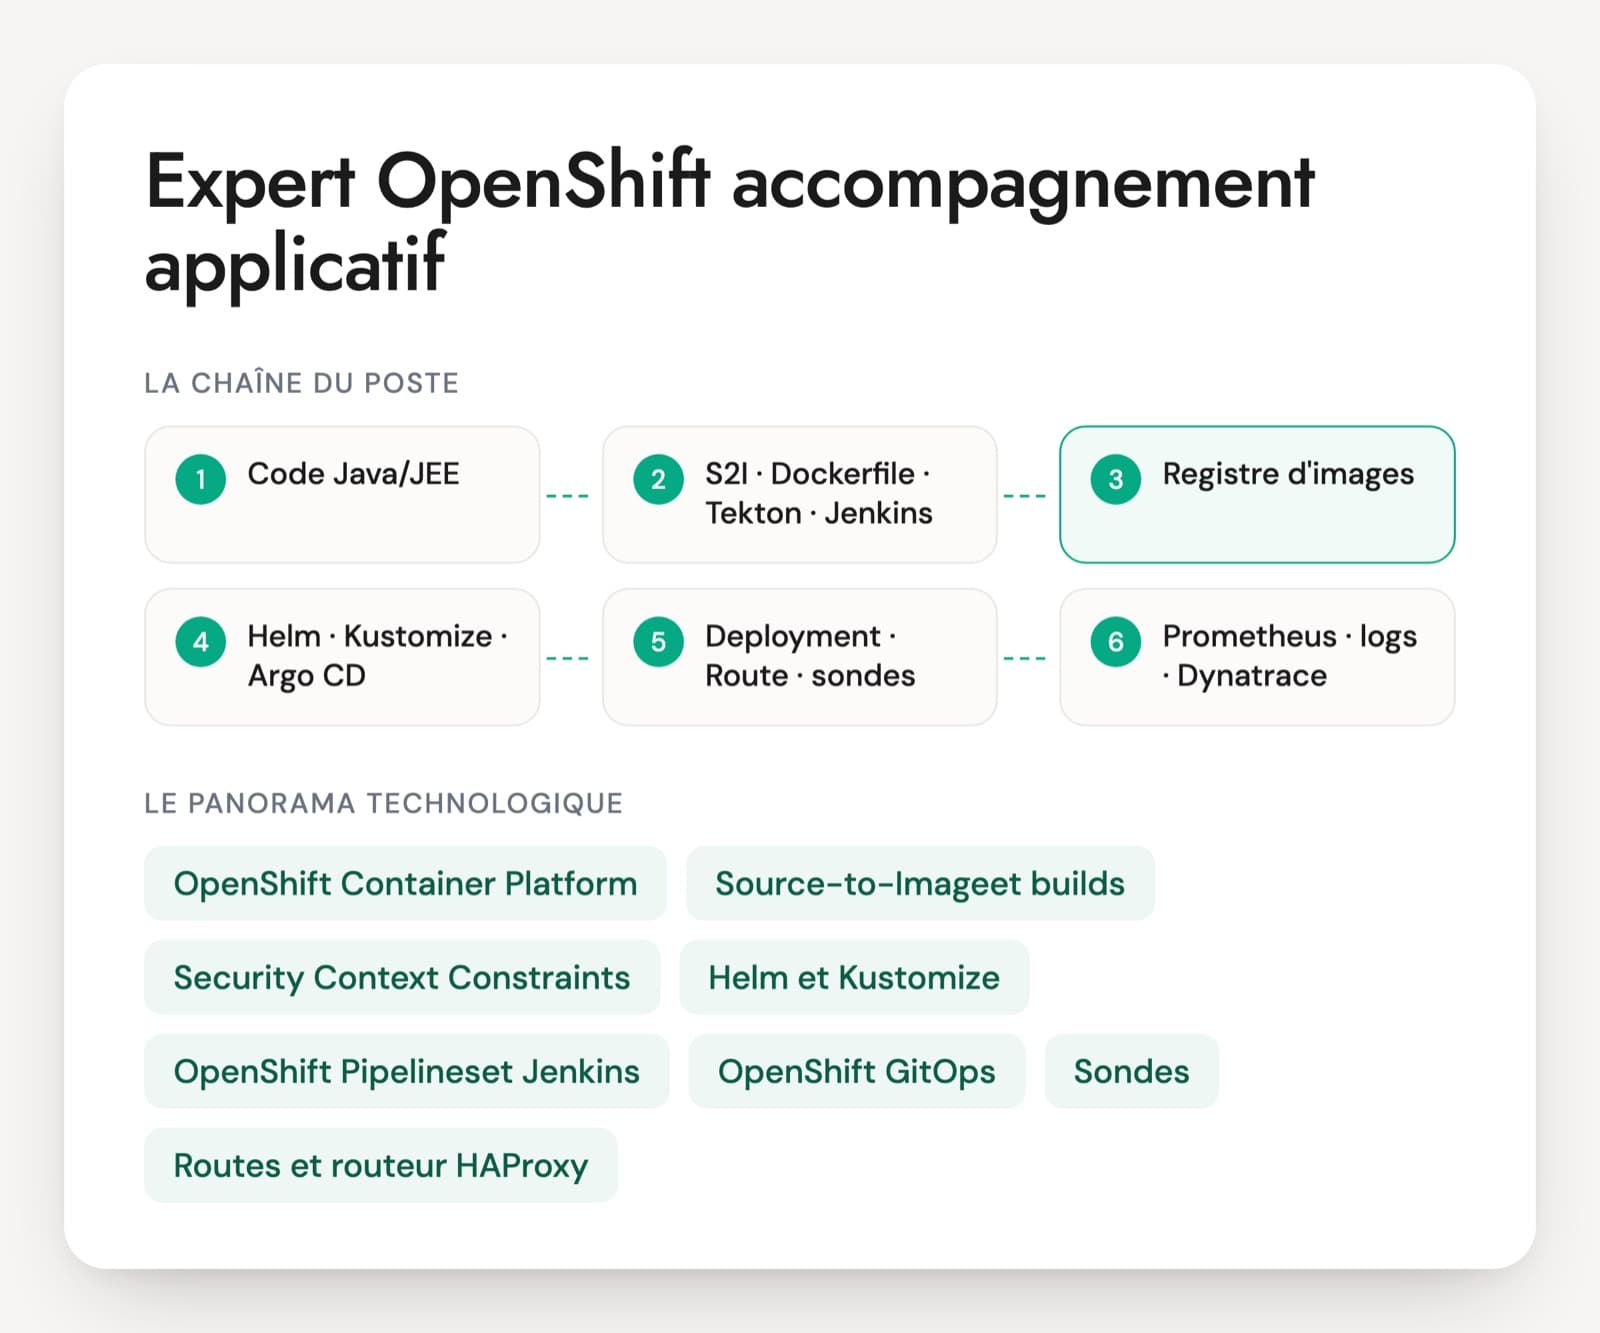
Avant tout entretien d'expert OpenShift en accompagnement applicatif, la fiche de poste mérite une relecture avec le manager. Elle ressemble souvent à celle d'un administrateur, alors que la personne ne monte pas les clusters. Elle reçoit une application JEE qui tournait sur un JBoss ou un Tomcat en VM, la conteneurise, choisit entre S2I et Dockerfile, écrit le chart Helm ou les overlays Kustomize, branche le déploiement dans Argo CD et règle la mémoire et les sondes. Puis elle forme l'équipe pour qu'elle se débrouille seule.
Deux profils postulent souvent à tort. Le spécialiste Kubernetes générique découvre les SCC le jour où une image refuse de tourner avec un UID aléatoire. L'administrateur de plateforme connaît les opérateurs et les montées de version, moins un pool de connexions épuisé ou une JVM tuée par sa limite mémoire. Un bon signe : la personne parle de restricted-v2, de routes et de leurs délais, de MaxRAMPercentage, d'oc debug et des journaux du conteneur précédent.
Le récit d'une application réelle passée sur OpenShift distingue les profils : son état de départ, ce qui a changé dans le code et la configuration, ce que l'équipe sait faire sans aide aujourd'hui. Les missions en France associent souvent Jenkins ou Tekton, Argo CD, External Secrets et Dynatrace. Le PDF propose l'entretien complet sur six axes.
Ce qu'un expert OpenShift applicatif manipule avec les équipes projet
OpenShift Container Platform
La distribution Kubernetes de Red Hat. Pour ce poste, on la regarde depuis le projet : namespaces, routes, ImageStreams, console web, droits d'une équipe. Depuis la version 4.14, les DeploymentConfig sont dépréciés au profit des Deployment, et beaucoup d'applications anciennes restent à migrer.
Source-to-Image (S2I) et builds
S2I fabrique une image à partir du code source et d'une image de build fournie par Red Hat (OpenJDK, JBoss EAP). C'est la méthode historique d'OpenShift. Les équipes utilisent aussi des Dockerfile multi-étapes, ou les builds Shipwright proposés par Builds for OpenShift.
Security Context Constraints (SCC)
Les règles de sécurité appliquées aux pods. La SCC par défaut, restricted-v2, refuse le root et attribue un UID au hasard. Une image écrite pour tourner en root ou avec un utilisateur fixe ne démarre pas. C'est la première cause de blocage quand une application arrive sur OpenShift.
Helm et Kustomize
Deux façons de décrire une application en manifestes réutilisables. Helm produit des charts paramétrés et versionnés, Kustomize applique des patchs à une base commune. La personne doit savoir choisir, et lire ce qui sera réellement appliqué.
OpenShift Pipelines (Tekton) et Jenkins
OpenShift Pipelines est la CI de Red Hat, basée sur Tekton, qui exécute chaque étape dans un pod. Beaucoup d'entreprises gardent Jenkins à côté, avec des pipelines en Groovy. L'expert applicatif écrit ou corrige ces pipelines avec les équipes.
OpenShift GitOps (Argo CD)
Argo CD empaqueté par Red Hat. Il déploie ce qui est décrit dans Git et signale tout écart avec le cluster. Les questions utiles portent sur les écarts qui reviennent, les secrets et l'ordre des déploiements.
Sondes, ressources et JVM
Readiness, liveness et startup probes, requests et limits, quotas du projet. Pour une application Java, s'ajoute le réglage de la JVM dans un conteneur : part de la mémoire donnée au heap, nombre de processeurs vus, journaux GC. La plupart des incidents applicatifs viennent de ces réglages.
Routes et routeur HAProxy
Une route expose un service vers l'extérieur du cluster, par le routeur HAProxy d'OpenShift. Elle porte la terminaison TLS (edge, passthrough, reencrypt), l'affinité de session et les délais d'attente, réglés par annotations.
Supervision et journaux
La supervision des projets utilisateurs (Prometheus intégré), les journaux centralisés dans Loki ou ELK, et souvent Dynatrace pour suivre les transactions Java. L'expert applicatif doit savoir y chercher la cause d'un incident à la place de l'équipe.
Le poste existe surtout là où une équipe plateforme exploite déjà OpenShift et voit les projets arriver plus vite qu'elle ne peut les aider. Il est souvent tenu en mission longue, avec un rôle de support de niveau 3 et des astreintes ponctuelles. Le niveau attendu varie : certaines équipes cherchent quelqu'un qui écrit les charts et les pipelines à la place des projets, d'autres un profil qui fixe les standards et laisse les projets faire. Une pratique du Java côté serveur (WildFly ou JBoss EAP, Spring Boot, Maven) aide beaucoup, car la majorité des applications à faire entrer sont en Java. Une offre claire précise la CI en place, l'usage ou non d'Argo CD et le nombre d'équipes à accompagner.
Les compétences applicatives à valider sur OpenShift
- Conteneurisation d'applications Java/JEE
- Builds S2I, images et registre
- Packaging Helm, Kustomize et GitOps
- Pipelines Tekton et Jenkins
- Sondes, ressources et JVM en conteneur
- Diagnostic applicatif sur OpenShift
Ce qu'on demande à un expert OpenShift qui accompagne les projets
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Une application JBoss qui tournait sur une VM refuse de démarrer sur OpenShift avec « Permission denied » sur /opt/app/logs. Que se passe-t-il ?
Une bonne réponsePar défaut, la SCC restricted-v2 lance le conteneur avec un UID choisi au hasard dans la plage du projet, et le groupe 0. L'image a été construite pour un utilisateur fixe, propriétaire du dossier. La correction se fait dans l'image : chgrp -R 0 puis chmod g=u sur les dossiers où l'application écrit, les journaux envoyés sur la sortie standard et un emptyDir pour les fichiers temporaires.
Signal d'alerte« On donne la SCC anyuid ou privileged au compte de service » comme première réponse. Ou modifier les droits à la main dans le pod en marche, ce qui disparaît au redémarrage suivant.
Question 2 · confirmé
Un pod Java est tué toutes les deux heures avec le statut OOMKilled, alors que le heap n'est jamais plein. Que regardez-vous ?
Une bonne réponseLa limite mémoire du conteneur couvre toute la JVM, pas seulement le heap : metaspace, piles des threads, buffers directs, code compilé. Il compare la limite avec -Xmx ou MaxRAMPercentage, active le suivi de la mémoire native (Native Memory Tracking) et ajuste, soit en baissant la part du heap, soit en montant la limite. Il vérifie que le JDK lit bien les limites du conteneur.
Signal d'alerte« On augmente -Xmx », ce qui aggrave le problème, ou penser qu'un OOMKilled vient forcément d'une fuite dans le heap.
Question 3 · confirmé
Une équipe a trois environnements et trois copies presque identiques de ses manifestes YAML. Helm ou Kustomize, que lui proposez-vous ?
Une bonne réponseKustomize quand les écarts tiennent en quelques patchs : une base commune et un overlay par environnement. Helm quand le paquet est réutilisé par plusieurs équipes, a beaucoup de paramètres ou doit être versionné et publié. Argo CD sait lire les deux, et on peut combiner un chart Helm avec des patchs Kustomize. Dans tous les cas, les valeurs de chaque environnement vivent dans Git.
Signal d'alerte« Helm, parce que c'est le standard », sans regarder le besoin, ou un chart truffé de conditions que plus personne ne relit.
Question 4 · confirmé
Par la route, une requête renvoie une erreur 504 au bout de 30 secondes, alors qu'en direct sur le pod elle aboutit en 45 secondes. Que se passe-t-il ?
Une bonne réponseLe routeur HAProxy d'OpenShift coupe par défaut une requête après 30 secondes. L'annotation haproxy.router.openshift.io/timeout sur la route allonge ce délai pour un besoin réel. La bonne réponse ajoute qu'un traitement de 45 secondes gagne à devenir asynchrone, et qu'un load balancer placé devant le routeur a souvent son propre délai.
Signal d'alerteAugmenter la mémoire ou le CPU du pod, ou chercher la cause dans le code avant d'avoir regardé la chaîne réseau.
Question 5 · senior
Comment construisez-vous une pipeline Tekton qui construit, teste et pousse l'image de vingt projets sans copier vingt fois le même YAML ?
Une bonne réponseDes Tasks réutilisables et des Pipelines paramétrés (dépôt, chemin, nom d'image), rangés dans un dépôt commun et versionnés. Les projets les appellent par un resolver (git, bundles ou cluster). Un workspace porte les sources et le cache Maven. Le déclenchement vient d'un webhook Git, par un EventListener ou par Pipelines as Code.
Signal d'alerteUn fichier de pipeline copié et modifié à la main dans chaque projet, ou un kubectl apply lancé depuis la pipeline vers la production.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Expert OpenShift applicatif, les questions fréquentes
Expert OpenShift applicatif ou administrateur OpenShift : quelle différence ?
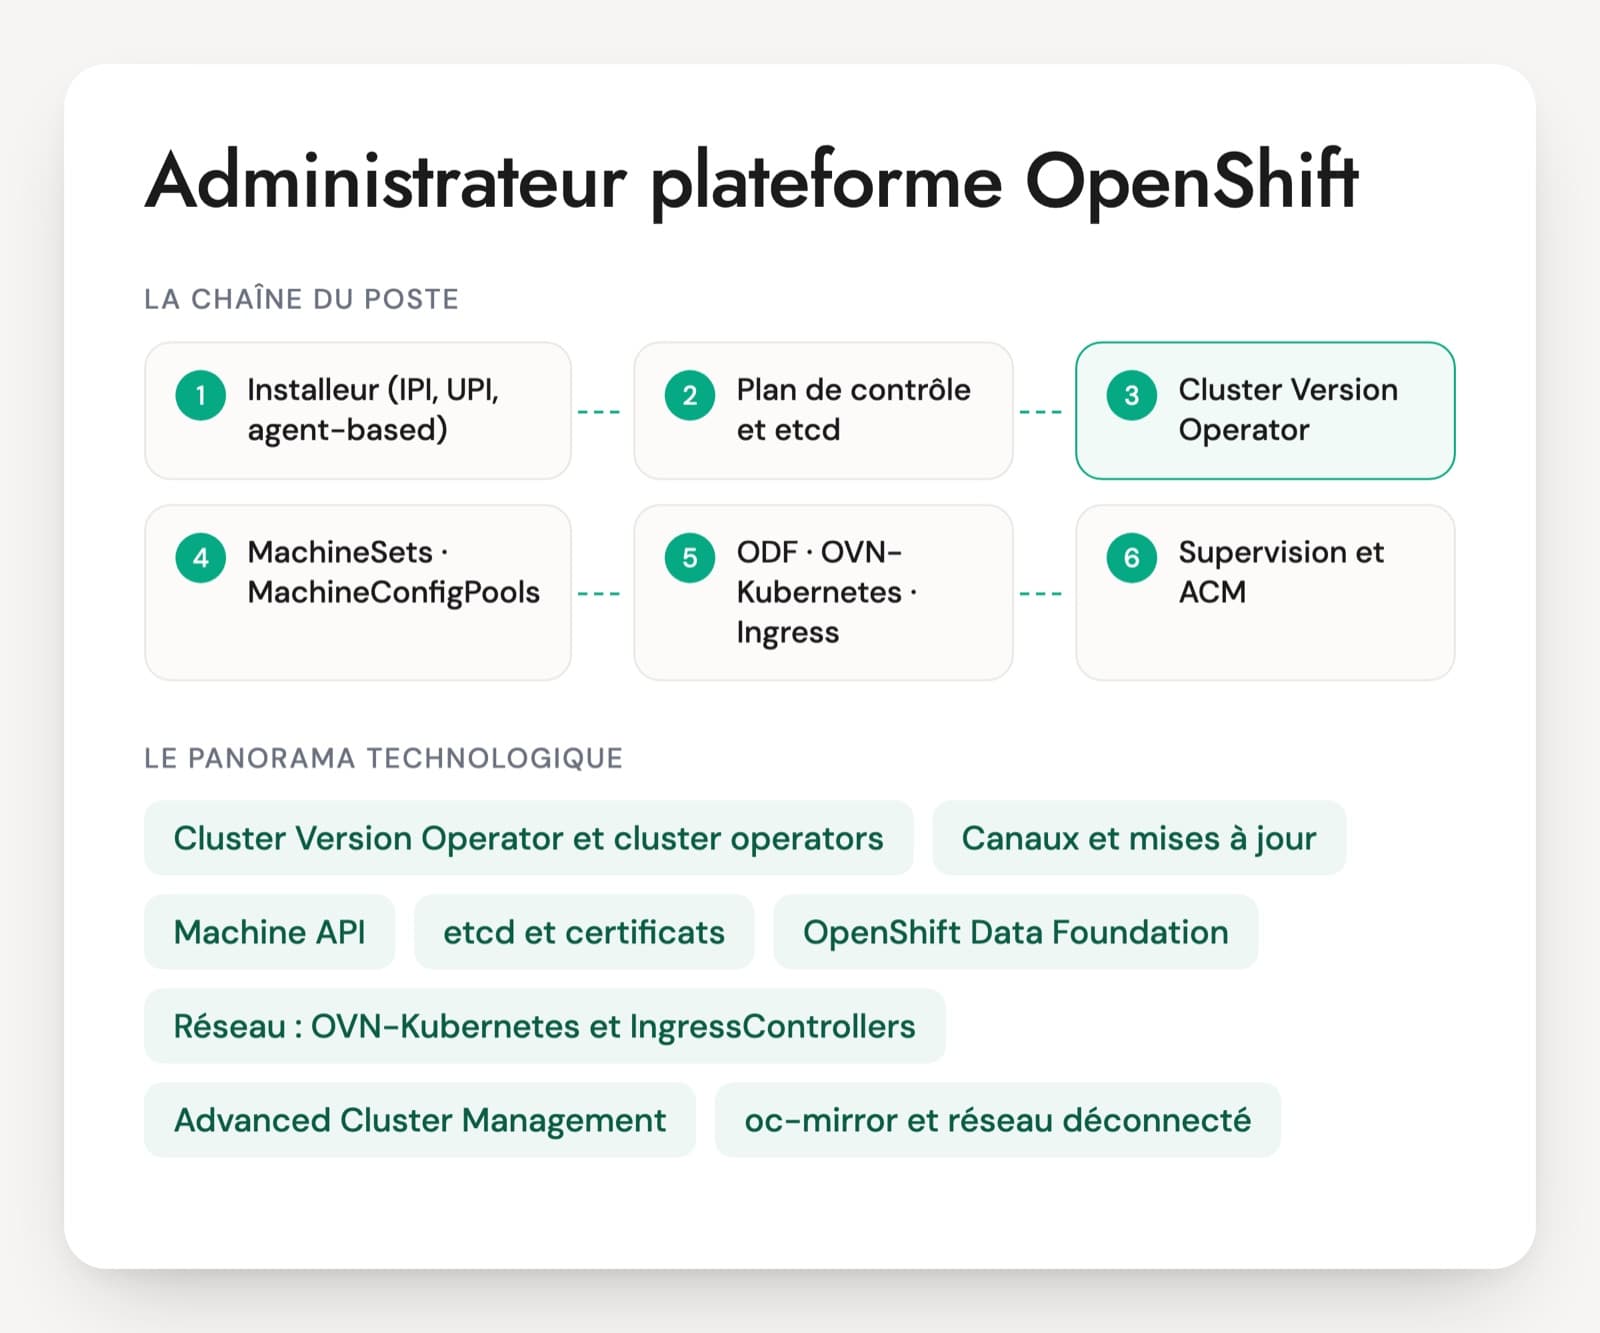
L'administrateur installe et met à jour les clusters, gère les nœuds, le stockage, le réseau et les opérateurs. L'expert applicatif travaille dans les projets : images, charts, pipelines, réglages des pods et diagnostic des applications. Si les équipes de développement attendent des semaines pour mettre une application sur la plateforme, c'est le second profil qui manque. Les deux métiers se recouvrent sur la lecture des événements et des journaux, rarement sur le reste.
Un développeur Java fait-il un bon expert OpenShift applicatif ?
Il part avec un avantage réel, puisqu'il comprend la JVM, Maven et les serveurs d'applications des projets à accompagner. Il lui manque souvent les spécificités d'OpenShift (SCC, routes, quotas), la pratique de Helm ou de Kustomize et le support de production. Il doit avoir déjà diagnostiqué une application dans un cluster et pas seulement poussé du code dans une pipeline écrite par d'autres.
Quelle certification Red Hat regarder sur le CV ?
La certification Red Hat Certified OpenShift Application Developer (examen EX288) correspond le mieux à ce poste, car elle porte sur le déploiement d'applications, les builds et les sondes. La certification d'administrateur (EX280) concerne plutôt l'exploitation du cluster. Les deux sont des examens pratiques, ce qui leur donne du poids. Elles ne remplacent pas l'expérience d'accompagnement, à faire raconter avec des exemples précis.
À quoi ressemble un bon exercice pratique pour ce poste ?
Le support est une petite application Spring Boot avec un Dockerfile qui tourne en root, une sonde mal réglée et une limite mémoire trop basse, que la personne doit faire tourner sur un projet OpenShift de test. En quarante minutes, on voit sa méthode de diagnostic et sa connaissance de la plateforme. Ce test technique en direct en dit plus qu'un questionnaire sur les objets Kubernetes.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.