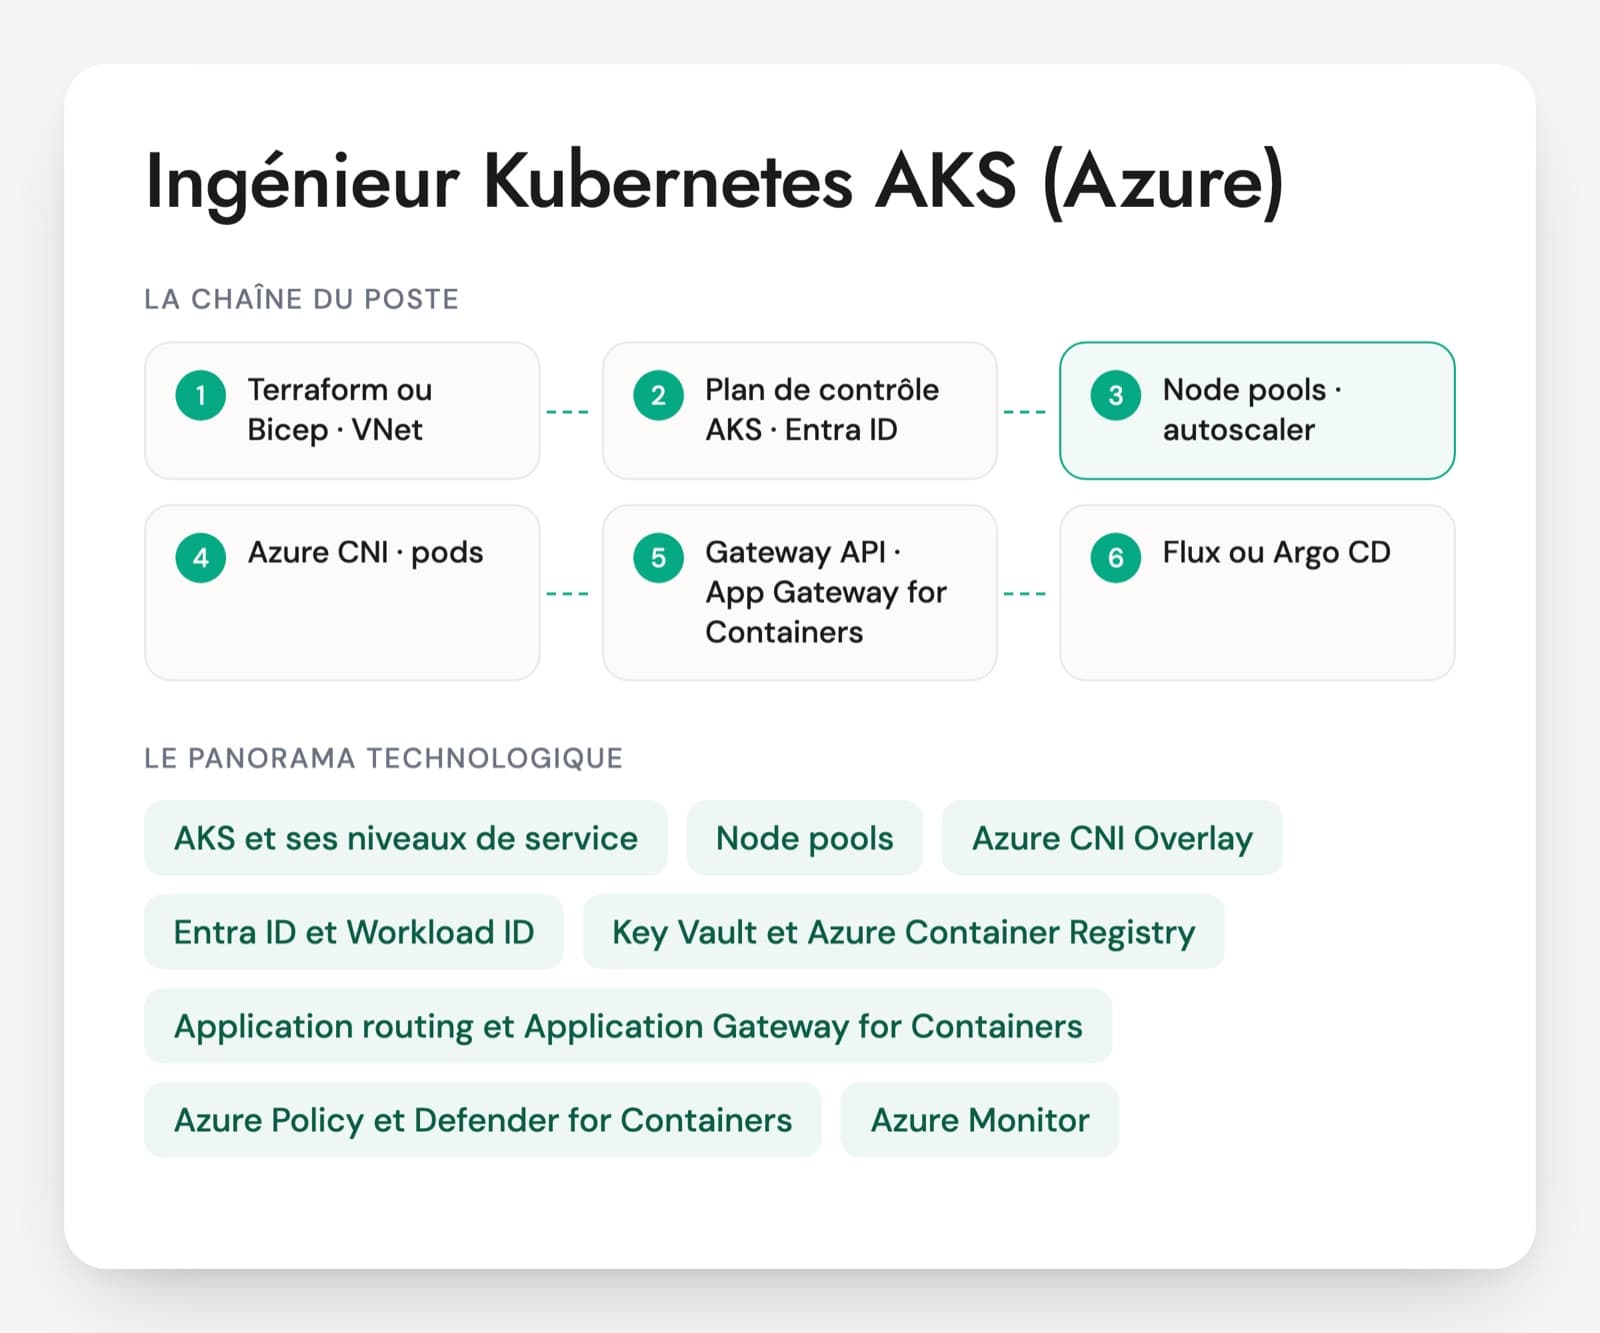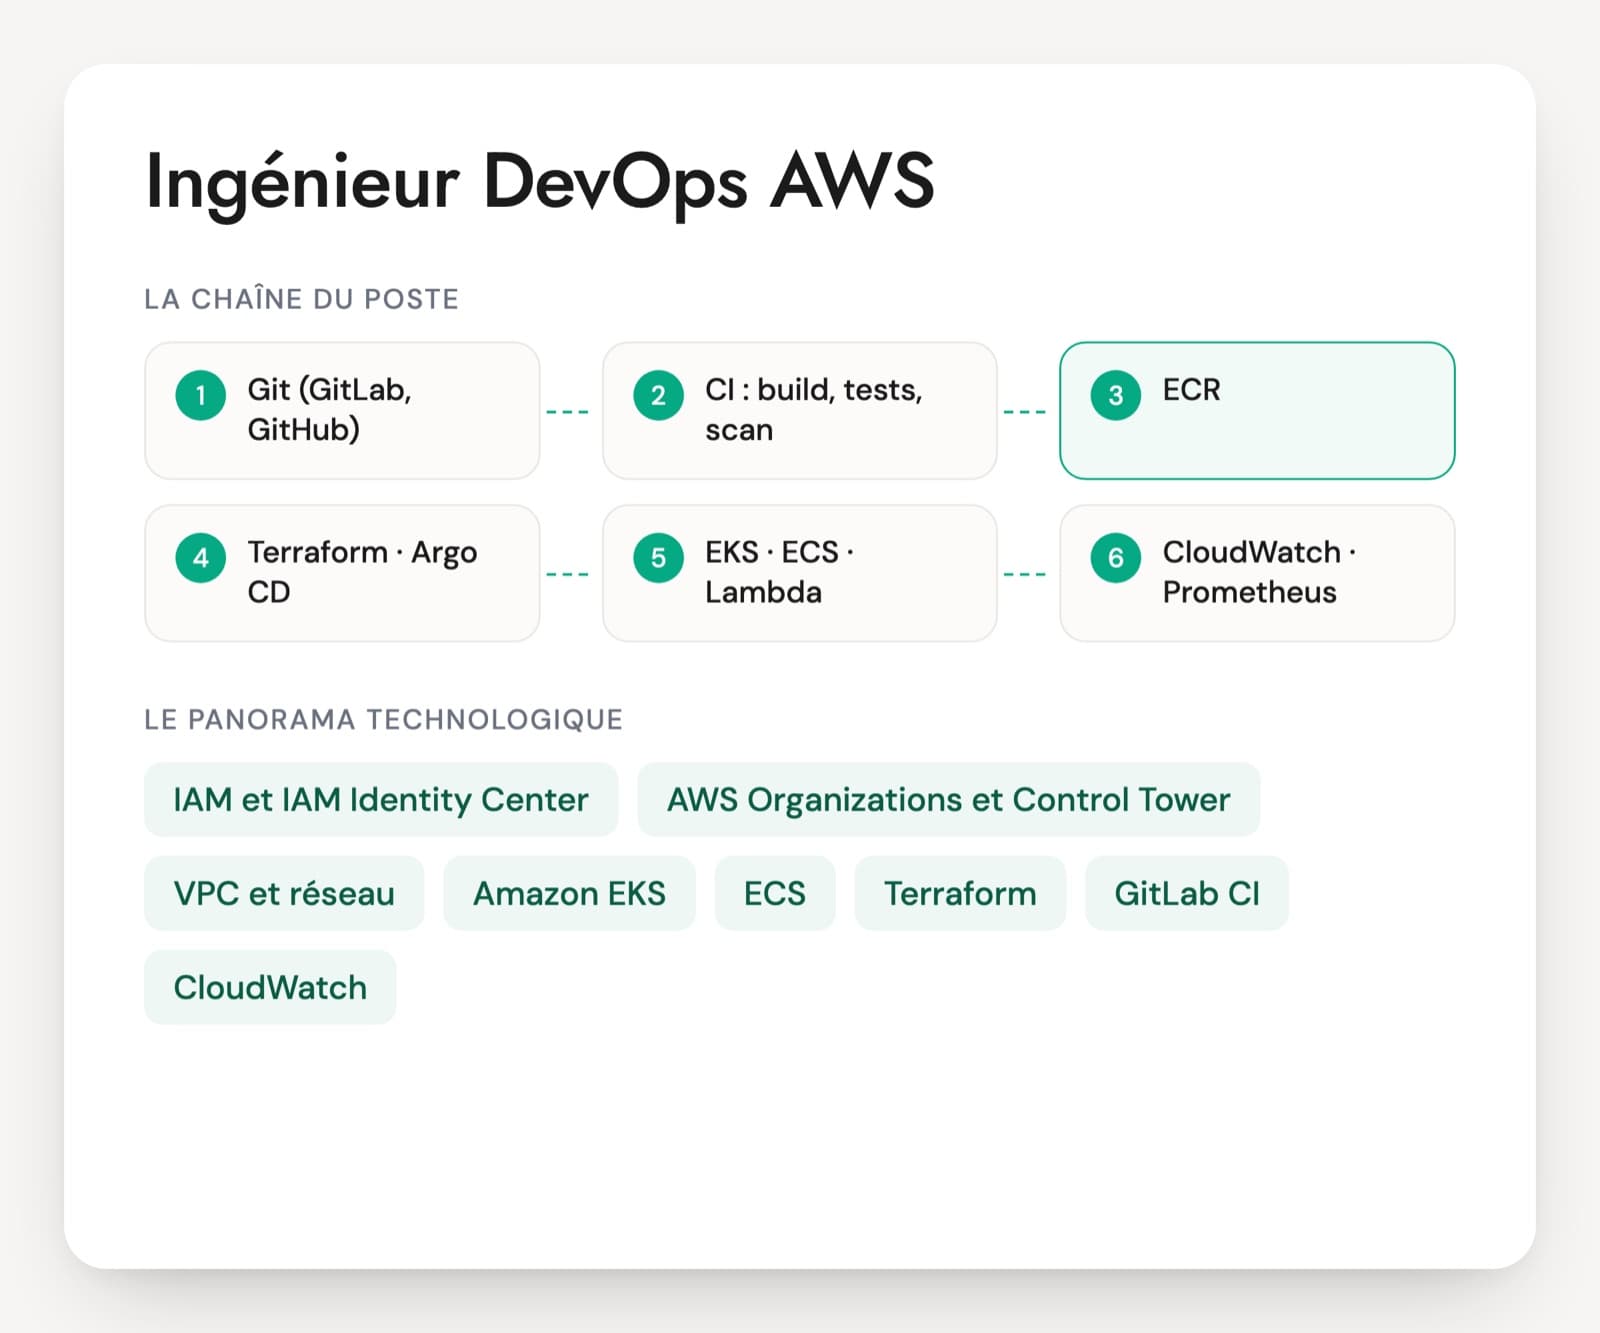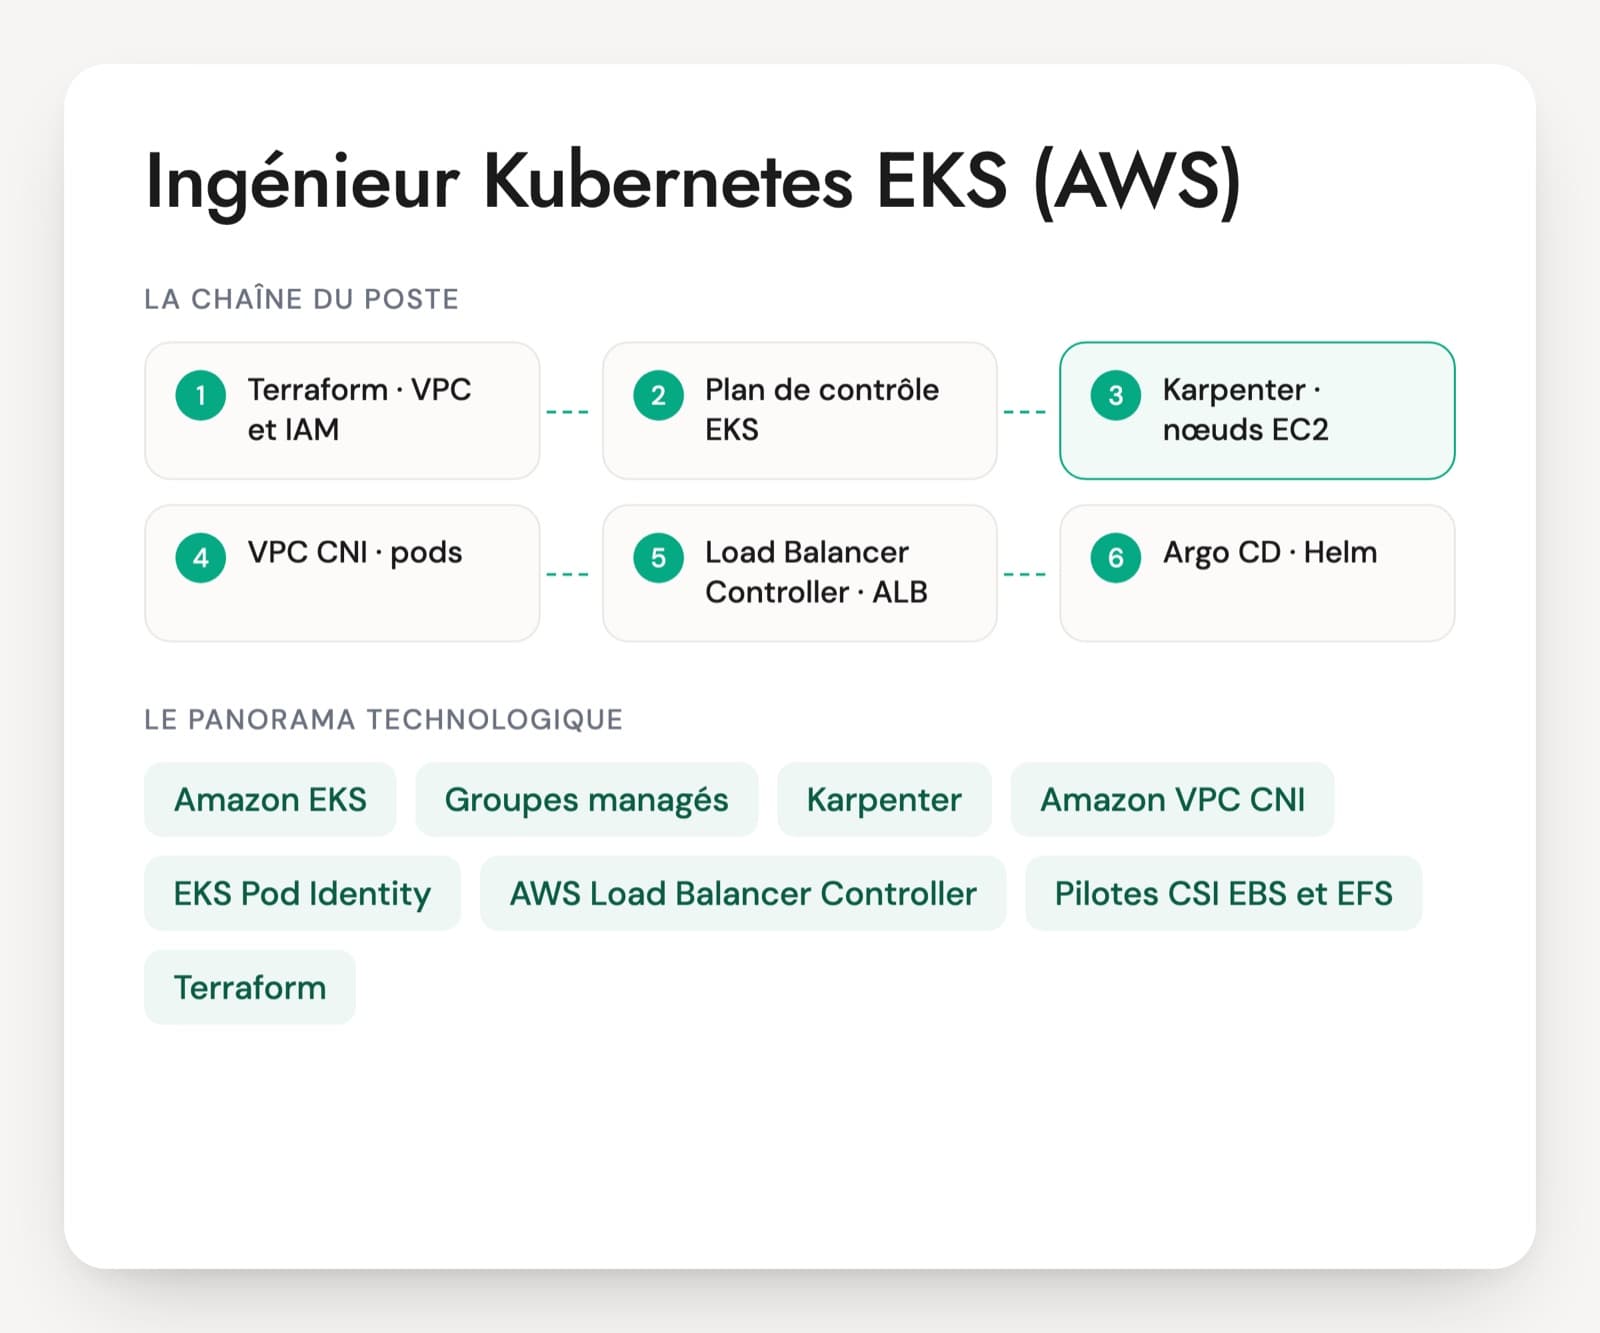
Le poste apparaît sous plusieurs intitulés : ingénieur cloud DevOps AWS, expert Kubernetes, ingénieur plateforme. Le travail reste le même. La personne crée les clusters avec Terraform, choisit entre groupes de nœuds managés, Karpenter, Fargate ou EKS Auto Mode, installe les contrôleurs AWS et déploie les applications avec Helm et Argo CD. Elle gère aussi les montées de version : chaque version reste quatorze mois en support standard, ensuite le support étendu coûte six fois plus cher par cluster.
Les CV se ressemblent. Beaucoup de profils ont déployé des applications sur un EKS que quelqu'un d'autre avait monté. Ceux qui l'ont construit parlent d'adresses IP épuisées dans un sous-réseau, de rôles IAM attribués pod par pod, d'un volume EBS bloqué dans une autre zone de disponibilité ou d'un groupe de nœuds qui refuse de se vider pendant une mise à jour.
La CKA atteste la connaissance de Kubernetes, pas celle d'AWS. Pour un poste de run, le récit d'une montée de version menée de bout en bout est attendu. Pour un poste de construction, l'entretien fait dessiner le réseau du dernier cluster. Le PDF reprend l'entretien complet sur six axes, avec un cas de 20 minutes.
Ce qu'AWS fournit autour d'un cluster EKS
Amazon EKS
AWS héberge l'API server et etcd sur plusieurs zones et facture chaque cluster à l'heure. Une version de Kubernetes reste quatorze mois en support standard, puis douze mois en support étendu, facturé 0,60 dollar de l'heure par cluster au lieu de 0,10. Les nœuds ne se mettent pas à jour avec le plan de contrôle.
Groupes managés, Fargate et EKS Auto Mode
Trois façons d'obtenir des machines. Les groupes managés créent des instances EC2 dans un groupe Auto Scaling. Fargate lance chaque pod sur une capacité isolée, sans DaemonSet ni EKS Pod Identity. EKS Auto Mode confie à AWS les nœuds, Karpenter, le réseau, le stockage EBS et les load balancers, et remplace chaque nœud au plus tard après 21 jours.
Karpenter
Le provisionneur de nœuds open source lancé par AWS. Il lit les pods en attente, lance l'instance EC2 qui leur convient, Spot ou à la demande, puis regroupe les pods pour éteindre les machines peu remplies. Il se configure avec des NodePools et des EC2NodeClass. La personne doit savoir limiter les interruptions qu'il provoque.
Amazon VPC CNI
Le plugin réseau par défaut. Chaque pod reçoit une adresse IP du VPC, ce qui simplifie le routage et vide vite les sous-réseaux. La délégation de préfixes, un CIDR secondaire en 100.64.0.0/10 ou l'IPv6 répondent au manque d'adresses. Le nombre de pods par nœud dépend du type d'instance.
EKS Pod Identity, IRSA et access entries
Deux mécanismes donnent un rôle IAM à un pod. IRSA passe par un fournisseur OIDC propre à chaque cluster, EKS Pod Identity par un agent sur les nœuds et une association déclarée dans l'API EKS. Pour l'accès des personnes et des pipelines au cluster, les access entries remplacent la ConfigMap aws-auth.
AWS Load Balancer Controller
Le contrôleur qui crée un Application Load Balancer pour un Ingress et un Network Load Balancer pour un Service. En mode ip, le trafic va directement aux pods. Depuis la fin de la maintenance d'ingress-nginx en mars 2026, il revient dans beaucoup de projets de remplacement, à côté des implémentations de Gateway API.
Pilotes CSI EBS et EFS
Les volumes persistants. Un volume EBS appartient à une seule zone de disponibilité et ne s'attache qu'à un nœud à la fois. EFS se partage entre pods et entre zones, avec une latence plus élevée. Le choix de la StorageClass se fait à cet endroit.
Terraform, Helm et Argo CD
Le VPC, le cluster et les rôles IAM se décrivent en Terraform, souvent avec le module communautaire EKS. Les add-ons et les applications s'installent avec Helm, et Argo CD ou Flux aligne le cluster sur le contenu d'un dépôt Git.
CloudWatch, Prometheus et sécurité
Les journaux du plan de contrôle partent dans CloudWatch si on les active. Les métriques passent par Container Insights ou par Prometheus et Grafana. Inspector analyse les images stockées dans ECR, GuardDuty surveille les comportements suspects dans le cluster.
Les offres EKS citent presque toujours AWS, Terraform, Argo CD, GitLab CI, Docker et un peu de Python. Le contenu varie selon la taille de la plateforme. Sur un cluster partagé par plusieurs équipes, avec des dizaines de namespaces, on attend de la rigueur sur les montées de version, les quotas et les droits. Sur un ou deux clusters dédiés à un produit, on attend une vision complète, du VPC jusqu'au pipeline de déploiement. Les certifications demandées sont la CKA et AWS Solutions Architect Associate. Aucune ne prouve qu'un cluster a été tenu en production.
Ce qu'un ingénieur EKS doit savoir faire seul
- Réseau VPC CNI et accès au cluster
- Identité IAM des pods et des équipes
- Nœuds, Karpenter et maîtrise des coûts
- Montées de version et add-ons
- Stockage persistant et sauvegarde
- Exposition, sécurité et dépannage
Cinq pannes et choix d'architecture EKS à faire expliquer
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Des pods restent en ContainerCreating avec l'erreur « failed to assign an IP address to container ». Le sous-réseau est presque plein. Que faites-vous tout de suite, puis durablement ?
Une bonne réponseIl commence par le diagnostic : adresses libres de chaque sous-réseau, journaux de l'ipamd du VPC CNI, réserve d'adresses gardée par chaque nœud (par défaut une ENI entière). Tout de suite, il règle WARM_IP_TARGET et MINIMUM_IP_TARGET ou ajoute un sous-réseau. Durablement, il active la délégation de préfixes pour loger plus de pods par nœud, ajoute un CIDR secondaire en 100.64.0.0/10 (custom networking ou découverte de sous-réseaux) ou part sur IPv6 pour un nouveau cluster. Un profil solide rappelle que load balancers et bases du VPC consomment aussi des adresses.
Signal d'alerteVouloir agrandir le sous-réseau existant, ce qu'AWS ne permet pas, ou passer à des instances plus grandes sans voir que le manque vient du sous-réseau. Aucune idée de la façon dont le CNI réserve les adresses.
Question 2 · confirmé
Une application doit lire un bucket S3 depuis EKS. Comment lui donnez-vous ce droit, et que refusez-vous de faire ?
Une bonne réponseUn rôle IAM limité à ce bucket et à ces actions, rattaché au compte de service Kubernetes de l'application. Avec EKS Pod Identity, il installe l'agent sur les nœuds, crée l'association dans l'API EKS et fait confiance à pods.eks.amazonaws.com. Avec IRSA, il passe par le fournisseur OIDC du cluster et une annotation sur le compte de service. Il refuse de donner le droit au rôle des nœuds, partagé par tous les pods du nœud, et de ranger des clés d'accès dans un Secret. Il bloque aussi l'accès des pods aux métadonnées de l'instance (IMDSv2 avec une limite de saut à 1).
Signal d'alerteAjouter s3:* au rôle des nœuds, ou créer un utilisateur IAM et passer ses clés en variables d'environnement.
Question 3 · confirmé
Depuis l'arrivée de Karpenter, la facture EC2 a baissé, mais les équipes voient des pods redémarrer en pleine journée. Que se passe-t-il, et que réglez-vous ?
Une bonne réponseLa consolidation de Karpenter supprime ou remplace des nœuds pour réduire le coût, et AWS peut reprendre une instance Spot avec deux minutes de préavis. Il pose des PodDisruptionBudgets sur les applications, des budgets de disruption sur le NodePool (nombre de nœuds, créneaux horaires), l'annotation karpenter.sh/do-not-disrupt sur les pods qui ne doivent pas bouger et un NodePool à la demande pour les charges sensibles. Côté applications, il exige plusieurs réplicas répartis sur les zones et un arrêt propre sur SIGTERM.
Signal d'alerteCouper la consolidation sur tout le cluster, ou ne parler que de Spot sans connaître les budgets de disruption.
Question 4 · confirmé
Votre cluster EKS sort du support standard dans six semaines. Comment préparez-vous la montée de version ?
Une bonne réponseIl lit les changements de la version cible et cherche les API supprimées (cluster insights d'EKS, kubent ou pluto sur les manifestes et les charts). Il vérifie la compatibilité des add-ons : VPC CNI, CoreDNS, kube-proxy, Load Balancer Controller, pilotes CSI. Il passe d'abord le cluster hors production. Le plan de contrôle monte d'une version mineure à la fois, puis viennent les add-ons, puis les nœuds, par un nouveau groupe managé ou par la dérive des nœuds Karpenter vers la nouvelle AMI. Il sait que sans action, le cluster bascule en support étendu, six fois plus cher, avant une mise à jour imposée.
Signal d'alerteCliquer sur « Mettre à jour » dans la console pour voir ce qui casse, ou vouloir sauter deux versions mineures d'un coup.
Question 5 · confirmé
Après le remplacement d'un nœud, un pod de StatefulSet reste en Pending avec « volume node affinity conflict ». Pourquoi ?
Une bonne réponseUn volume EBS n'existe que dans une zone de disponibilité. Le pod ne peut démarrer que sur un nœud de cette zone, et il n'y en a plus, ou plus avec la place nécessaire. Correctifs : une StorageClass en WaitForFirstConsumer, des nœuds possibles dans chaque zone (NodePool Karpenter multi-zones ou un groupe managé par zone), et pour des données partagées entre zones, EFS ou une réplication applicative. Les bons profils parlent aussi des snapshots EBS et de Velero.
Signal d'alerteSupprimer le PVC pour que le pod redémarre, ce qui fait perdre les données. Ou ignorer que les volumes EBS sont liés à une zone.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
EKS : les doutes fréquents avant l'entretien
La CKA et une certification AWS se complètent-elles pour un poste EKS ?
Oui, sans suffire. La CKA vérifie l'administration de Kubernetes en ligne de commande, sur des clusters génériques. AWS Solutions Architect Associate atteste une connaissance générale d'AWS : VPC, IAM, EC2. Aucune des deux ne couvre le VPC CNI, Karpenter ou une montée de version EKS. Sur un CV junior, elles servent de filtre. Pour un profil confirmé, un cluster tenu en production compte plus, et l'entretien technique sert à le vérifier.
Un ingénieur Kubernetes AKS ou GKE peut-il prendre un poste EKS ?
Kubernetes reste le même, et une bonne partie de l'entretien se transpose. L'écart porte sur le réseau, l'identité et les nœuds : sur EKS, chaque pod consomme une adresse du VPC, les droits passent par IAM et l'équipe gère plus de composants elle-même. Un profil solide s'adapte en quelques semaines. Les questions d'IAM et de réseau restent posées telles quelles : un bon candidat raisonnera juste, même s'il ne connaît pas le nom exact des options.
Un test technique à faire chez soi a-t-il du sens pour un poste EKS ?
Rarement. Monter un cluster chez soi prend du temps et coûte de l'argent au candidat. Un exercice en direct marche mieux : relire un module Terraform et des manifestes où l'on a glissé des erreurs (rôle IAM trop large, StorageClass gp2, aucun PodDisruptionBudget), ou diagnostiquer un incident à partir d'événements kubectl et de journaux. La personne commente à voix haute, et ses réflexes se voient sans dépendre d'un compte AWS.
EKS Auto Mode change-t-il le profil recherché ?
En partie. Avec Auto Mode, AWS gère les nœuds, Karpenter, le réseau des pods, le stockage EBS et les load balancers. Le poste se déplace vers la conception du VPC, les droits IAM, les NodePools personnalisés, les coûts et l'accompagnement des équipes. Le dépannage reste nécessaire, car un pod qui ne démarre pas reste à diagnostiquer. L'offre précise si les clusters sont en Auto Mode : les questions d'entretien ne sont pas les mêmes.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.