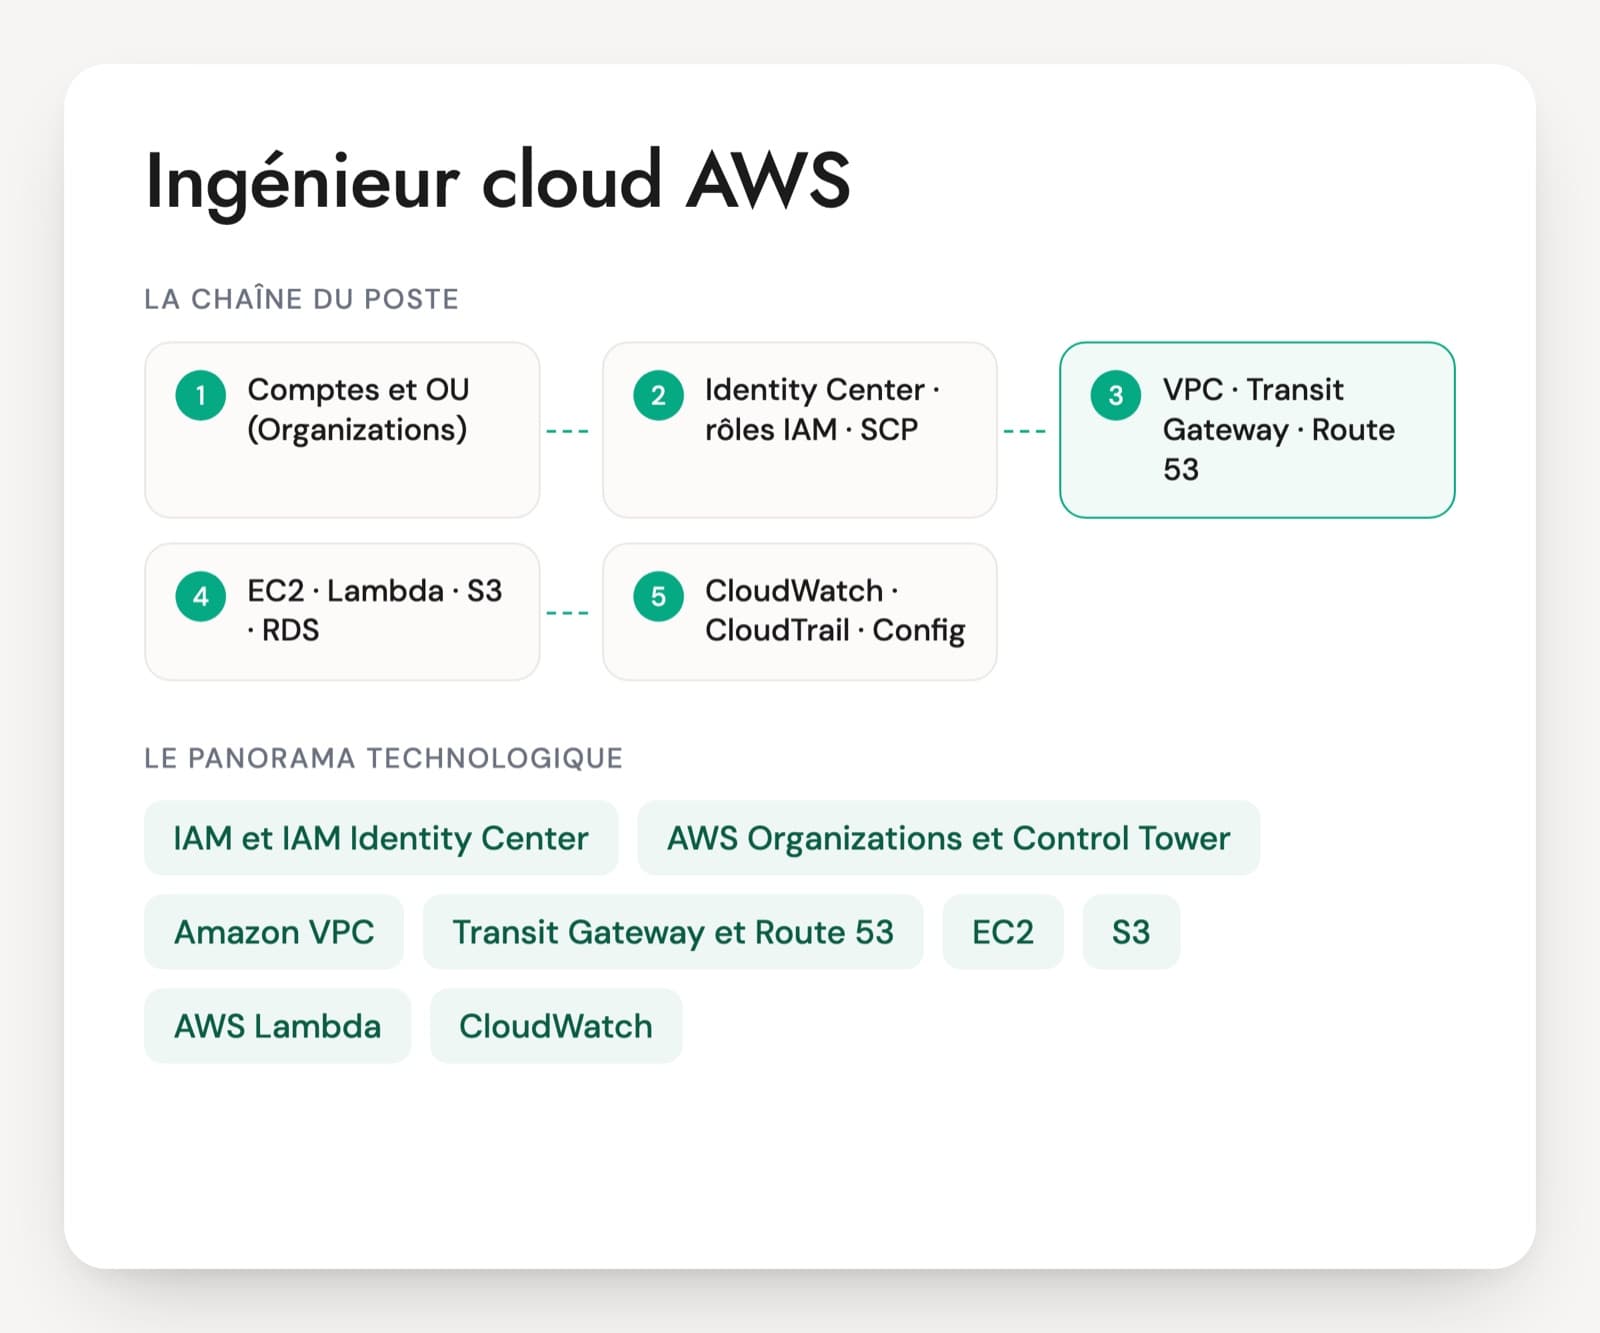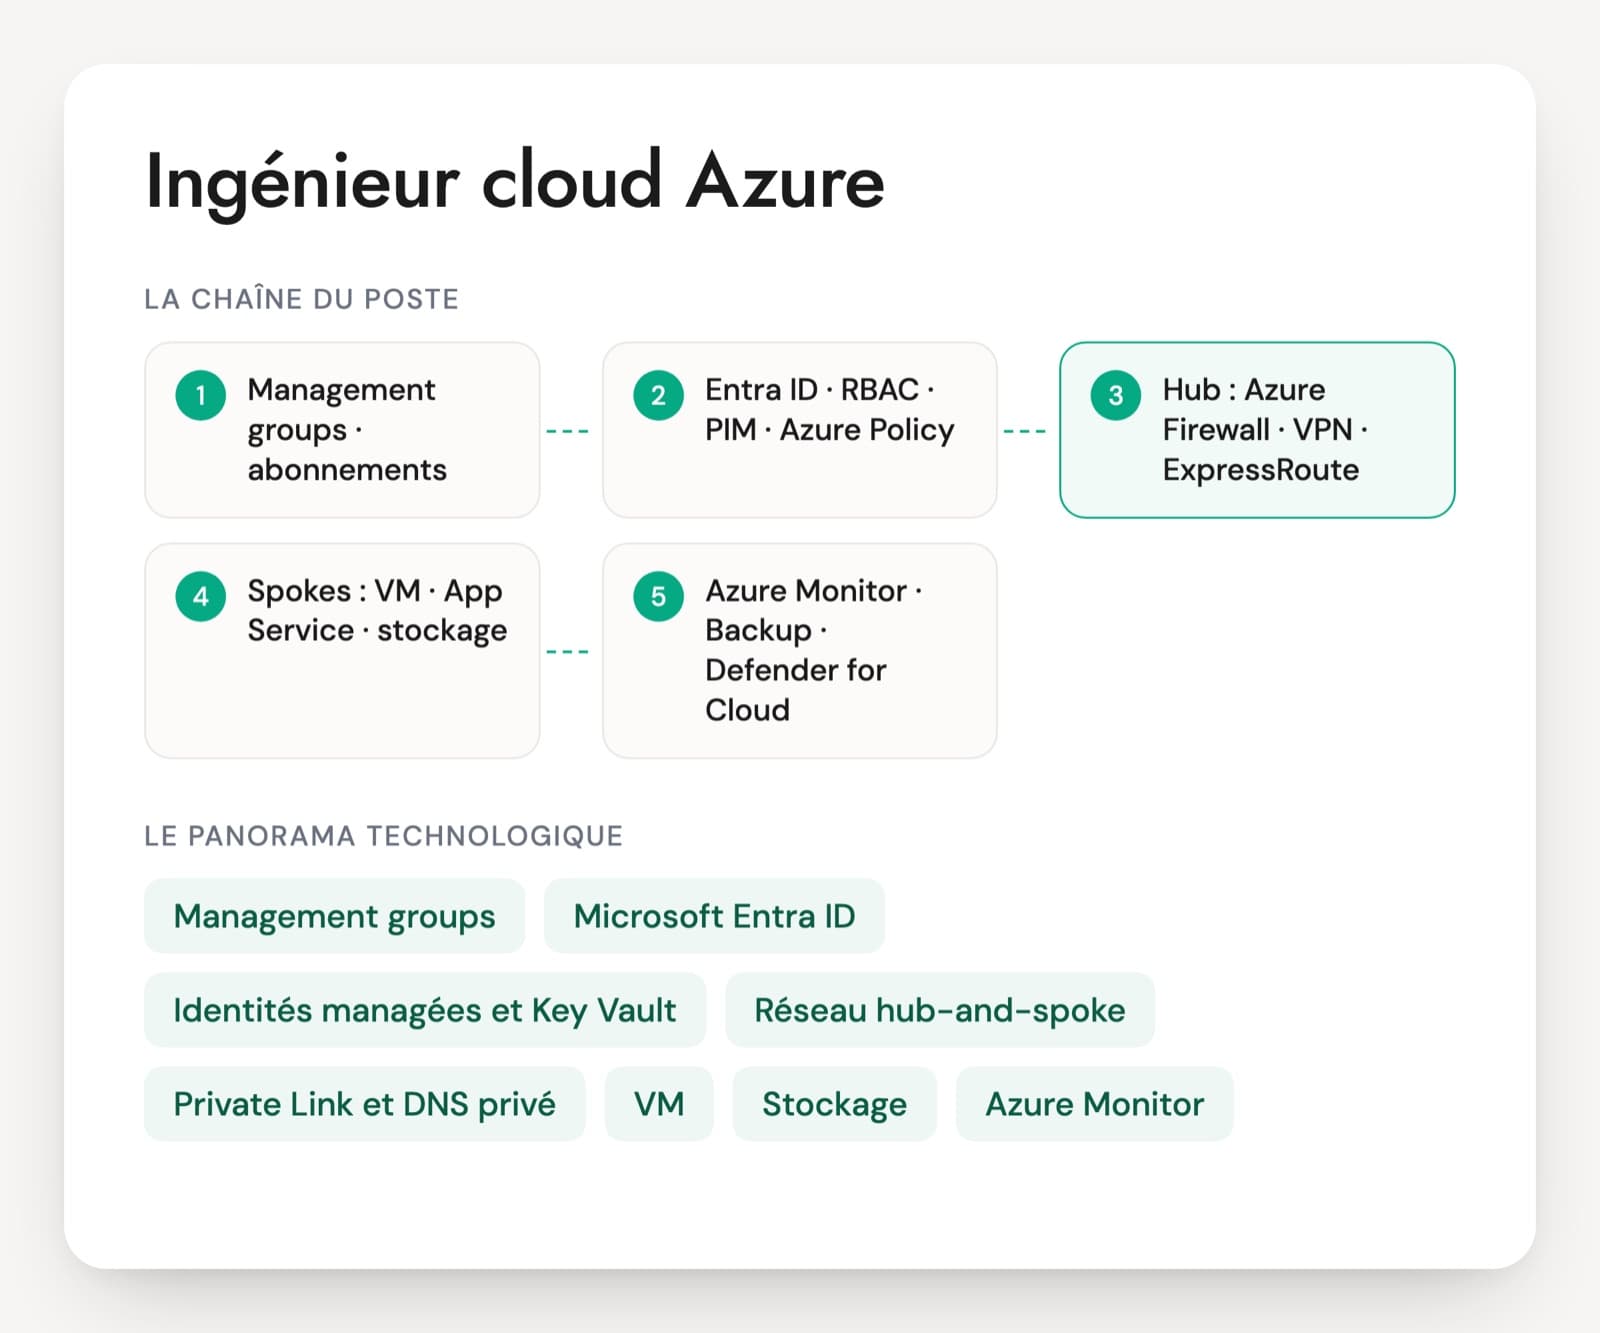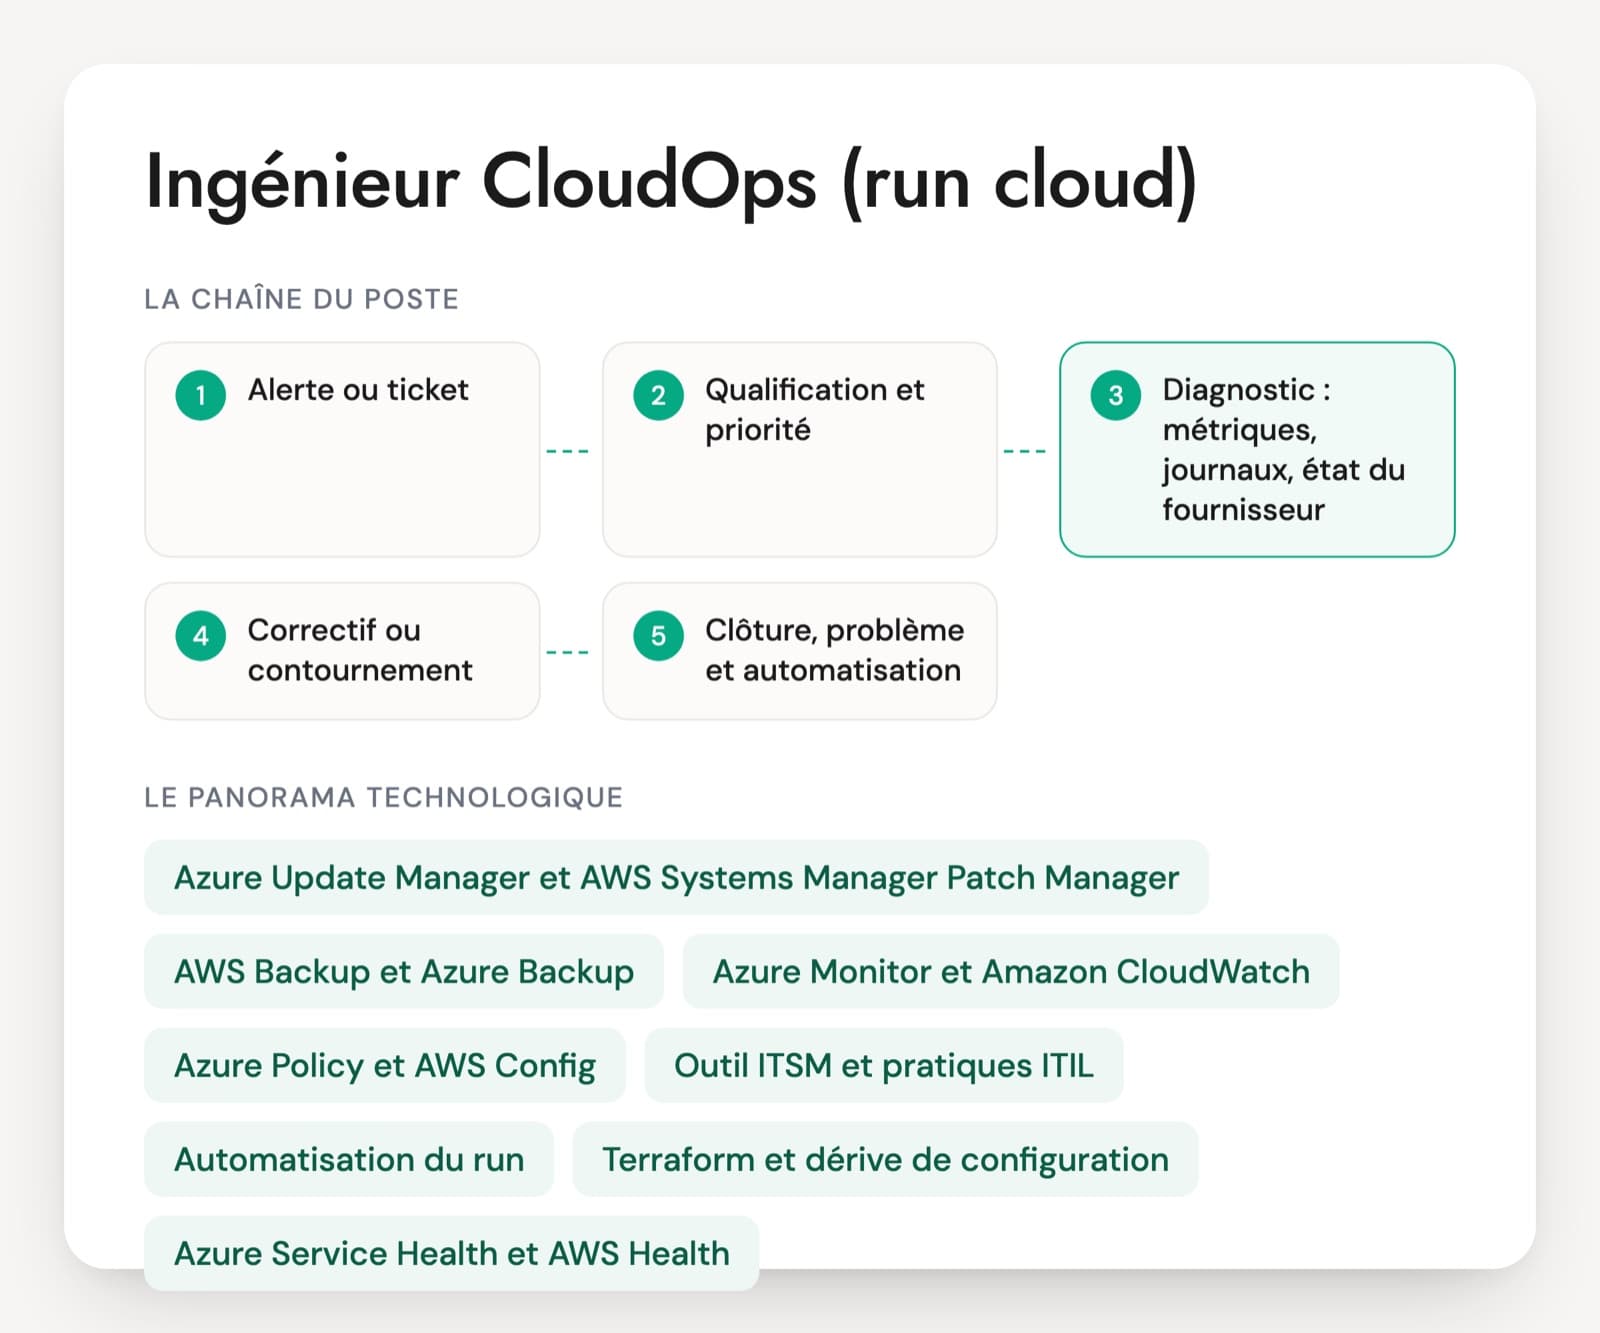
Un ingénieur CloudOps, ou cloud ops, tient le run des environnements cloud : MCO, traitement des incidents et des demandes, support N3 selon ITIL, de sécurité opérationnelle avec CloudTrail, Config ou Azure Policy, et d'automatisation en PowerShell, Python ou Terraform. Le parc est souvent mixte : machines Windows et Linux, clusters Kubernetes, parfois deux clouds.
Le titre recouvre des profils très différents. Un administrateur système passé au cloud connaît bien les serveurs, mais automatise peu. Un DevOps venu du build sait écrire des pipelines, mais n'a parfois jamais restauré une base ni tenu une astreinte. Les deux mettent CloudOps sur leur CV.
Le signal le plus fiable reste le récit d'une opération réelle : une campagne de patch qui a cassé une application, une restauration chronométrée, un incident de nuit avec sa cause. Comptent les commandes, les outils et l'ordre des gestes. Un profil d'exploitation répond avec des détails ; un profil théorique répond avec des principes. Le PDF ajoute un cas de reprise de run de 20 minutes.
Les outils du run cloud au quotidien
Azure Update Manager et AWS Systems Manager Patch Manager
Les deux outils de patching des VM. Update Manager a remplacé la gestion des mises à jour d'Azure Automation, retirée en août 2024, et couvre aussi les serveurs reliés par Azure Arc. Patch Manager s'appuie sur des baselines qui approuvent les correctifs et sur des patch policies qui couvrent plusieurs comptes et régions. Le candidat doit savoir organiser des vagues et lire un rapport de conformité.
AWS Backup et Azure Backup
Les services de sauvegarde gérés, avec des coffres, des politiques de fréquence et de rétention, et des options pour protéger les sauvegardes contre la suppression : Vault Lock côté AWS, coffre immuable et suppression douce côté Azure. Ce qui compte en exploitation, c'est la restauration testée, pas la sauvegarde configurée.
Azure Monitor et Amazon CloudWatch
Métriques, journaux et alertes. Sur Azure, l'Azure Monitor Agent et les règles de collecte ont remplacé l'agent Log Analytics, retiré en août 2024, et les journaux s'interrogent en KQL. Sur AWS, l'agent CloudWatch remonte mémoire et disque, et Logs Insights sert aux recherches. La qualité des alertes décide de la vie de l'astreinte.
Azure Policy et AWS Config
La conformité du parc : règles évaluées en continu et remédiation des écarts. Sur Azure, les effets deployIfNotExists et modify corrigent les ressources par des tâches de remédiation, avec une identité managée. Sur AWS, une règle Config déclenche une automatisation SSM. Defender for Cloud et Security Hub ajoutent la vue sécurité.
Outil ITSM et pratiques ITIL
ServiceNow, Jira Service Management ou un équivalent, pour les incidents, les demandes, les problèmes et les changements. ITIL 4 parle de change enablement, avec des changements standard, normaux et urgents. Les missions de run en grand compte l'exigent souvent, avec des niveaux de support N2 et N3.
Automatisation du run
Runbooks SSM Automation et Azure Automation, scripts PowerShell, Bash ou Python, Ansible pour la configuration des serveurs. L'objectif est de supprimer les tâches répétitives sans créer de risque : scripts idempotents, droits limités, traces d'exécution.
Terraform et dérive de configuration
Même en run, l'infrastructure est souvent décrite en Terraform. Une correction faite en urgence dans la console crée un écart avec le code, que le prochain plan signale. Un bon profil de run sait lire un plan et reporter ses corrections dans le code.
Azure Service Health et AWS Health
L'état des services du fournisseur et les événements propres au compte : maintenances prévues, incidents régionaux, retraits de services annoncés. C'est le premier endroit à regarder quand plusieurs ressources tombent en même temps.
Le poste d'ingénieur CloudOps porte sur l'exploitation d'un parc existant : maintien en conditions opérationnelles, incidents, patching, sauvegardes, conformité et changements. Les annonces françaises citent Azure ou AWS, souvent les deux, ITIL pour les incidents et les changements, Terraform, PowerShell ou Python, et parfois une astreinte. Le titre se confond avec ingénieur cloud ops, run cloud ou SysOps. Les certifications AWS CloudOps Engineer Associate (l'ancienne SysOps Administrator) ou Azure Administrator (AZ-104) attestent la connaissance des services. La pratique du run, avec ses restaurations et ses incidents, se vérifie en entretien.
Les gestes d'exploitation à vérifier chez un ingénieur CloudOps
- Patching et cycle de vie des systèmes
- Sauvegarde et restauration testée
- Diagnostic d'incident
- Conformité et remédiation
- Gestion des changements ITIL
- Supervision et automatisation du run
Questions de run pour un ingénieur CloudOps
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Vous reprenez 400 VM Windows et Linux réparties entre Azure et AWS, sans politique de patch. Comment organisez-vous le patching mensuel ?
Une bonne réponseD'abord un inventaire et une évaluation des correctifs manquants, avec l'évaluation périodique d'Azure Update Manager et un Scan de Patch Manager côté AWS. Puis des groupes par environnement et par criticité, des vagues (développement, recette, production), des fenêtres de maintenance et des baselines qui approuvent les correctifs après quelques jours. Les machines d'un même service passent l'une après l'autre. Des scripts avant et après le patch vérifient l'application. Un rapport de conformité sort après chaque campagne, et les exceptions sont écrites.
Signal d'alerteTout le parc la même nuit, ou des mises à jour automatiques sans fenêtre ni ordre de passage. Ou « on patche quand une faille est dans la presse ».
Question 2 · confirmé
On vous demande de prouver que la base d'une application peut être restaurée. Que faites-vous concrètement ?
Une bonne réponseUne restauration réelle dans un environnement isolé, à partir du coffre de sauvegarde. La personne mesure le temps total et le compare au RTO, vérifie que le point restauré respecte le RPO, puis contrôle que l'application démarre et que les données sont cohérentes. Elle vérifie aussi l'accès aux clés de chiffrement et aux secrets. La procédure est écrite et rejouée à intervalle régulier.
Signal d'alerte« Les jobs de sauvegarde sont verts. » Une sauvegarde jamais restaurée ne prouve rien.
Question 3 · confirmé
Alerte à 3 h du matin : une VM de production ne répond plus. Que faites-vous dans les dix premières minutes ?
Une bonne réponseMesurer l'impact (sondes externes, application), regarder Azure Service Health ou AWS Health pour écarter un incident du fournisseur, puis l'état de la VM : status checks sur EC2, Resource Health et diagnostics de démarrage sur Azure, console série. Ensuite les métriques (processeur, mémoire, disque plein) et le dernier changement, patch ou déploiement. Le ticket est ouvert en priorité haute dès le début. Si un redémarrage s'impose, la personne capture d'abord ce qui servira à l'analyse.
Signal d'alerteRedémarrer tout de suite sans rien regarder ni rien noter, puis fermer l'incident sans cause.
Question 4 · confirmé
Azure Policy signale 300 comptes de stockage non conformes, avec l'accès public anonyme aux blobs autorisé. Comment corrigez-vous ?
Une bonne réponseD'abord savoir quelles applications utilisent vraiment l'accès anonyme. Puis une politique avec l'effet modify, ou une politique intégrée qui désactive l'accès public, et une tâche de remédiation exécutée en vagues avec une identité managée qui n'a que le rôle nécessaire. Les exceptions justifiées passent en exemption datée. Pour les nouveaux comptes, un effet deny. Côté AWS, l'équivalent passe par une règle AWS Config avec remédiation par SSM Automation et le blocage de l'accès public S3 au niveau du compte.
Signal d'alerteCorriger à la main dans le portail, ou passer tout de suite en deny et découvrir les applications cassées le lendemain.
Question 5 · junior à confirmé
Il faut agrandir un disque de production. Changement standard, normal ou urgent ? Et qu'est-ce qui accompagne l'opération ?
Une bonne réponseUn changement standard si une procédure validée existe et que le risque est connu, sinon un changement normal évalué par l'autorité de changement. L'urgence est réservée à un incident en cours. Avant : un snapshot. Pendant : l'agrandissement à chaud quand le service le permet (Elastic Volumes sur EBS, disques managés Azure selon les cas), puis l'extension de la partition et du système de fichiers. Après : vérification et clôture du ticket.
Signal d'alerte« C'est juste un disque », sans ticket, sans snapshot, ou en oubliant d'étendre le système de fichiers.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Questions fréquentes sur le poste d'ingénieur CloudOps
CloudOps, DevOps, SRE : comment distinguer les trois postes ?
Le CloudOps exploite l'infrastructure existante : correctifs, sauvegardes, incidents, conformité. Le DevOps outille la livraison du code, avec les pipelines, les conteneurs et l'infrastructure as code. Le SRE fixe des objectifs de fiabilité mesurés et réduit le travail manuel par l'ingénierie logicielle. Les frontières varient d'une équipe à l'autre. Les missions de l'offre comptent plus que le titre, et les questions suivent le travail réel.
Sur quelles compétences bâtir l'offre d'ingénieur CloudOps ?
Le socle : administration Windows et Linux, réseau de base, un cloud maîtrisé (Azure ou AWS), patching, sauvegarde et restauration, supervision et lecture de journaux. Ensuite viennent l'automatisation en PowerShell, Bash ou Python, Terraform, la conformité avec Azure Policy ou AWS Config et la gestion des changements. Pour un poste avec astreinte, la capacité à diagnostiquer seul en pleine nuit compte autant que la liste des outils.
Une certification ITIL est-elle nécessaire pour ce poste ?
Elle n'est pas nécessaire, mais beaucoup de missions de run en grand compte suivent ITIL et la demandent. ITIL 4 Foundation montre que la personne connaît le vocabulaire : incident, problème, changement standard ou normal. La pratique compte davantage. Reste à savoir comment elle a classé un changement, rédigé un retour arrière ou transformé des incidents répétés en problème corrigé.
Quel exercice proposer pendant l'entretien ?
Un incident simulé fonctionne bien : des métriques, un extrait de journal, une alerte, et vingt minutes pour expliquer les gestes dans l'ordre. L'entretien peut aussi comporter une requête KQL simple ou la lecture d'un rapport de conformité de patch. Ce format remplace avantageusement un test technique à faire chez soi, car il montre la méthode de diagnostic et la façon de prioriser.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.