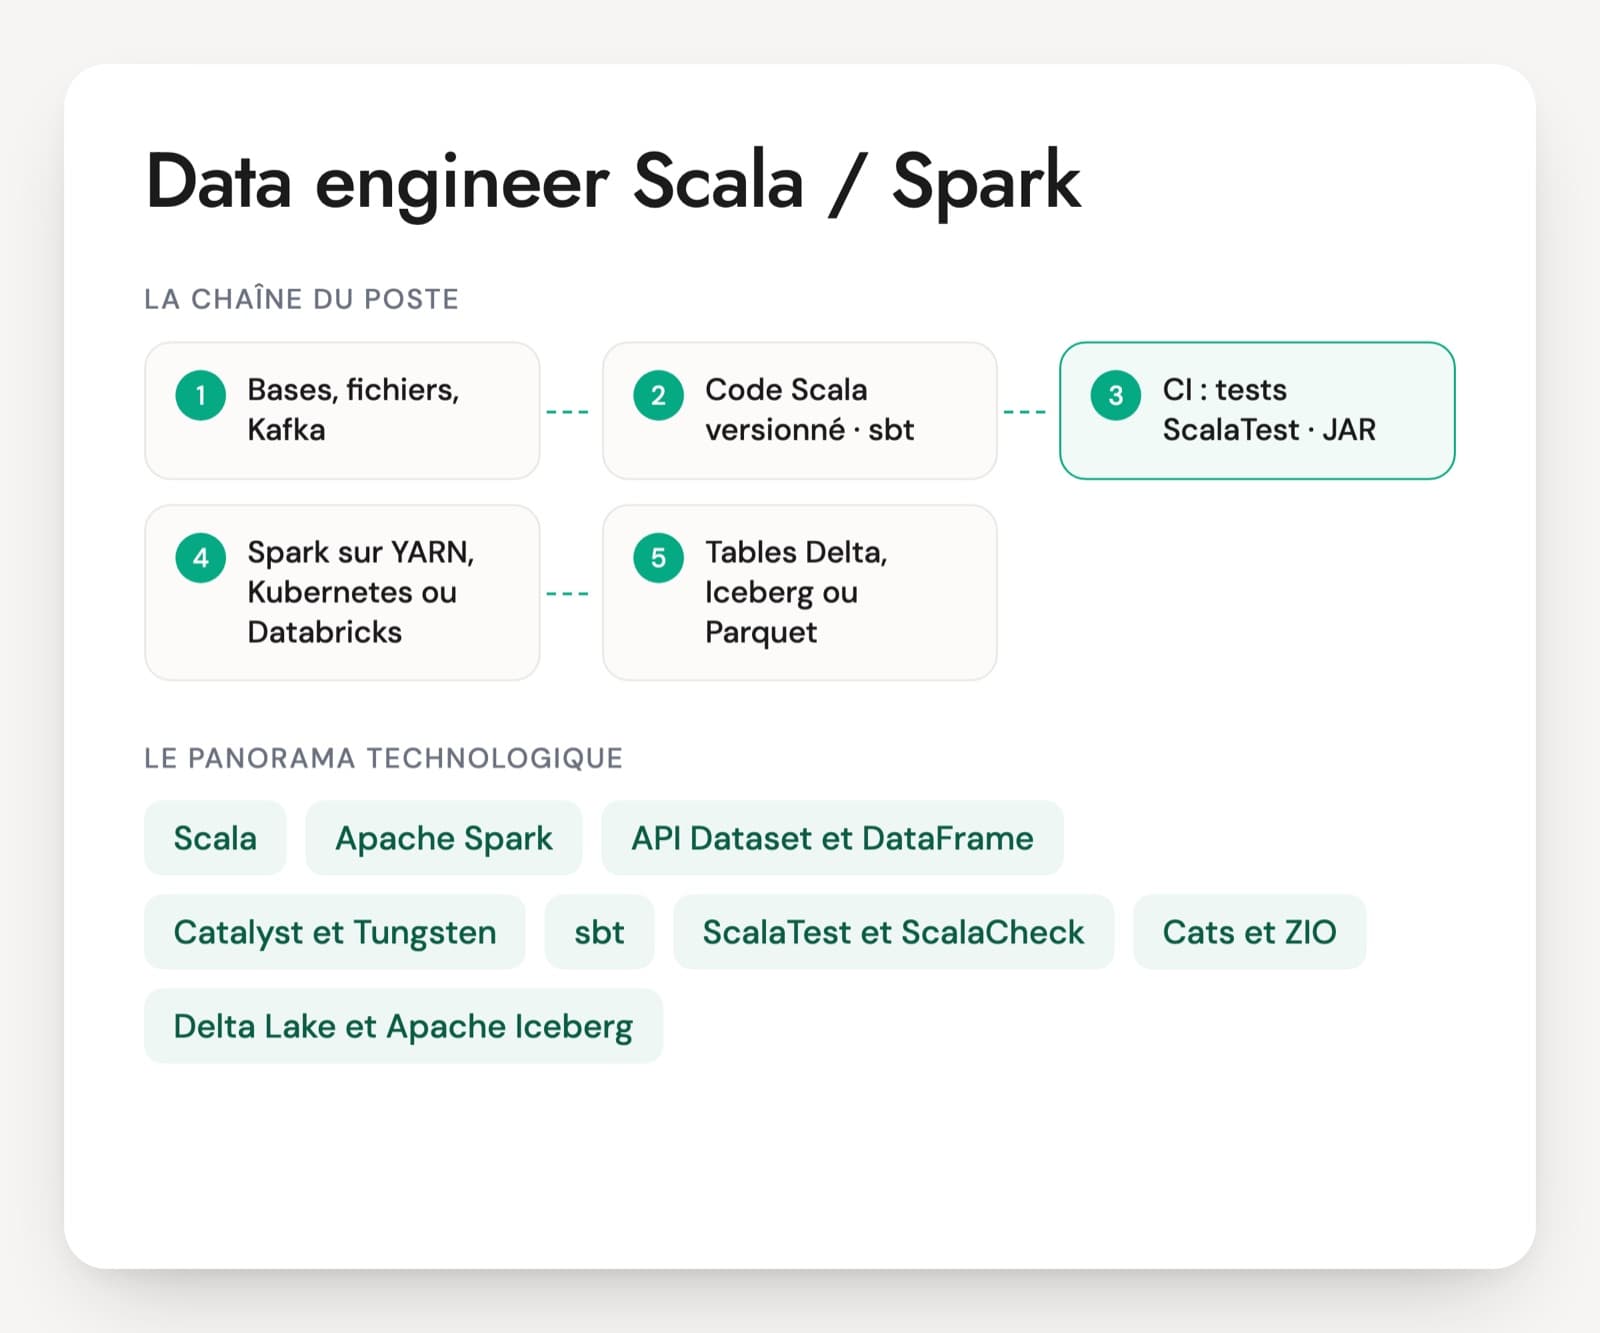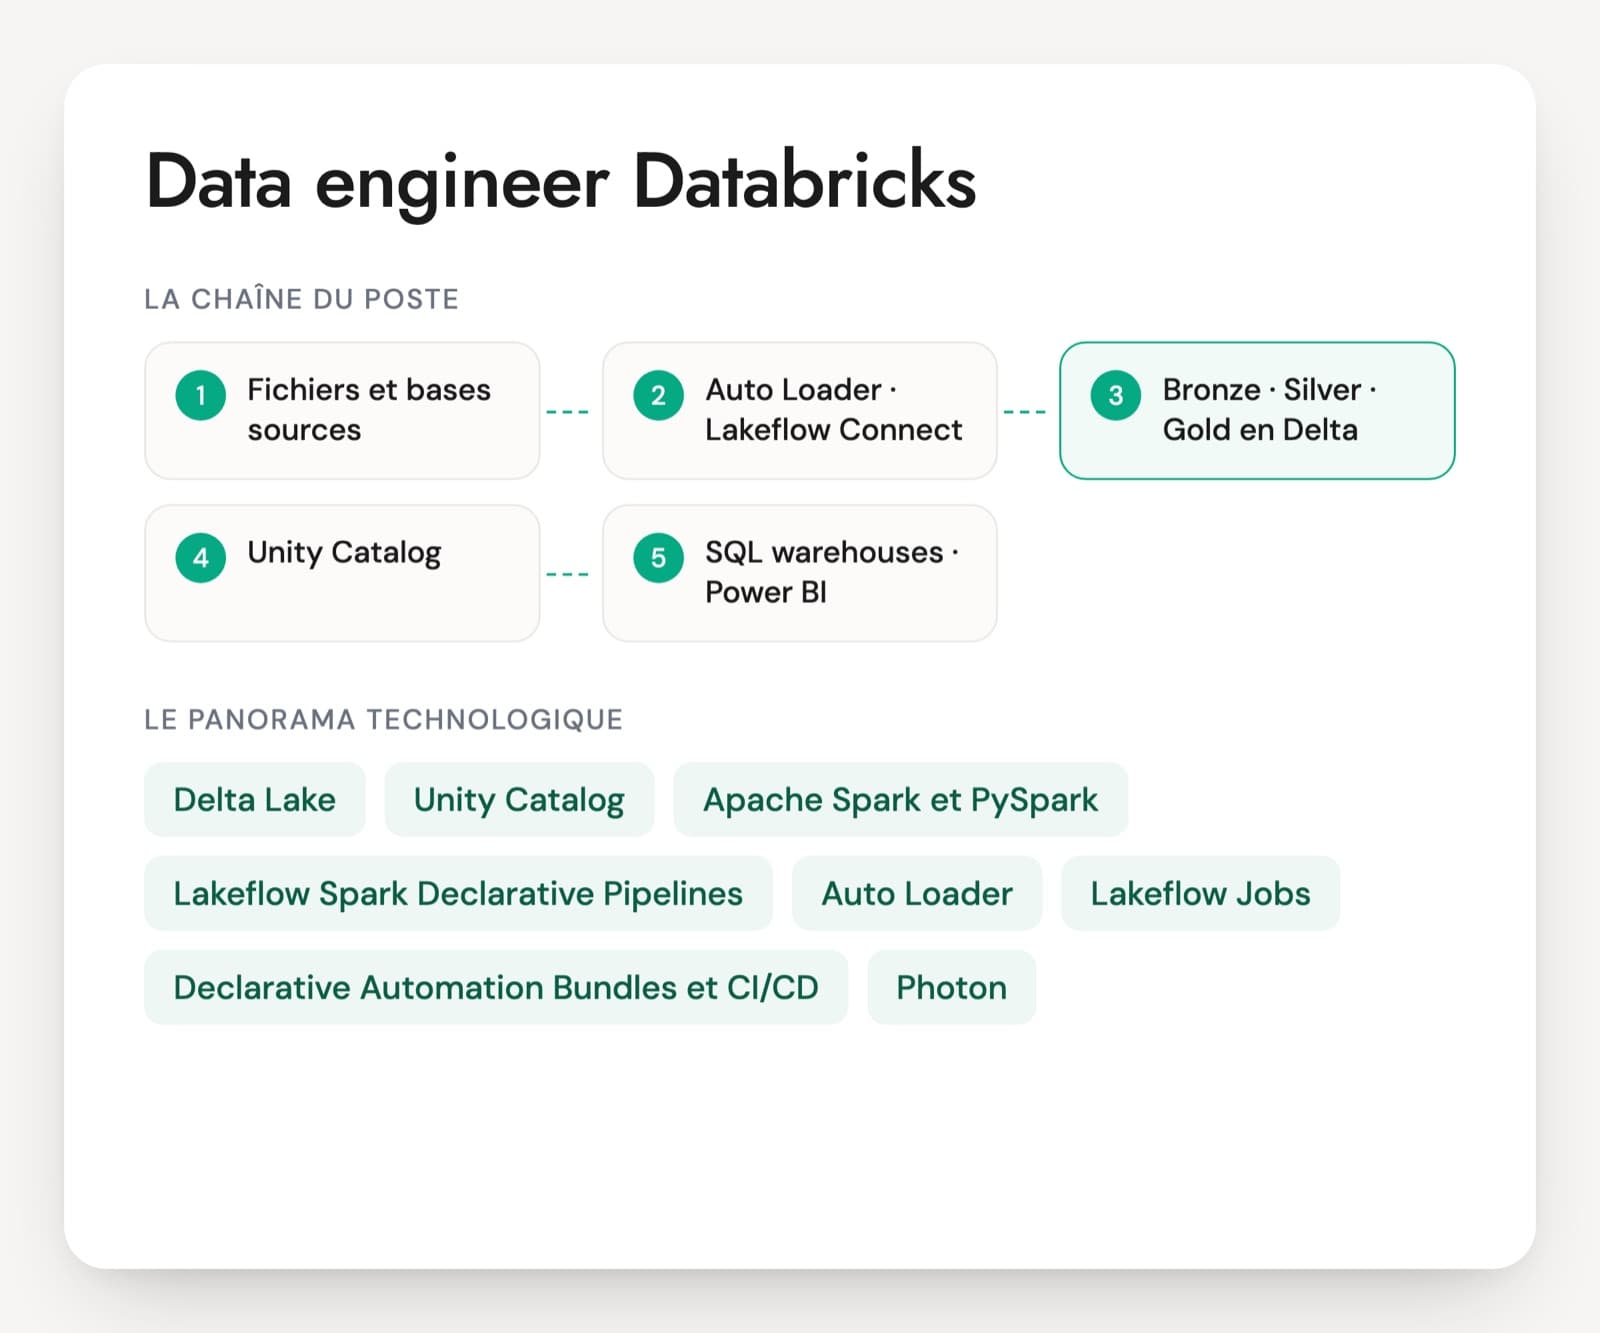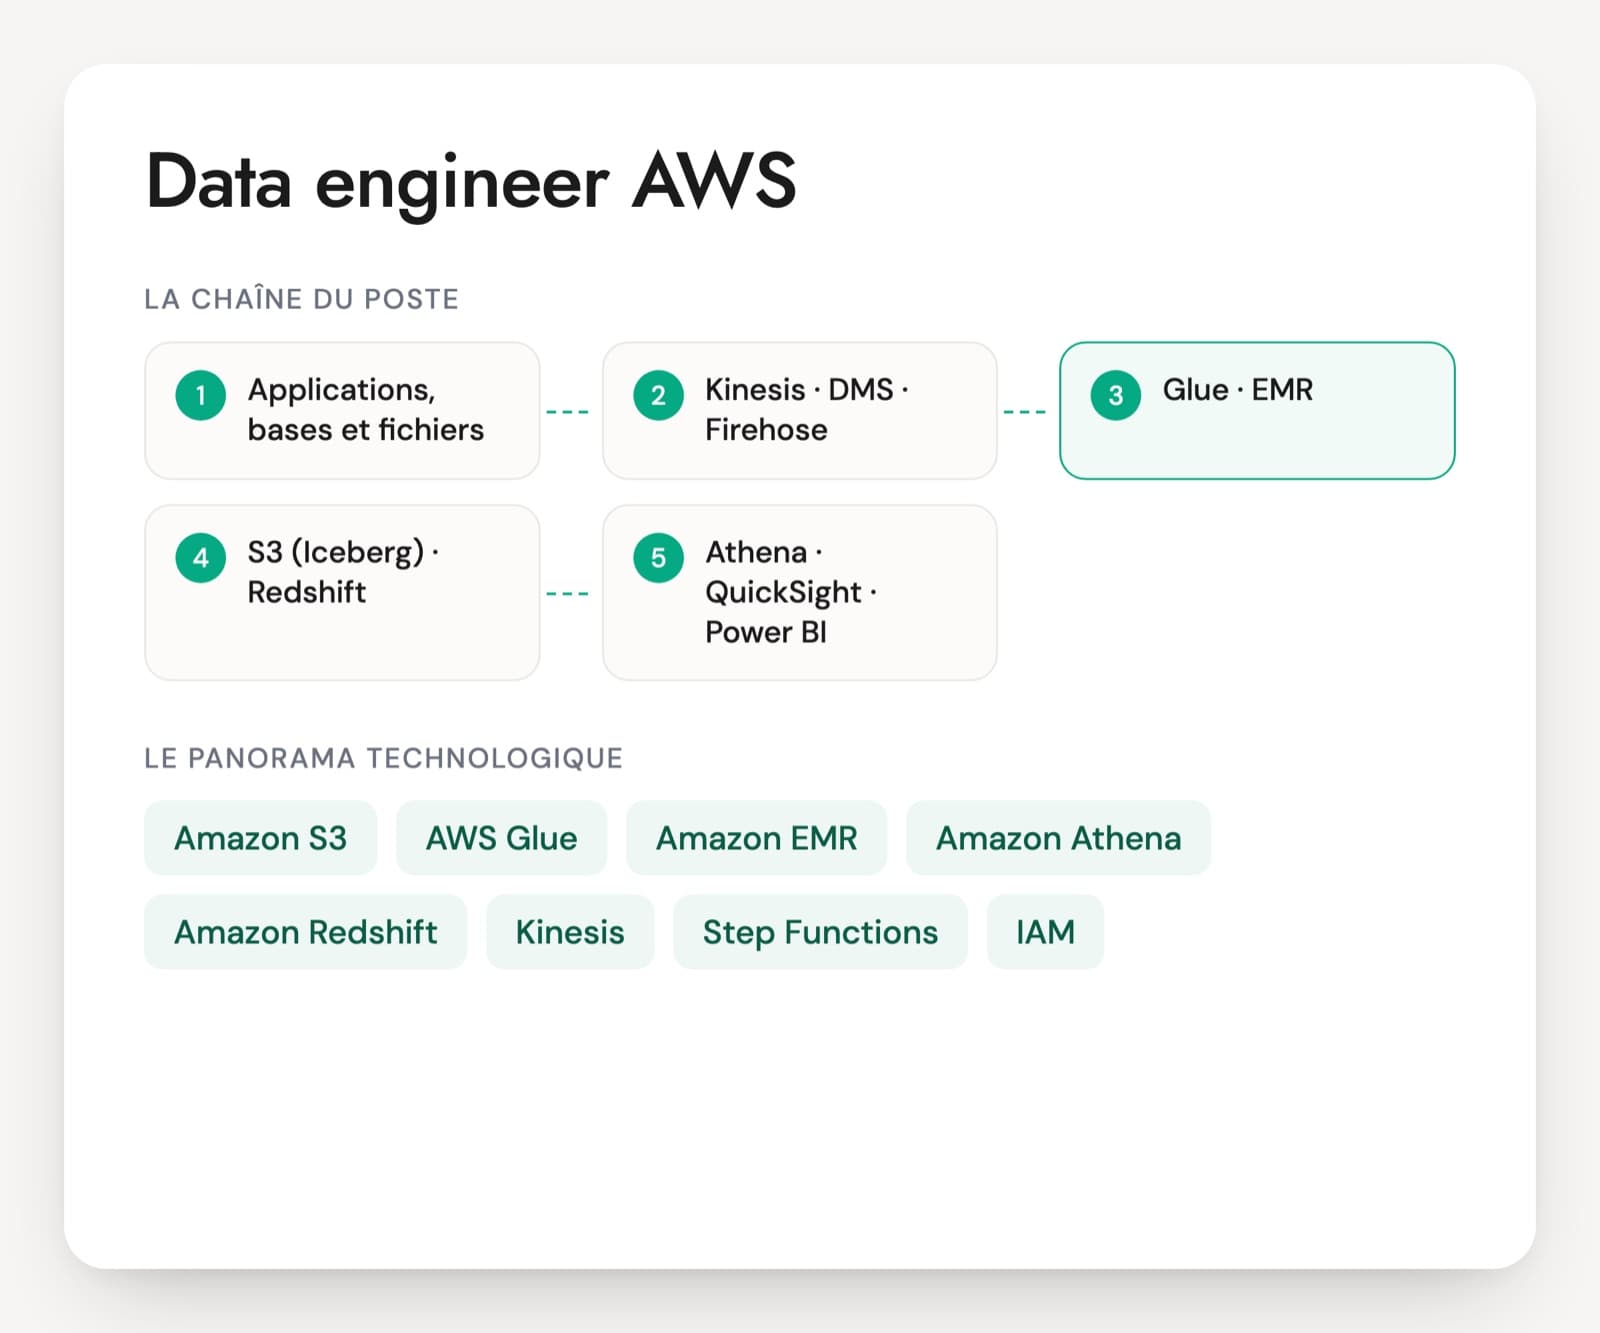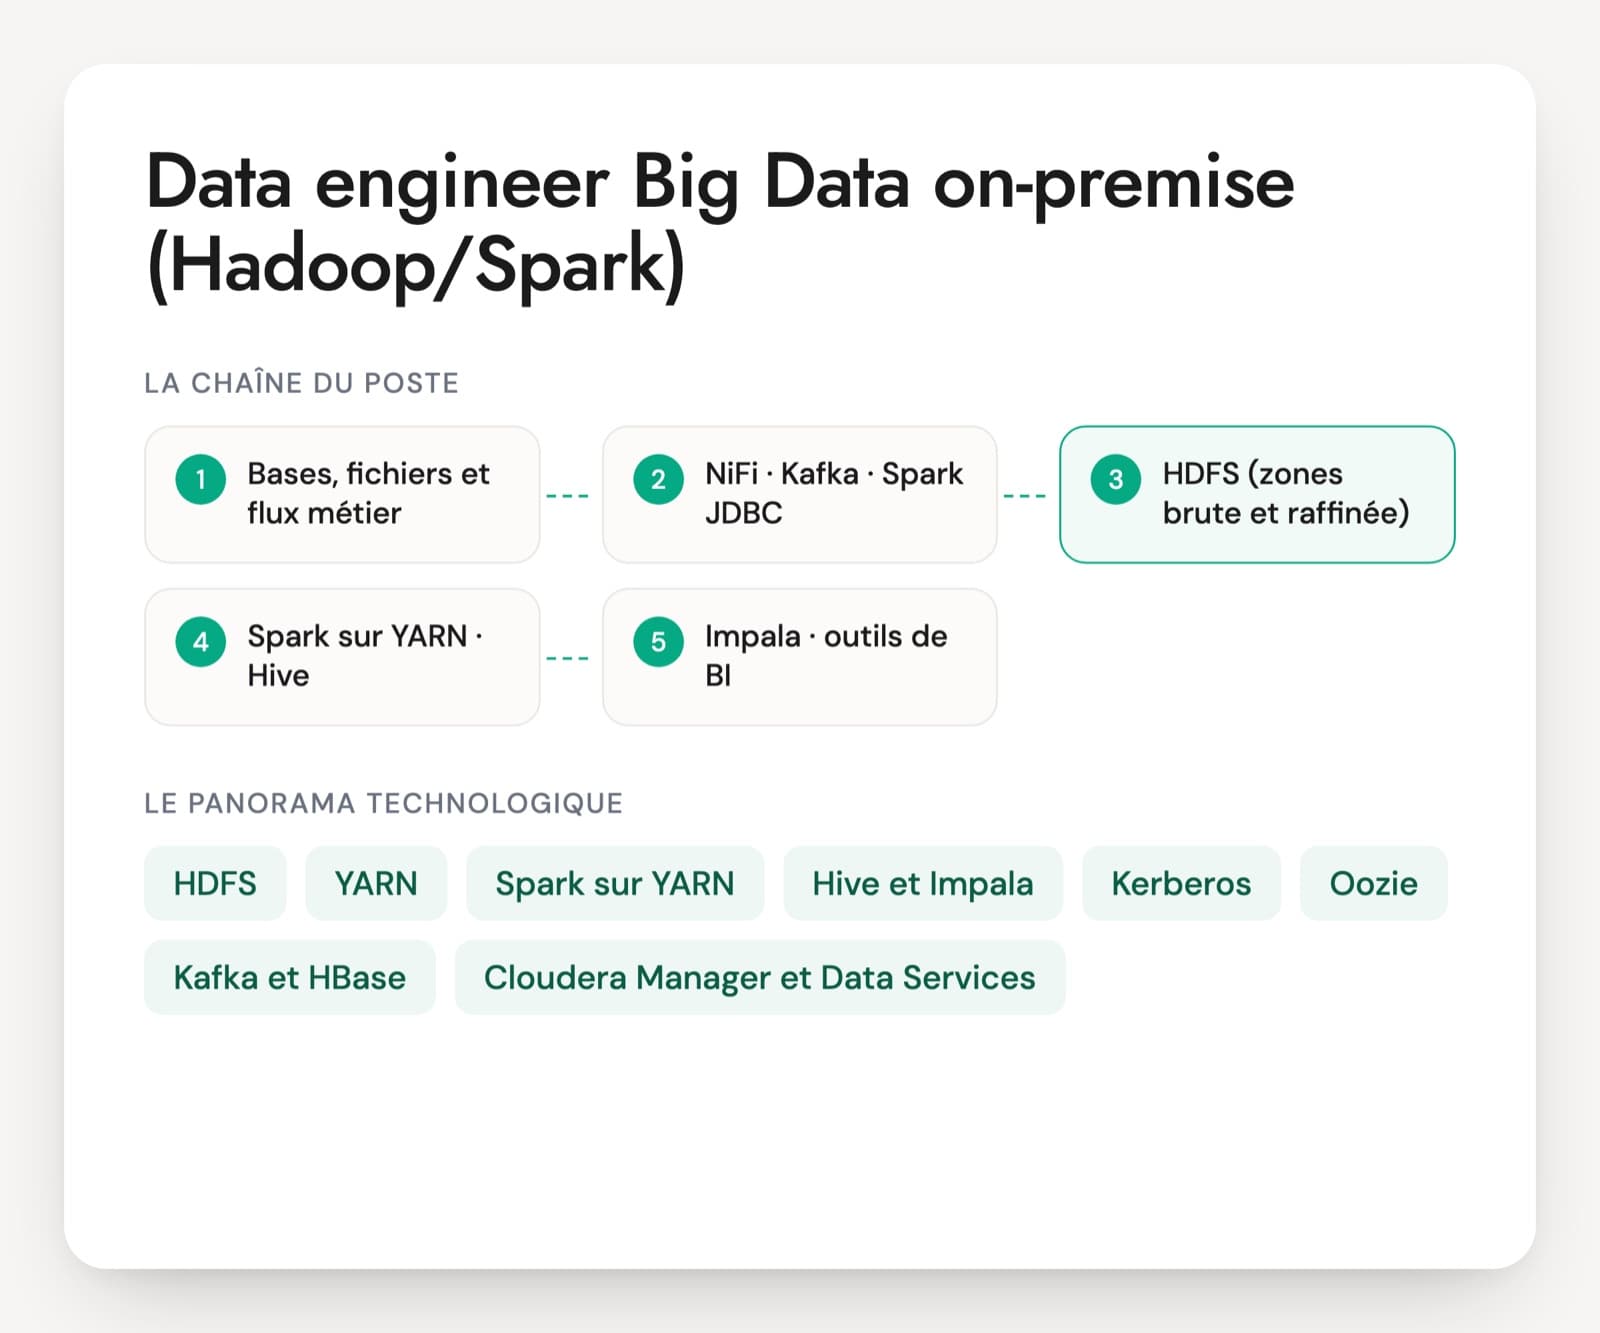
Un data engineer Hadoop travaille sur un cluster que l'entreprise possède et exploite elle-même. Il écrit des traitements Spark en Scala, en Java ou en PySpark, qui lisent et écrivent dans HDFS, expose les résultats dans des tables Hive ou Impala et planifie le tout avec Oozie, Airflow ou Control-M. Sur Free-Work, ces offres viennent surtout de la banque, de l'assurance et de la défense. La distribution est presque toujours Cloudera, depuis sa fusion avec Hortonworks.
Les CV ont changé avec le marché. Beaucoup de profils Spark viennent aujourd'hui de Databricks ou d'un cloud managé. Ils écrivent du bon code, sans avoir jamais obtenu un ticket Kerberos, choisi une file YARN ou nettoyé un répertoire HDFS rempli de petits fichiers. À l'inverse, des profils Hadoop de longue date connaissent le cluster par cœur et ont gardé des réflexes de Spark 2 ou de MapReduce. Depuis la version 7.3.1 de Cloudera, qui a retiré Spark 2, toute montée de version passe par Spark 3.
Si le poste prévoit une migration vers le cloud ou vers Kubernetes, insistez sur le dernier axe du PDF, qui traite ce passage. Un bon sujet de discussion : le dernier job qui a raté sa fenêtre de nuit, la file YARN utilisée, le nombre de fichiers écrits et ce qui a été changé ensuite.
L'écosystème Hadoop d'un cluster sur site
HDFS
Le système de fichiers distribué du cluster. Chaque fichier est découpé en blocs de 128 Mo par défaut, copiés en trois exemplaires sur des machines différentes. Le NameNode garde en mémoire la carte de tous les fichiers, ce qui rend les millions de petits fichiers dangereux pour tout le cluster.
YARN
Le gestionnaire de ressources. Il répartit la mémoire et les cœurs entre les équipes au moyen de files, avec une capacité garantie pour chacune. Un job Spark demande des conteneurs à YARN ; quand la file est pleine, il attend. Sur un cluster partagé, savoir lire l'interface de YARN fait partie du métier.
Spark sur YARN
Le moteur de traitement principal, écrit en Scala, en Java ou en PySpark. Cloudera Base on premises 7.3.2, sortie en mars 2026, livre Spark 3.5 ; Spark 2 a disparu de la version 7.3.1. Demandez comment la personne règle la mémoire des executors et lit la Spark UI.
Hive et Impala
Deux moteurs SQL sur les fichiers de HDFS, qui partagent le même catalogue de tables, le Hive Metastore. Hive sert aux traitements batch lourds et aux tables transactionnelles en ORC. Impala répond vite aux requêtes interactives des analystes et des outils de BI. Les versions récentes de Cloudera gèrent aussi les tables Apache Iceberg.
Kerberos, Ranger et Atlas
La sécurité du cluster. Kerberos authentifie chaque utilisateur et chaque service par des tickets, avec des fichiers keytab pour les comptes techniques. Ranger définit qui lit quelle base, quelle table ou quelle colonne, avec masquage et filtres de lignes. Atlas trace l'origine des données et classe les colonnes sensibles. C'est ici que se jouent les exigences des secteurs régulés.
Oozie, Airflow et NiFi
L'ordonnancement et l'ingestion. Oozie, l'ordonnanceur historique de Hadoop, décrit les enchaînements en XML. Airflow le remplace dans beaucoup de projets récents, et les banques gardent souvent Control-M. NiFi fait circuler les fichiers et les messages entre les sources et le cluster.
Kafka et HBase
Deux briques souvent présentes à côté de Spark. Kafka transporte les événements en temps réel vers le cluster. HBase stocke des données accessibles ligne par ligne en quelques millisecondes, pour une application qui consulte un client précis.
Cloudera Manager et Data Services
Cloudera Manager configure et surveille tous les services du cluster. Les Cloudera Data Services on premises font tourner Spark ou des entrepôts de données sur Kubernetes, à côté du cluster classique. C'est l'une des voies de modernisation que les offres mentionnent, avec la migration vers le cloud.
La plupart de ces postes sont des missions longues en ESN chez des banques, des assureurs ou des industriels de la défense, où certaines missions demandent une habilitation. Les données y restent sur site pour des raisons réglementaires ou contractuelles. Le data engineer Hadoop y travaille avec des administrateurs Cloudera, mais il doit comprendre YARN, HDFS et Kerberos pour diagnostiquer ses propres jobs. Beaucoup d'équipes préparent une sortie partielle vers Databricks, un cloud public ou Kubernetes, et les offres mélangent souvent Hadoop et Databricks. Les certifications Cloudera sont rares sur les CV. Ce qui se vérifie en entretien, c'est l'expérience d'un cluster en production, ses pannes et ses montées de version.
Ce qu'un data engineer Hadoop doit démontrer
- HDFS et formats de stockage
- Spark : performance et réglages
- Hive, Impala et modélisation
- YARN et partage du cluster
- Kerberos, Ranger et conformité
- Ordonnancement, ingestion et migration
Cinq mises en situation sur un cluster Hadoop et Spark
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Un répertoire HDFS contient trois millions de fichiers de quelques kilo-octets, et les requêtes Hive dessus sont lentes. Que se passe-t-il, et que faites-vous ?
Une bonne réponseChaque fichier et chaque bloc occupent de la mémoire dans le NameNode, et chaque petit fichier devient une tâche à lancer : le cluster passe plus de temps à organiser qu'à lire. Il compacte les données existantes (réécriture par Spark avec moins de partitions en sortie, ou ALTER TABLE ... CONCATENATE pour des tables ORC) vers des fichiers proches de la taille d'un bloc. Puis il corrige la cause : trop de partitions en sortie d'un job, un partitionnement trop fin, des micro-lots trop fréquents.
Signal d'alerte« On ajoute de la mémoire au NameNode » ou « on ajoute des nœuds », sans toucher à la cause.
Question 2 · senior
Un job Spark sur YARN passe de 20 minutes à trois heures, et dans la Spark UI quelques tâches durent bien plus longtemps que les autres. Quel est votre diagnostic ?
Une bonne réponseUn déséquilibre de données sur une clé de jointure ou d'agrégation : des clés nulles, un client énorme, une valeur par défaut. Il le confirme dans les métriques de l'étape (durée et volume de shuffle lus, maximum contre médiane). Remèdes : la gestion du déséquilibre par l'exécution adaptative de Spark 3 (AQE), une jointure broadcast si une table est petite, le salage de la clé, le traitement à part des clés nulles. Il regarde aussi les débordements sur disque et le temps de garbage collection.
Signal d'alerte« On ajoute des executors et de la mémoire » sans regarder la répartition des tâches.
Question 3 · confirmé
Votre job Spark reste bloqué à l'état ACCEPTED dans YARN. Que vérifiez-vous ?
Une bonne réponseDans l'interface du ResourceManager : la file visée est-elle pleine, la part réservée aux ApplicationMasters est-elle atteinte, la taille de conteneur demandée dépasse-t-elle le maximum autorisé par le cluster ? Il relance dans la bonne file, réduit la taille des executors ou active l'allocation dynamique avec un plafond, et prévient les administrateurs si la capacité de la file ne correspond plus aux besoins.
Signal d'alerteRelancer le job en boucle, ou demander qu'on tue les jobs des autres équipes.
Question 4 · confirmé
Comment une chaîne batch nocturne s'authentifie-t-elle sur un cluster kerberisé, et que faites-vous quand elle échoue sur un ticket expiré ?
Une bonne réponseUn compte de service avec son keytab, protégé en lecture pour ce seul compte, et un spark-submit avec --principal et --keytab pour que Spark renouvelle seul ses jetons sur un job long. En cas d'échec, il vérifie avec klist, contrôle le décalage d'horloge entre machines et un keytab régénéré côté annuaire (numéro de version de clé différent). Jamais le mot de passe d'une personne.
Signal d'alerteUn kinit lancé avec un compte personnel dans une crontab, un keytab dans Git, ou « on demande à désactiver Kerberos pour ce job ».
Question 5 · confirmé
Dans une banque, des analystes doivent interroger une table de transactions sans voir les IBAN en clair. Comment le configurez-vous sur le cluster ?
Une bonne réponseUne politique Ranger de masquage de colonne sur Hive et Impala (masquage partiel ou hachage) pour le groupe des analystes, et un filtre de lignes si chaque entité ne doit voir que ses clients. Il bloque l'accès direct aux fichiers HDFS de la table, sinon le masquage se contourne en lisant les fichiers. Une classification Atlas sur les colonnes sensibles permet des politiques Ranger par étiquette. Les audits Ranger tracent les consultations.
Signal d'alerteUne copie de la table sans la colonne pour chaque équipe, ou des droits de fichiers ouverts en pensant que Hive suffit à protéger.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Profils Hadoop et Spark : les interrogations des recruteurs
Pourquoi des entreprises gardent-elles un cluster Hadoop sur site ?
Pour des données qui ne doivent pas quitter leur datacenter : secret bancaire, défense, données de santé, exigences d'un régulateur ou d'un client. Le coût d'un cluster déjà amorti pèse aussi, tout comme celui d'une migration. Cloudera continue de publier sa version sur site, la 7.3.2 en mars 2026, avec Iceberg et des services sur Kubernetes. Beaucoup d'équipes préparent une migration partielle, ce qui demande un profil capable de travailler sur les deux mondes.
Scala, Java ou PySpark : quel langage exiger ?
Celui du code existant. Les traitements historiques des banques sont souvent en Scala, les projets récents plus souvent en PySpark. Un bon développeur Spark passe de l'un à l'autre, mais maintenir une base de code Scala demande une vraie pratique du langage, de son typage et de ses outils de build comme sbt ou Maven. Faites lire à la personne un extrait de votre propre code et demandez-lui ce qu'il fait.
Où s'arrête le data engineer et où commence l'administrateur Cloudera ?
L'administrateur installe et met à jour le cluster, configure Cloudera Manager, Kerberos, la haute disponibilité et les files YARN. Le data engineer écrit les jobs, les tables et les enchaînements, et utilise le cluster dans les limites fixées. Sur site, la frontière est floue : un data engineer qui ne comprend ni YARN ni Kerberos ne sait pas diagnostiquer ses propres échecs. Beaucoup d'offres regroupent les deux sous l'étiquette DataOps ; précisez le partage dans la fiche de poste.
Que demander en test technique quand le cluster n'est pas accessible aux candidats ?
Le cluster n'est pas nécessaire. Montrez une capture de Spark UI avec une étape déséquilibrée, une commande spark-submit mal réglée ou un journal d'erreur Kerberos, et demandez à la personne de l'expliquer à voix haute pendant l'entretien technique. Un court extrait de code Scala ou PySpark avec un shuffle inutile marche aussi. Vous voyez ses réflexes de diagnostic sans exposer vos données ni ouvrir d'accès au réseau de l'entreprise.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.