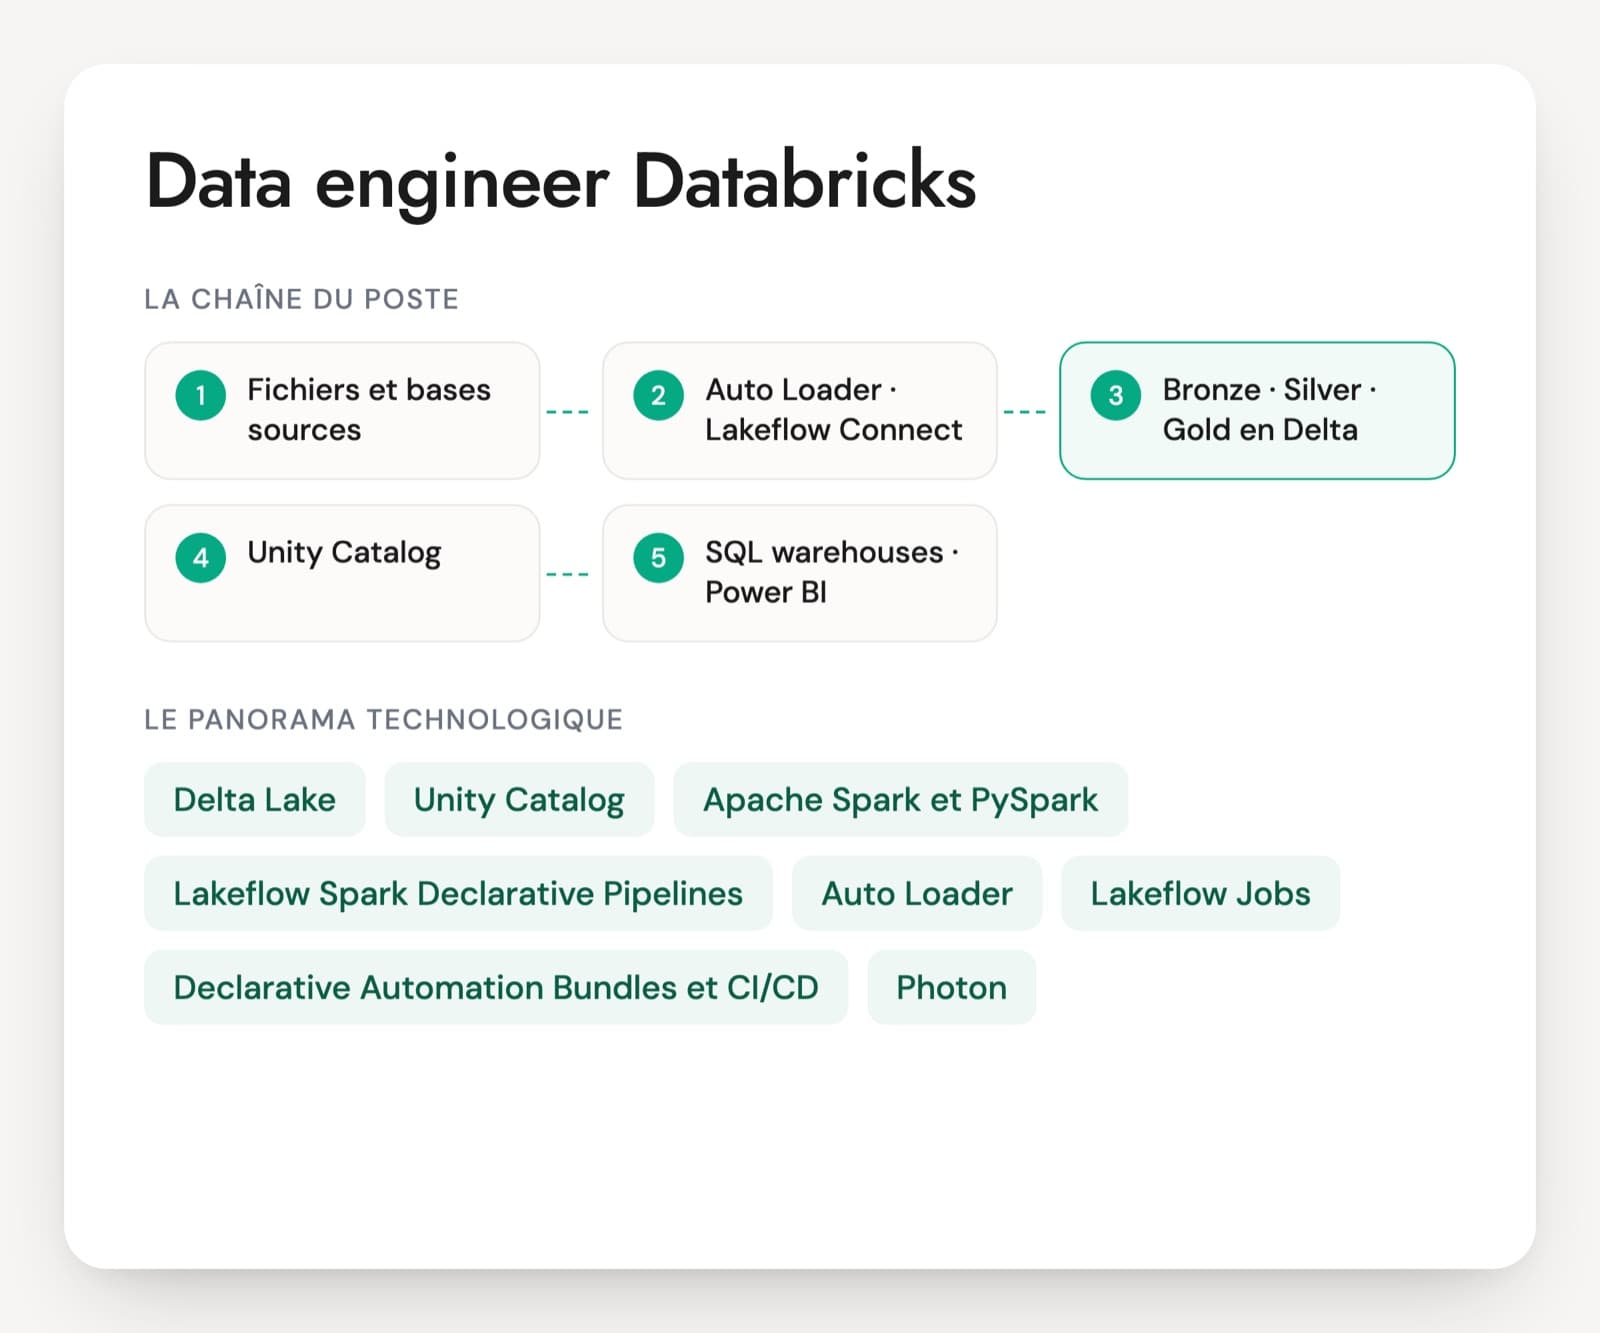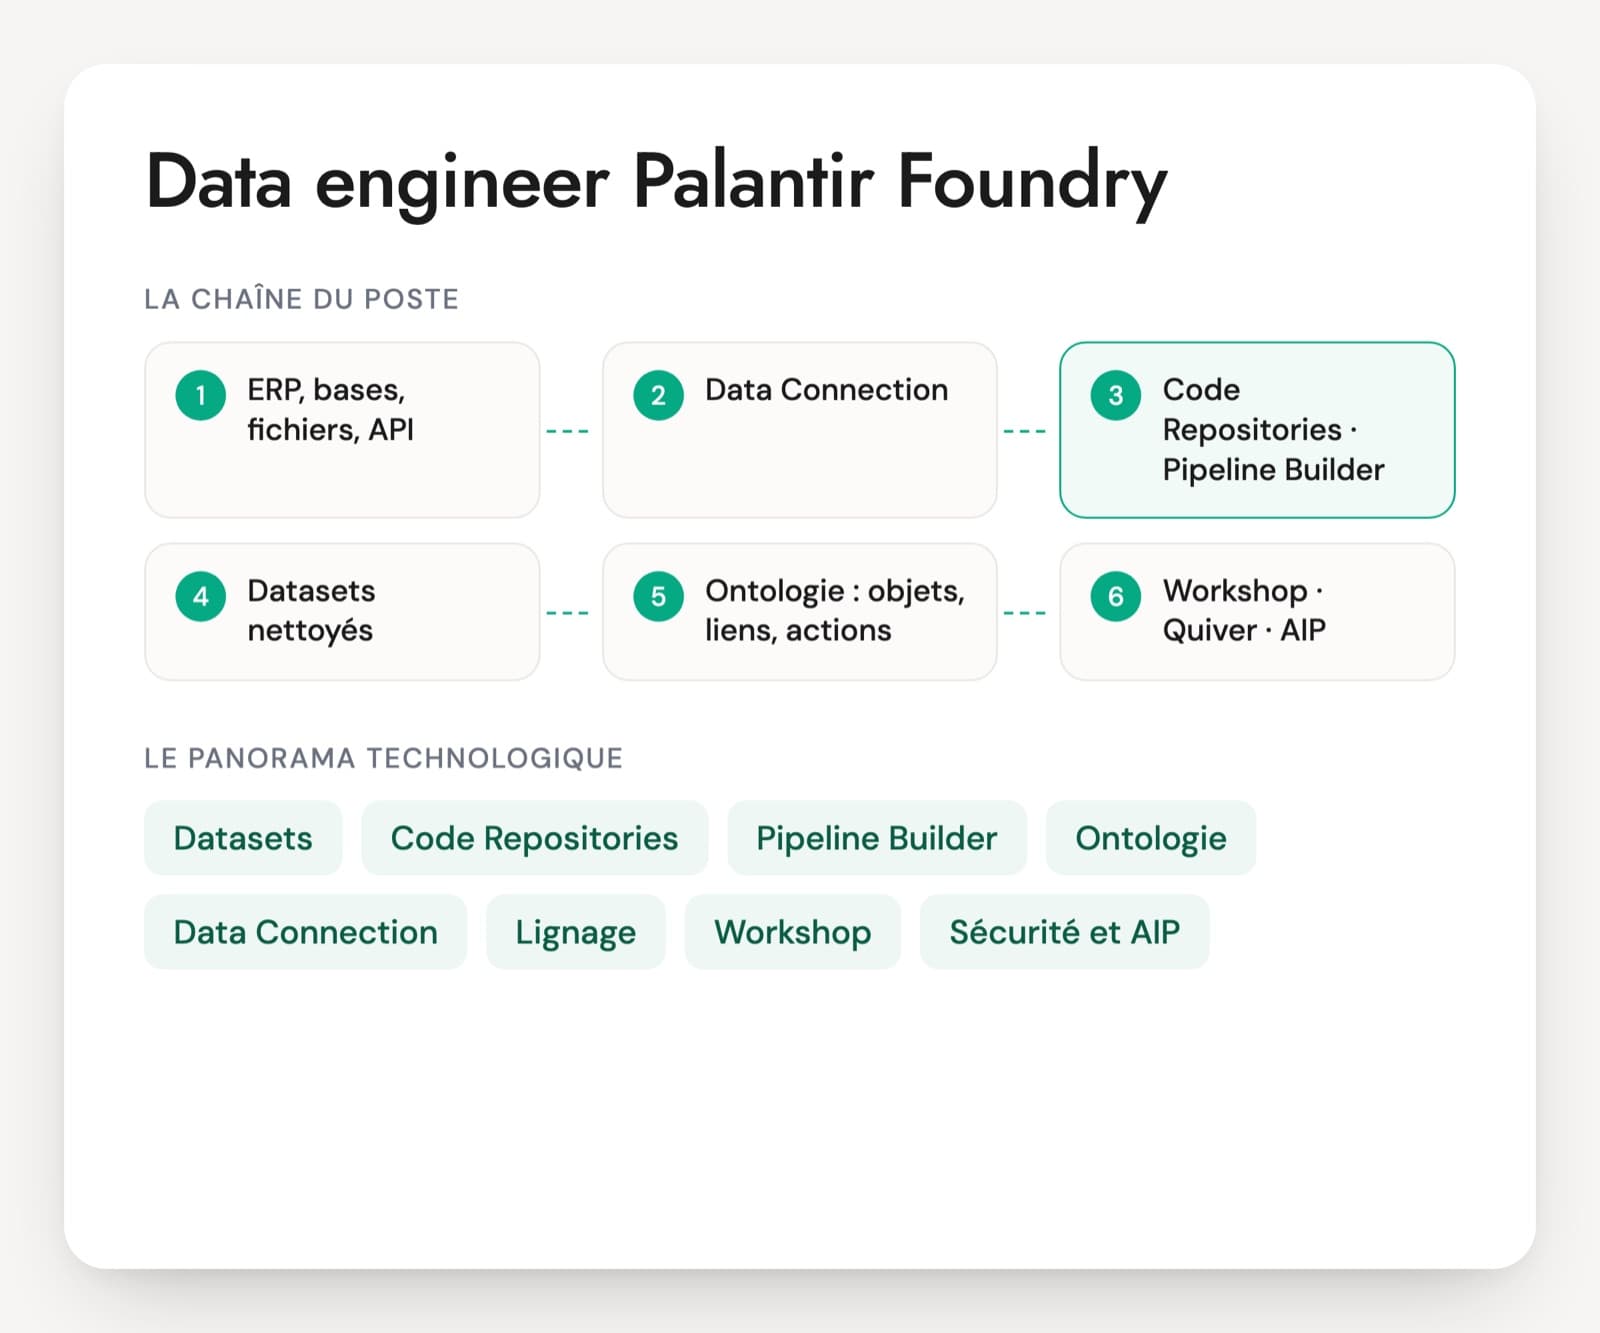
Un data engineer Palantir Foundry travaille dans un environnement fermé, très différent d'un cloud public. Il écrit des transforms en PySpark dans les Code Repositories ou assemble des pipelines dans Pipeline Builder, gère des builds et leurs plannings, puis transforme des jeux de données en objets de l'ontologie, avec leurs liens et les actions que les utilisateurs peuvent déclencher. En France, les offres viennent beaucoup de l'aéronautique autour de Toulouse, de l'industrie et de l'assurance, souvent par l'intermédiaire d'ESN.
Le mot Foundry couvre des métiers différents d'un CV à l'autre. Quelqu'un qui a construit des analyses Contour ou des applications Workshop n'a pas forcément écrit de transform incrémentale. À l'inverse, un bon data engineer Spark sans expérience Foundry peut apprendre la plateforme s'il comprend ses notions propres : transactions de datasets, branches, lignage, ontologie. La certification Foundry Data Engineer de Palantir atteste la connaissance de ces notions. La façon dont la personne parle d'un build retombé en recalcul complet ou d'une clé primaire d'objet en double en dit davantage.
Si vous n'avez qu'une demi-heure, gardez la question sur les transforms incrémentales et celle sur l'ontologie. Le PDF couvre l'entretien entier, avec 30 questions sur six axes, une étude de cas de 20 minutes sur le suivi des pièces d'une flotte d'avions et une grille de 1 à 4.
Les applications Foundry qu'un data engineer utilise au quotidien
Datasets, transactions et builds
Dans Foundry, chaque jeu de données est versionné par transactions : SNAPSHOT remplace tout, APPEND ajoute des fichiers, UPDATE et DELETE modifient l'existant. Un build recalcule un dataset à partir de ses entrées, à heure fixe ou à l'arrivée de nouvelles données. Cette mécanique explique la plupart des comportements surprenants d'un pipeline, et un profil confirmé la décrit sans hésiter.
Code Repositories
L'éditeur de code intégré, adossé à Git, où l'on écrit les transforms en Python (PySpark), en SQL ou en Java. Une transform déclare ses entrées et ses sorties, et Foundry en déduit l'ordre des traitements. Le mode incrémental ne traite que les nouvelles données, avec des règles précises sur les cas où il retombe en recalcul complet. Les transforms légères tournent sans Spark, avec pandas ou Polars, pour les petits volumes.
Pipeline Builder
L'outil visuel de construction de pipelines. Il produit des transformations typées, gère ses propres branches et propositions de changement, et peut alimenter directement l'ontologie. Beaucoup d'équipes l'utilisent pour les flux simples et gardent les Code Repositories pour la logique complexe. Demandez au candidat comment il choisit entre les deux.
Ontologie
La couche qui transforme des tables en objets métier. Un type d'objet (un avion, une pièce, une intervention) repose sur un dataset avec une clé primaire, des types de liens le relient à d'autres objets, des actions permettent aux utilisateurs de modifier les données et des fonctions en TypeScript ou en Python portent la logique. C'est ce qui sépare Foundry d'un entrepôt de données, et le sujet sur lequel les profils débutants restent vagues.
Data Connection
Le module d'ingestion. Il se connecte aux bases, fichiers, API et ERP comme SAP, directement ou par un agent installé dans le réseau de l'entreprise, puis dépose les données brutes dans des datasets. Les synchronisations sont complètes ou incrémentales selon la source.
Lignage, health checks et Data Expectations
Data Lineage affiche le graphe de dépendances entre datasets et permet de lancer des builds depuis ce graphe. Les health checks surveillent la fraîcheur, le volume ou le schéma d'un dataset. Les Data Expectations, écrites dans le code des transforms, font échouer un build quand une règle n'est pas respectée, par exemple une clé primaire en double.
Workshop, Contour et Quiver
Les outils de restitution. Workshop sert à construire des applications métier sur les objets de l'ontologie, Contour à analyser des tables, Quiver à explorer des objets et des séries temporelles. Le data engineer ne les construit pas toujours, mais il livre les objets et les datasets sur lesquels ils reposent.
Sécurité et AIP
Les droits s'organisent par projets. Les markings imposent des restrictions obligatoires qui suivent la donnée dans tout le lignage, et les vues restreintes filtrent les lignes selon l'utilisateur. AIP ajoute des fonctions fondées sur des LLM (AIP Logic, agents) au-dessus de l'ontologie ; selon le poste, le data engineer prépare les objets qu'elles utilisent.
Les missions Foundry passent souvent par des ESN et des cabinets de conseil, chez de grands industriels, dans l'aéronautique ou l'assurance. Le poste mêle data engineering et échanges avec le métier, car l'ontologie se conçoit avec les futurs utilisateurs des applications. Selon le projet, la personne écrit surtout du PySpark, assemble surtout des pipelines dans Pipeline Builder, ou modélise l'ontologie et les actions. Les intitulés varient (consultant Palantir, développeur Foundry, data engineer) et ne disent pas toujours lequel de ces métiers est attendu. Si vous ouvrez le poste à un bon profil Spark sans expérience de la plateforme, les axes PySpark et qualité des données du PDF jugent le socle. Palantir propose des certifications, dont Foundry Data Engineer Associate, et des parcours de formation sur learn.palantir.com.
Ce qui distingue un data engineer Foundry autonome
- Transforms PySpark dans les Code Repositories
- Builds incrémentaux et transactions de datasets
- Pipeline Builder et choix de l'outil
- Modélisation de l'ontologie
- Qualité des données, lignage et health checks
- Sécurité, branches et mise en production
Cinq mises en situation Foundry pour l'entretien
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · senior
Votre transform incrémentale a retraité tout l'historique cette nuit au lieu des seules nouvelles lignes. Que s'est-il passé ?
Une bonne réponseLe build est retombé en recalcul complet. Causes connues : une entrée a reçu une transaction SNAPSHOT qui l'a entièrement réécrite, une transaction UPDATE a modifié des fichiers existants, un DELETE non autorisé, un semantic_version modifié, ou une sortie construite par une autre transform. Il le vérifie dans les journaux du build (avertissement Not running incrementally). Il sait utiliser require_incremental pour faire échouer le build plutôt que tout recalculer, et snapshot_inputs pour les petites tables de référence réécrites à chaque fois.
Signal d'alerte« Foundry a planté » ou « je relance », sans connaître les transactions de datasets.
Question 2 · confirmé
Vous devez créer un type d'objet « Intervention » pour une application de maintenance. Comment le concevez-vous dans l'ontologie ?
Une bonne réponseUn dataset propre et dédié derrière le type d'objet, avec une clé primaire unique et stable (plutôt une chaîne qu'une date), des propriétés nommées pour le métier, des types de liens vers Avion et Pièce avec leur cardinalité, et des actions pour les modifications prévues, comme clôturer une intervention, avec leurs règles de validation. L'unicité de la clé est contrôlée par une Data Expectation dans la transform qui produit le dataset. La conception part des écrans dont les techniciens auront besoin.
Signal d'alerteBrancher directement un dataset brut de l'ERP sur le type d'objet, avec des clés en double, sans réflexion sur les liens.
Question 3 · confirmé
Pipeline Builder ou Code Repositories : comment choisissez-vous pour un nouveau flux ?
Une bonne réponsePipeline Builder pour des transformations lisibles par une équipe plus large, des jointures et nettoyages standards, et une alimentation directe de l'ontologie. Code Repositories quand il faut de la logique complexe, des tests unitaires, des bibliothèques Python, un incrémental fin ou des performances Spark à régler. Le critère qui revient : qui reprendra le flux, et dans quel outil cette équipe sait travailler.
Signal d'alerteUn seul outil pour tout, sans critère de choix.
Question 4 · confirmé
Comment testez-vous une modification de transform sans toucher aux datasets utilisés en production ?
Une bonne réponseSur une branche du dépôt : les builds lancés sur la branche écrivent des versions de branche des datasets, sans modifier la branche principale. Il compare les sorties de la branche à celles de la production, fait relire la pull request avec les tests unitaires (pytest dans le dépôt) et les contrôles automatiques, puis fusionne. Il sait que les datasets non construits sur la branche sont lus depuis la branche de repli.
Signal d'alerteModifier directement la branche principale et relancer le build de production.
Question 5 · confirmé
Une application Workshop affiche les chiffres d'hier alors que la source a été mise à jour ce matin. Comment remontez-vous la chaîne ?
Une bonne réponseIl part de l'objet et remonte le lignage : dernière indexation de l'objet depuis son dataset, dernier build réussi de chaque dataset en amont, planning et éventuel échec, puis synchronisation Data Connection. Il consulte l'historique des builds et des transactions et les health checks de fraîcheur. S'il manquait un contrôle de fraîcheur avec alerte, il l'ajoute.
Signal d'alerteRelancer tous les builds de la plateforme sans chercher où la chaîne s'est arrêtée.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Juger un profil Foundry sans accès à la plateforme
Peut-on recruter un data engineer Foundry qui n'a jamais utilisé la plateforme ?
Oui, si le socle est solide : PySpark, SQL, modélisation de données et réflexes de production. Les notions propres à Foundry demandent du temps d'apprentissage, surtout les transactions de datasets, les builds incrémentaux, les branches et l'ontologie. En entretien, posez les questions Spark et modélisation du PDF. Expliquez ensuite en deux phrases ce qu'est une transaction SNAPSHOT et voyez si la personne en déduit seule le risque pour un traitement incrémental.
Que prouve la certification Foundry Data Engineer de Palantir ?
Elle montre que la personne connaît les outils et les notions de la plateforme : Data Connection, transforms, Pipeline Builder, ontologie, lignage. Palantir a renouvelé ses examens et annonce une validité de deux ans, ce qui permet de vérifier si la certification est récente. Elle ne remplace pas l'expérience d'un projet en production. Faites raconter un build incrémental cassé, une ontologie conçue avec le métier ou une reprise de pipeline, avec sa cause technique.
Consultant Palantir, développeur Foundry, data engineer : quelle différence ?
Les intitulés se recoupent. Le data engineer Foundry construit l'ingestion, les transforms et les datasets qui alimentent l'ontologie. Le développeur Foundry construit surtout les applications : Workshop, Slate, fonctions TypeScript, parfois les actions. Le consultant Palantir couvre souvent les deux, avec une part de recueil du besoin et de conception de l'ontologie. Lisez le détail de l'offre avant de choisir vos questions, car un profil Workshop n'a pas forcément écrit de PySpark.
Quel test technique proposer sans accès à Foundry ?
Un exercice PySpark dans n'importe quel notebook juge le socle : une jointure, une déduplication, un traitement incrémental sur une table d'événements. Ajoutez un exercice de modélisation au tableau. À partir de trois tables d'un logiciel de maintenance, la personne propose les types d'objets, leurs clés primaires, les liens et les actions. Elle commente à voix haute. Vous jugez la qualité du code et la capacité à penser en objets métier.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.