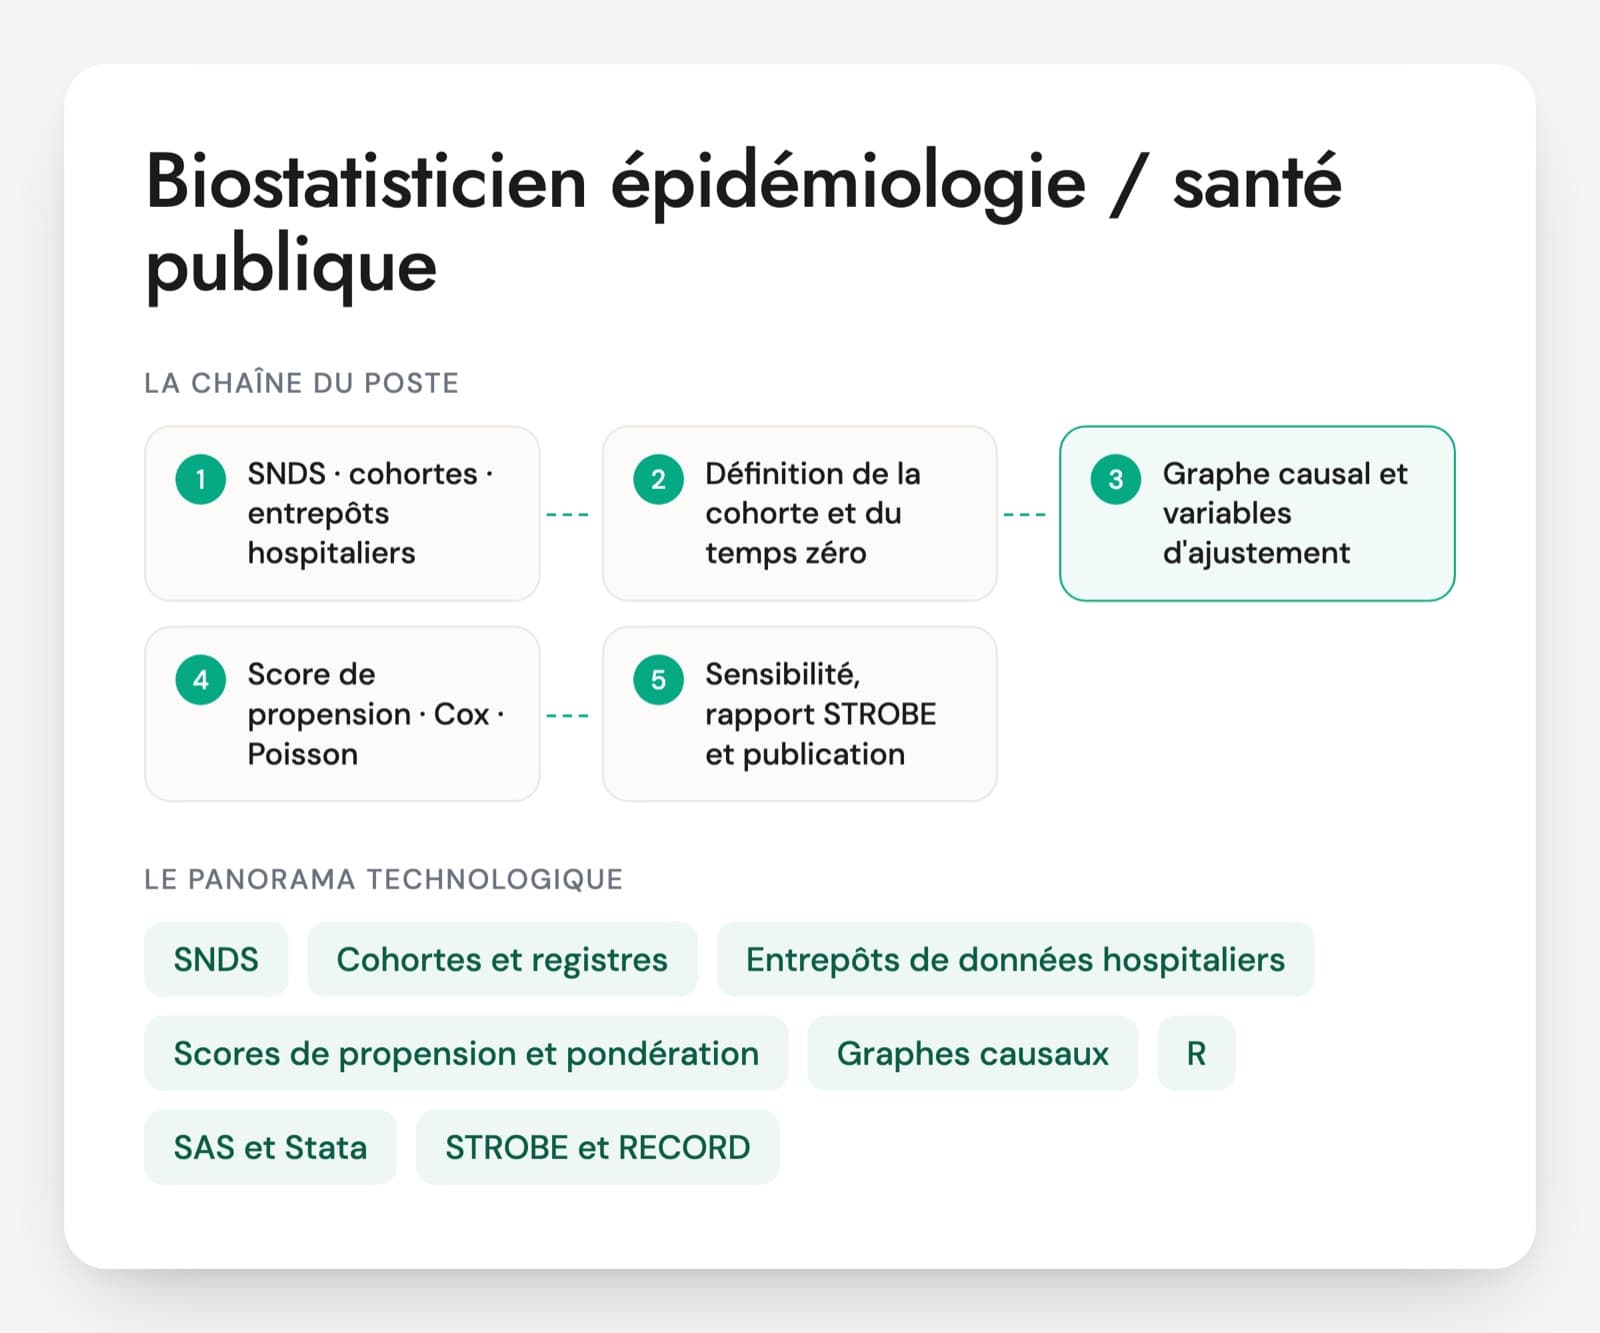
Un biostatisticien en épidémiologie travaille sur des données observationnelles : cohortes, registres, entrepôts de données hospitaliers et bases médico-administratives comme le SNDS. Il compare des patients qui n'ont pas été tirés au sort, ce qui l'oblige à traiter la confusion, les biais de sélection et les erreurs de classement de l'exposition. On le trouve dans les CHU et l'AP-HP, à l'ANSM, à Santé publique France, à l'Inserm et dans les équipes données de vie réelle de l'industrie, sollicitées pour les études post-autorisation.
Pour un recruteur, la difficulté est que tous les candidats citent les scores de propension. Peu savent dire à quel moment commence le suivi d'un patient, pourquoi on compare de nouveaux utilisateurs entre eux, ou comment vérifier qu'un score a réellement équilibré les groupes. La manière dont la personne parle du biais du temps immortel, des graphes causaux et des limites du SNDS en dit plus long que la liste des logiciels.
Selon les équipes, l'accès au SNDS est direct ou passe par un partenaire habilité, et le responsable d'études peut le dire avant l'entretien. La pratique réelle se vérifie vite au nom de quelques tables, comme le DCIR ou le PMSI. Un junior peut être solide en méthode sans y avoir eu accès.
Données et méthodes d'un biostatisticien en santé publique
SNDS
Le Système national des données de santé relie les remboursements de l'Assurance maladie (DCIR), les séjours hospitaliers (PMSI) et les causes médicales de décès (CépiDc). Il couvre presque toute la population, mais ne contient ni résultats d'examens, ni médicaments achetés sans ordonnance, ni données cliniques fines. L'accès passe par le CESREES et la CNIL, ou par une méthodologie de référence quand le projet s'y conforme.
Cohortes et registres
Des populations suivies dans le temps avec des données recueillies pour la recherche, comme Constances ou E3N, et des registres de maladies (cancers, malformations). Ils apportent des variables absentes du SNDS (tabac, poids, mode de vie), souvent sur des effectifs plus petits. Le chaînage avec le SNDS est fréquent.
Entrepôts de données hospitaliers
Les CHU constituent des entrepôts qui rassemblent dossiers patients, biologie, prescriptions et comptes rendus. Les données y sont riches mais hétérogènes, et leur usage est encadré par la CNIL. Demandez comment la personne a vérifié la qualité d'une variable extraite d'un dossier médical.
Scores de propension et pondération
Une méthode pour comparer des patients traités et non traités qui se ressemblent sur les facteurs connus. On estime la probabilité d'être traité, puis on apparie ou on pondère les patients. La qualité se juge à l'équilibre obtenu entre les groupes, pas à la performance du modèle de score.
Graphes causaux (DAG)
Des schémas qui représentent les liens supposés entre exposition, événement et autres variables. Ils servent à choisir les variables d'ajustement et à repérer celles qu'il ne faut pas ajuster, comme les médiateurs ou les colliders. L'outil en ligne DAGitty est souvent utilisé pour les dessiner.
R
Le logiciel le plus courant en recherche académique et en santé publique, avec survival pour les analyses de survie, MatchIt et WeightIt pour les scores de propension, mice pour l'imputation multiple. Les plateformes d'accès aux données de santé proposent R et Python. Vérifiez que le code est versionné et relu.
SAS et Stata
SAS reste très présent sur le SNDS, car le portail historique de la CNAM s'utilise sous SAS, et dans les équipes de l'industrie. Stata est répandu en épidémiologie académique. Un profil R peut apprendre SAS pour le SNDS, mais l'adaptation à la volumétrie du DCIR demande du temps.
STROBE et RECORD
Les grilles de rédaction des études observationnelles. STROBE couvre cohortes, cas-témoins et études transversales, RECORD l'étend aux données collectées en routine comme les bases médico-administratives. Les revues les demandent, et elles montrent si la personne a l'habitude de décrire ses choix de façon transparente.
Le poste prend des formes variées. En CHU ou à l'Inserm, le biostatisticien accompagne des cliniciens sur des cohortes et des registres, publie et encadre parfois des doctorants. Dans une agence sanitaire, il mène des études de pharmacoépidémiologie sur le SNDS pour éclairer une décision publique, avec des délais serrés. Dans l'industrie, les équipes données de vie réelle conduisent des études post-autorisation demandées par les autorités et des analyses d'accès au marché. Les offres demandent R ou SAS, l'expérience des études observationnelles et souvent du SNDS. L'entretien doit vérifier la maîtrise des biais propres à ces données, que les formations couvrent inégalement.
Ce qu'on attend d'un biostatisticien épidémiologiste
- Plans d'étude observationnels
- Confusion et graphes causaux
- Scores de propension et pondération
- Biais des bases médico-administratives
- Modèles de survie et de comptage
- Données manquantes et sensibilité
Questions d'entretien pour un biostatisticien en épidémiologie, réponses comprises
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · senior
À partir du SNDS, vous devez comparer deux anticoagulants oraux sur le risque d'hémorragie grave. Comment construisez-vous la cohorte ?
Une bonne réponseUn plan nouveaux utilisateurs avec comparateur actif : des patients sans délivrance d'anticoagulant pendant une période de recul, inclus à leur première délivrance de l'un ou l'autre produit. Le temps zéro est la date d'initiation, qui fixe aussi le début du suivi et la mesure des covariables avant cette date (antécédents, hospitalisations, affections de longue durée, co-médications). La personne définit l'arrêt ou le changement de traitement et cite l'émulation d'un essai cible.
Signal d'alerteComparer tous les patients sous chaque produit à une date donnée, utilisateurs anciens compris, ou mesurer les covariables après le début du traitement.
Question 2 · confirmé
Vous avez estimé un score de propension. Comment savez-vous qu'il a fonctionné ?
Une bonne réponseEn vérifiant l'équilibre des covariables après appariement ou pondération, par des différences moyennes standardisées (un seuil de 0,1 est courant), et le recouvrement des distributions du score entre groupes. Si des patients n'ont pas d'équivalent dans l'autre groupe, la personne restreint la population ou change de pondération (pondération de recouvrement) et regarde les poids extrêmes.
Signal d'alerte« L'AUC du modèle de score est de 0,85 », comme si la capacité à prédire le traitement mesurait l'équilibre obtenu.
Question 3 · confirmé
Comment choisissez-vous les variables d'ajustement dans une étude observationnelle ?
Une bonne réponseÀ partir des connaissances du domaine, formalisées dans un graphe causal : on ajuste sur les facteurs de confusion, qui influencent l'exposition et l'événement, et on évite d'ajuster sur les médiateurs, situés entre exposition et événement, et sur les colliders. Les variables sont mesurées avant l'exposition. La sélection automatique par p-value ne répond pas à cette question.
Signal d'alerteUne sélection pas à pas sur les p-values, ou « on ajuste sur tout ce qui est disponible ».
Question 4 · confirmé
Qu'est-ce que le biais du temps immortel, et comment l'évitez-vous ?
Une bonne réponseUne période pendant laquelle, par construction, l'événement ne peut pas survenir chez les exposés, souvent parce qu'on les classe comme exposés à partir d'une délivrance survenue après le début du suivi. Ce temps est compté comme exposé et fait paraître le traitement protecteur. Solutions : exposition dépendante du temps, alignement du temps zéro avec le début de l'exposition, analyse par repère temporel (landmark).
Signal d'alerteNe pas connaître le terme, ou le confondre avec la perte de vue.
Question 5 · confirmé
On vous demande les taux d'incidence d'une maladie rare par département. Comment les estimez-vous et comment les présentez-vous ?
Une bonne réponseDes cas rapportés aux personnes-années, standardisés sur l'âge et le sexe (ratio d'incidence standardisé), un modèle de Poisson ou binomial négatif si la variance dépasse la moyenne. Pour les départements à petits effectifs, un lissage bayésien qui emprunte de l'information aux voisins évite d'afficher des extrêmes dus au hasard. Les cellules trop petites sont masquées selon les règles de diffusion.
Signal d'alerteClasser les départements sur les taux bruts, sans standardisation ni intervalle de confiance.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Biostatisticien en épidémiologie : les doutes des recruteurs
Quelle différence entre un biostatisticien en épidémiologie et un biostatisticien en essais cliniques ?
En essai clinique, le tirage au sort rend les groupes comparables et le travail porte sur le plan d'analyse, la multiplicité et les livrables réglementaires. En épidémiologie, personne n'a tiré au sort : la difficulté est de construire une comparaison crédible malgré la confusion et les biais de mesure, sur des données collectées pour d'autres usages. Les deux profils partagent l'analyse de survie et les modèles. Un passage de l'un à l'autre demande un vrai temps d'adaptation.
Faut-il exiger une expérience du SNDS ?
Pour une agence sanitaire ou une équipe de pharmacoépidémiologie, elle fait gagner plusieurs mois : la structure du DCIR et du PMSI, la volumétrie et les algorithmes de repérage des pathologies demandent une prise en main longue. Pour un poste centré sur des cohortes ou des entrepôts hospitaliers, elle compte moins. Testez alors la méthode : un candidat qui maîtrise le temps zéro, les nouveaux utilisateurs et les scores de propension apprendra la base.
Un test technique sur données simulées est-il utile ?
Oui, s'il reste court. Un petit jeu simulé avec une exposition, un événement daté et quelques covariables suffit. Demandez une comparaison ajustée et un commentaire écrit. Glissez un piège, comme une exposition mesurée après le début du suivi, et regardez s'il est repéré. Vous évaluez en une heure la rigueur, le code et l'écriture. Laissez la personne choisir entre R, SAS et Stata pour juger la méthode plutôt que le logiciel.
R ou SAS pour un poste en santé publique ?
Cela dépend des données. R domine dans la recherche académique et chez les jeunes diplômés, avec des packages solides pour la survie, les scores de propension et l'imputation. SAS reste très présent sur le SNDS et dans l'industrie. Pour un poste centré sur le SNDS, une pratique de SAS ou une volonté claire de l'apprendre se justifie. Ailleurs, la qualité du raisonnement épidémiologique compte davantage que le logiciel de départ.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.