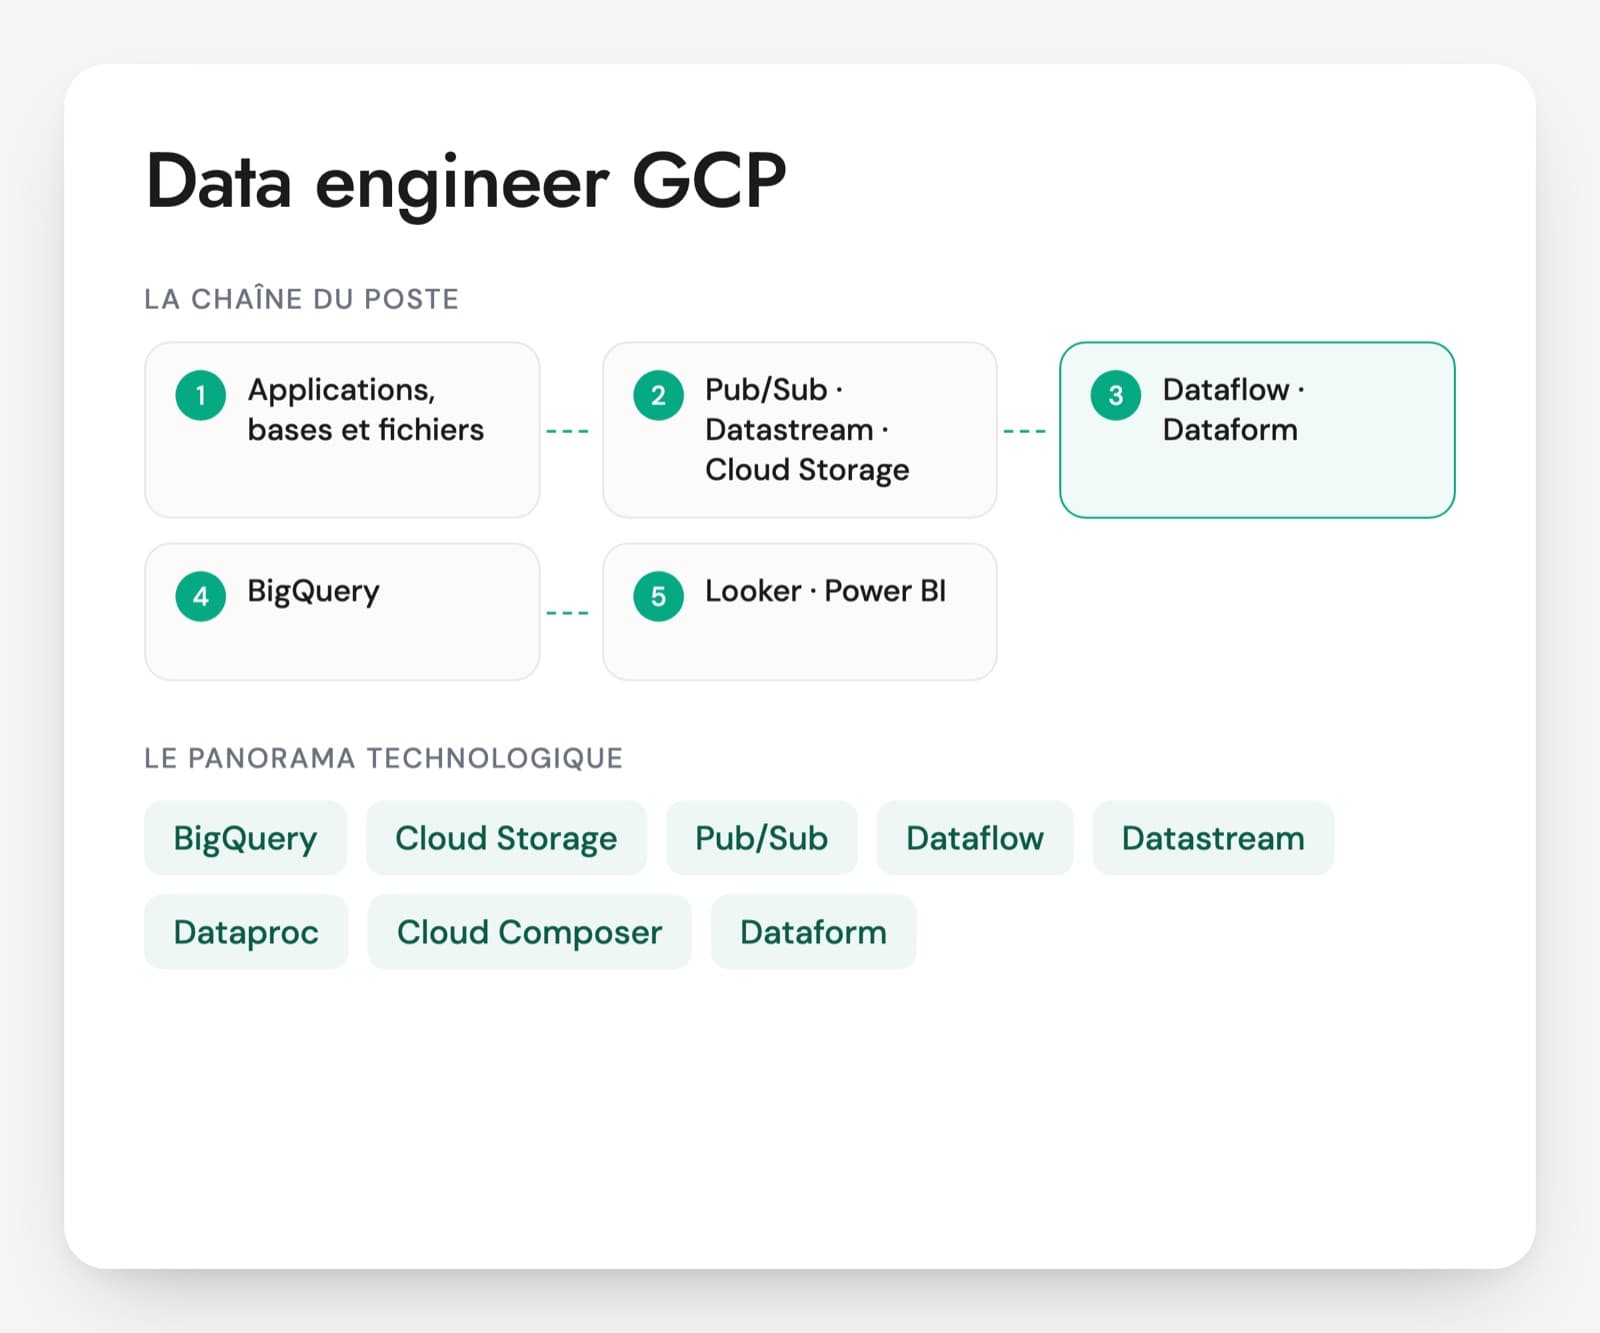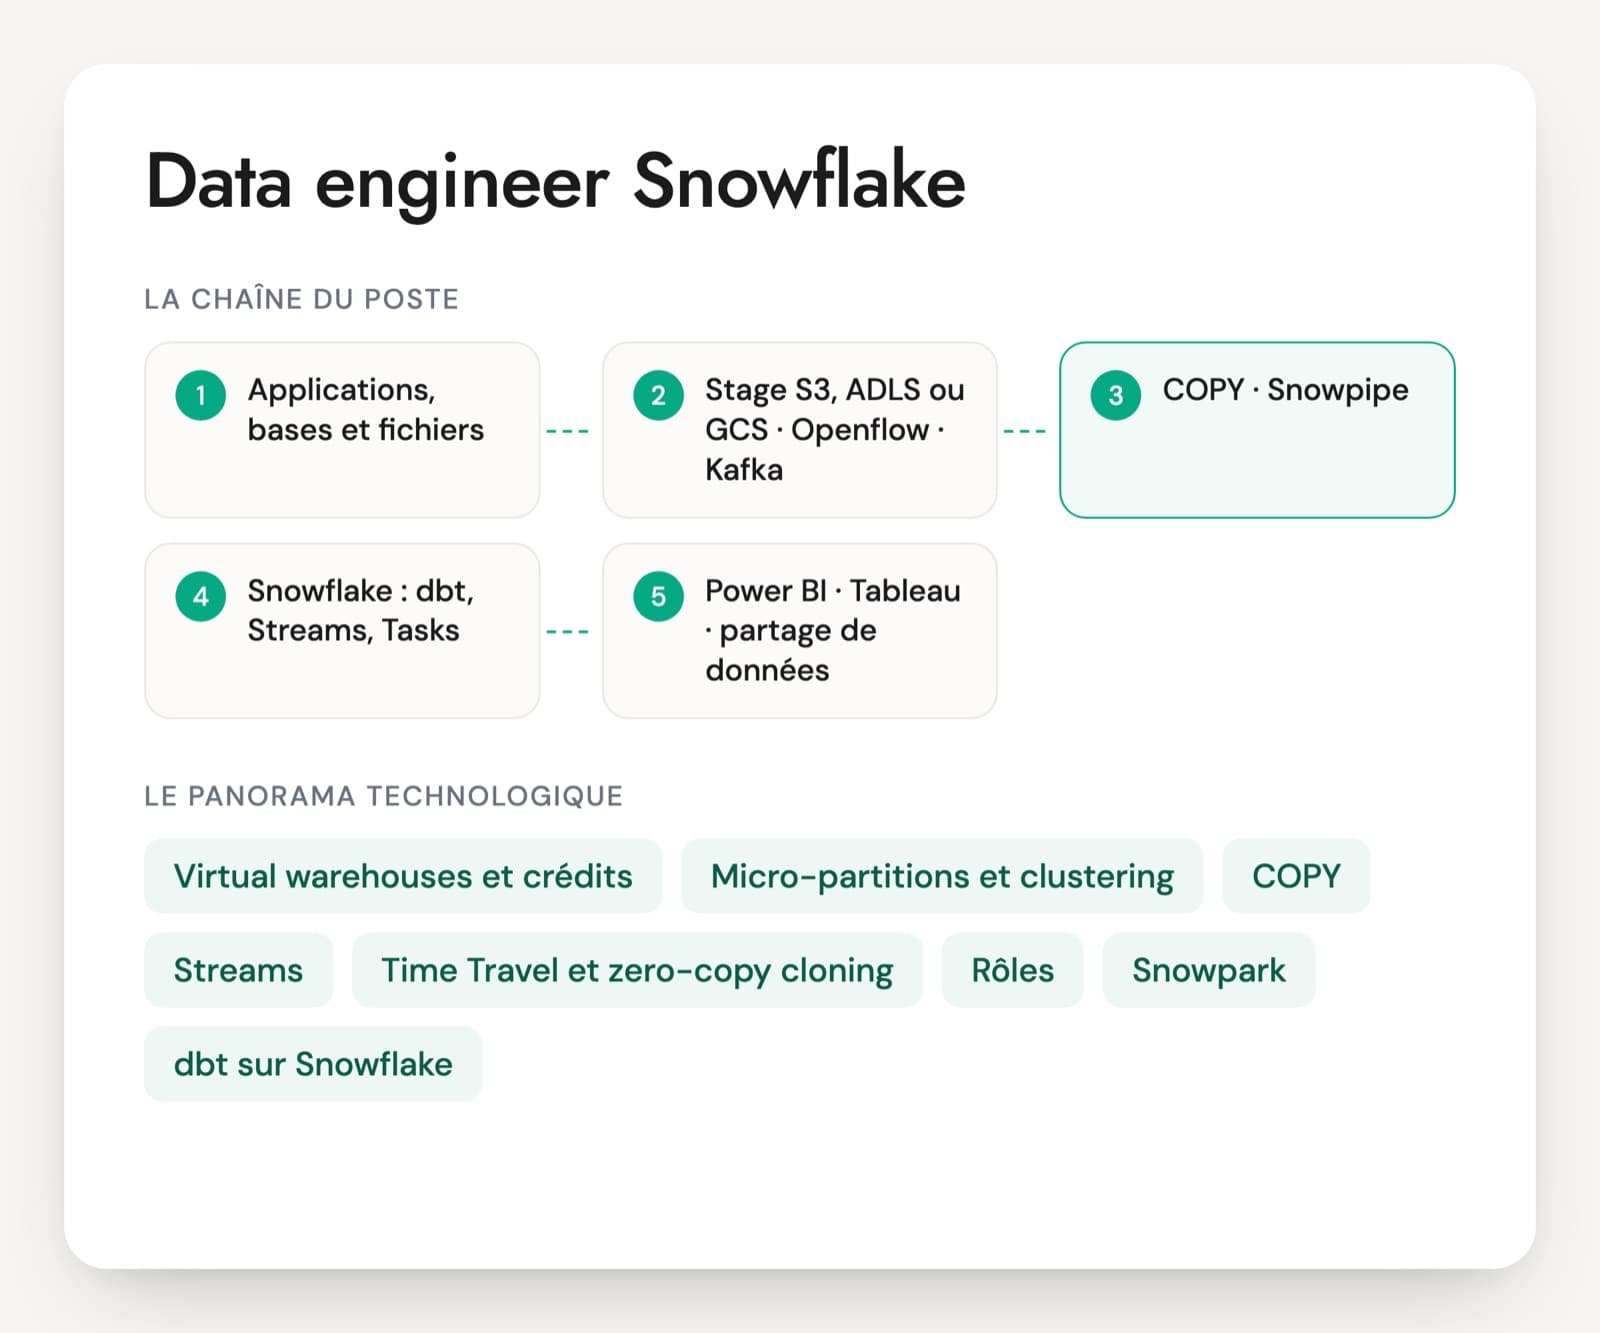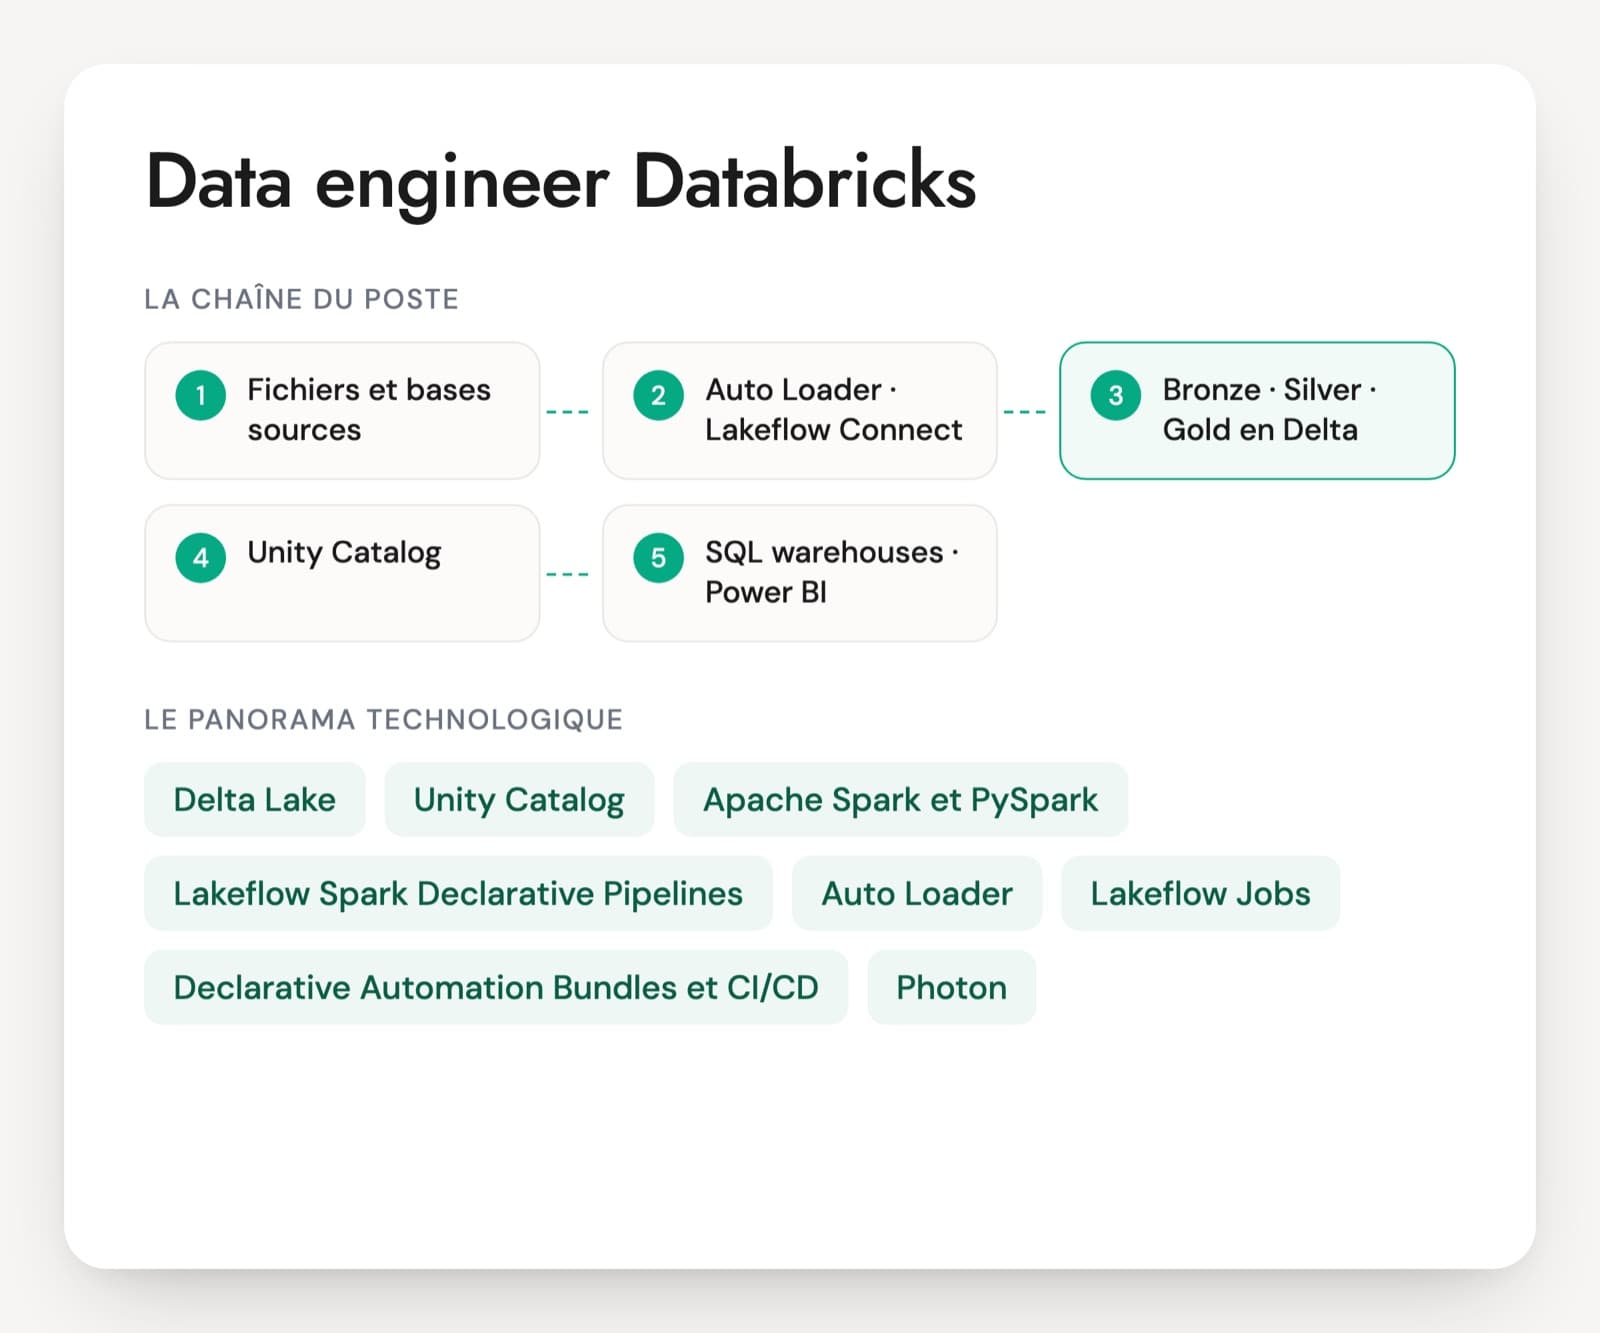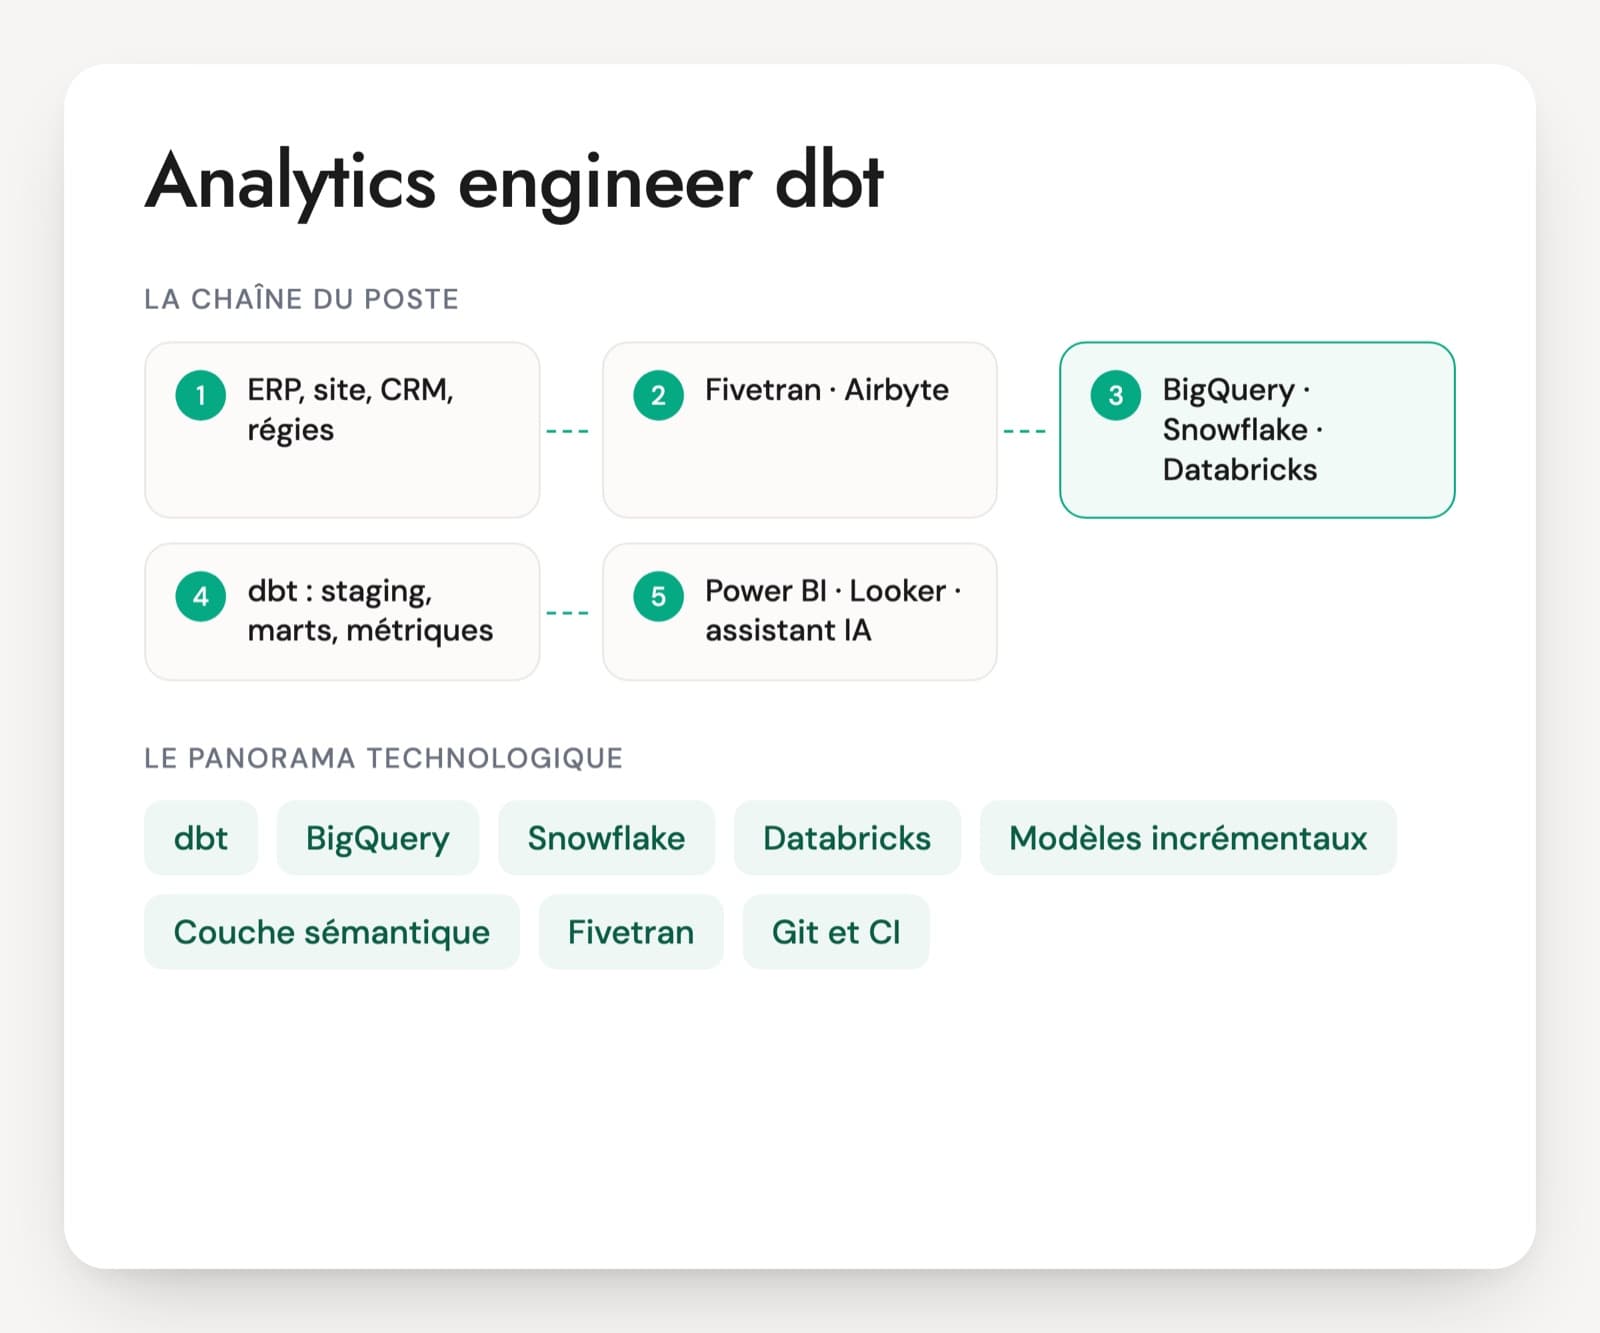
Un analytics engineer dbt se situe entre le data engineer qui amène les données et l'analyste qui construit les tableaux de bord. Il écrit les transformations en SQL versionné, organise le projet en couches, pose les tests et livre des tables prêtes à l'emploi, souvent aussi avec des métriques définies une fois pour toutes dans une couche sémantique. Les offres françaises l'associent à BigQuery, à Snowflake ou à Databricks, parfois à Dataform sur Google Cloud.
La difficulté, pour vous, vient de la proximité avec le métier d'analyste. Beaucoup de CV citent dbt après une formation ou un projet personnel. Ils savent écrire un modèle, moins souvent tenir un incrémental quand les données arrivent en retard, expliquer pourquoi un run coûte trois fois plus cher qu'il y a six mois ou pourquoi deux outils affichent deux chiffres d'affaires. L'entrepôt change la façon de facturer et d'organiser les tables, et un profil solide sait le dire pour le sien.
Le dernier projet dbt du candidat, décrit de mémoire, suffit souvent : nombre de modèles, couches, tests qui ont réellement bloqué une mise en production. Un profil qui a tenu un projet en équipe répond avec des chiffres. Côté PDF, le cas de 20 minutes porte sur le reporting d'une enseigne de mode en ligne.
dbt et son écosystème, vus depuis le recrutement
dbt
L'outil de transformation le plus répandu chez les analytics engineers. Chaque table se décrit dans un fichier SQL, dbt calcule l'ordre d'exécution, lance les tests et génère la documentation. Il existe en ligne de commande gratuite (dbt Core, et désormais un moteur réécrit en Rust) et en version hébergée, la dbt platform, anciennement dbt Cloud.
BigQuery
L'entrepôt de Google Cloud. En facturation à la demande, chaque requête se paie au volume lu, d'où l'importance du partitionnement par date et du clustering dans la configuration des modèles. Dataform, l'outil de transformation intégré à BigQuery, remplace parfois dbt : les notions se correspondent et un profil dbt s'y adapte vite.
Snowflake
L'entrepôt facturé en crédits, selon le temps pendant lequel les warehouses de calcul restent allumés et leur taille. Un analytics engineer y choisit le warehouse de ses runs, surveille la dépense par modèle et sait quand une clé de clustering vaut son coût. dbt peut aussi s'exécuter directement dans Snowflake (dbt Projects on Snowflake).
Databricks
La plateforme lakehouse, où dbt écrit des tables Delta et s'appuie sur Unity Catalog pour les droits. On la croise surtout quand l'entreprise fait aussi de la data science ou du Spark. Les notions de dbt restent les mêmes, seules l'organisation des tables et la facturation changent.
Modèles incrémentaux
Au lieu de recalculer une table entière chaque nuit, le modèle n'ajoute ou ne remplace que les données récentes. C'est la partie la plus délicate du poste : un filtre mal pensé oublie les lignes arrivées en retard ou double des commandes. Les questions de cette page y reviennent souvent.
Couche sémantique (semantic layer)
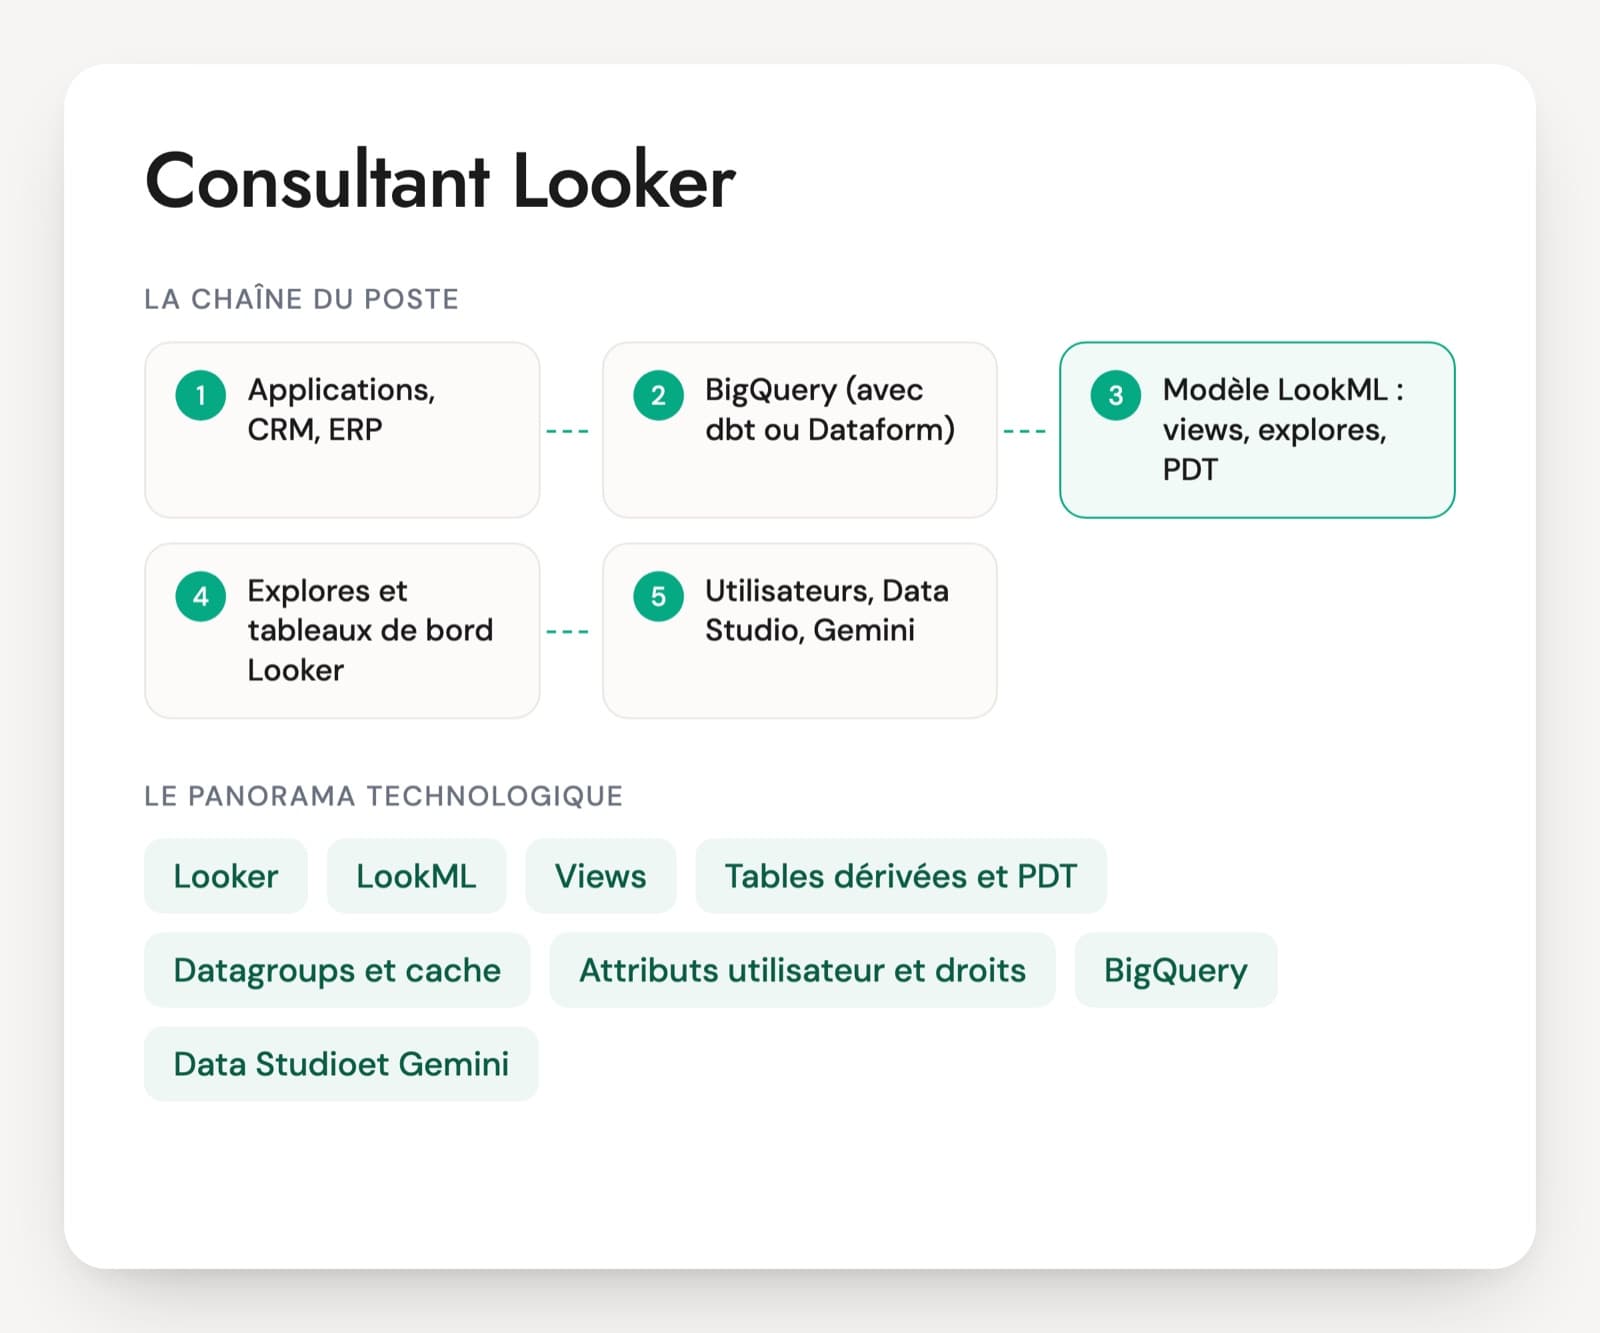
L'endroit où les indicateurs (chiffre d'affaires net, taux de conversion) sont définis une seule fois dans le code et servis à tous les outils. Côté dbt, c'est le dbt Semantic Layer, propulsé par MetricFlow. On trouve aussi LookML dans Looker, Cube, ou les semantic views de Snowflake. Les assistants IA interrogent désormais souvent ces métriques plutôt que les tables brutes.
Fivetran ou Airbyte
Les outils qui copient les données des applications (ERP, CRM, base du site, régies publicitaires) vers l'entrepôt. L'analytics engineer ne les administre pas toujours, mais il doit savoir quand les données arrivent, sous quelle forme et avec quels retards.
Git et CI
Le projet dbt vit dans un dépôt Git. Chaque modification passe par une merge request relue et une intégration continue qui construit et teste les modèles modifiés avant la production. Un analytics engineer confirmé travaille de cette façon par défaut.
Le poste n'a pas le même contenu selon la structure. Dans une scale-up ou chez un e-commerçant, l'analytics engineer tient souvent seul le projet dbt, de l'ingestion jusqu'au tableau de bord. Dans un grand groupe, il travaille sur un domaine (ventes, logistique, finance) au sein d'une plateforme gérée par des data engineers, avec des règles communes de nommage et de CI. En ESN ou en régie, la mission commence souvent par la reprise d'un projet existant écrit par d'autres. L'entrepôt varie d'une offre à l'autre et compte moins que la pratique de dbt, à condition que la personne sache comment le sien facture et range les données. La certification dbt Analytics Engineering existe, la pratique d'un projet en production se vérifie en entretien.
Les savoir-faire à contrôler chez un analytics engineer
- SQL avancé et modélisation dimensionnelle
- Structure et conventions d'un projet dbt
- Modèles incrémentaux et organisation des tables
- Coût et performance sur BigQuery, Snowflake ou Databricks
- Métriques et couche sémantique
- Tests, contrats et mise en production
Questions techniques pour un analytics engineer dbt
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Votre modèle dbt incrémental sur les commandes ne traite que les lignes plus récentes que le maximum déjà chargé. Des commandes modifiées trois jours plus tard n'apparaissent jamais. Que changez-vous ?
Une bonne réponseLe filtre sur le maximum rate tout ce qui arrive ou change en retard. La personne recharge une fenêtre glissante (les trois ou sept derniers jours) et laisse le merge sur l'identifiant de commande remplacer les lignes déjà présentes. Elle limite la lecture de la table cible, avec incremental_predicates sur Snowflake ou BigQuery, ou passe en insert_overwrite sur BigQuery pour remplacer les partitions touchées. La largeur de la fenêtre se déduit du retard réellement observé dans les données.
Signal d'alerte« Je relance en full refresh chaque nuit », sans voir le coût sur une table de plusieurs centaines de gigaoctets. Ou un merge sans unique_key, qui empile des doublons.
Question 2 · confirmé
Le run dbt de la nuit coûte de plus en plus cher. Comment trouvez-vous les modèles responsables ?
Une bonne réponseEn reliant chaque requête de l'entrepôt au modèle qui l'a lancée. Sur BigQuery, les labels de job posés par dbt et INFORMATION_SCHEMA.JOBS donnent les octets facturés par modèle. Sur Snowflake, un query_tag par modèle et QUERY_HISTORY donnent le temps de warehouse consommé. La personne trie, puis regarde le plus coûteux : table recalculée en entier alors qu'elle pourrait être incrémentale, merge qui relit toute la cible, filtre qui n'élague pas les partitions, vue empilée que chaque modèle aval recalcule.
Signal d'alerte« Je regarde la console et je devine », ou ne parler que de durée sans savoir comment l'entrepôt facture (volume lu sur BigQuery à la demande, temps de warehouse allumé sur Snowflake).
Question 3 · confirmé à senior
Le tableau de bord Power BI et l'assistant IA du marketing donnent deux chiffres d'affaires nets différents pour le même mois. Où définissez-vous ce chiffre pour qu'il soit le même partout ?
Une bonne réponseUne seule définition, dans le code, versionnée : une métrique de la couche sémantique (dbt Semantic Layer avec MetricFlow, LookML, Cube ou les semantic views de Snowflake selon la stack), avec ses filtres explicites (annulations, retours, taxes, devise, date de commande ou de facturation). Les outils et les agents interrogent cette métrique au lieu de recalculer le chiffre dans chaque rapport ou de générer leur propre SQL. La personne commence par retrouver d'où vient l'écart, puis fait valider la définition par le métier.
Signal d'alerteCorriger le chiffre à la main dans l'un des deux outils, ou ajouter une troisième formule dans un nouveau mart.
Question 4 · confirmé à senior
Vous reprenez un projet dbt de 150 modèles où chaque modèle lit directement les tables brutes. Comment le réorganisez-vous ?
Une bonne réponseLes tables brutes deviennent des sources, puis une couche staging avec un modèle par table source (renommage, typage, nettoyage, aucune jointure), une couche intermédiaire pour les jointures et règles métier réutilisées, et des marts orientés usage (faits et dimensions). La personne avance domaine par domaine, garde les anciens modèles le temps de comparer les chiffres et s'appuie sur le lineage pour savoir qui consomme quoi. Elle ajoute tests et descriptions au passage.
Signal d'alerteTout réécrire d'un coup sans comparer les résultats, ou garder des noms de tables écrits en dur dans le SQL.
Question 5 · junior à confirmé
Quels tests posez-vous sur une table de faits de ventes avant qu'elle alimente le reporting de la direction ?
Une bonne réponseUnicité et non-nullité de la clé au grain choisi, relationships vers les dimensions (pas de produit orphelin), accepted_values sur les statuts, fraîcheur des sources, et un test de volume ou d'écart par rapport aux jours précédents (dbt_utils, dbt_expectations ou un test singulier en SQL). La personne choisit ce qui bloque le pipeline (severity error) et ce qui alerte seulement (warn).
Signal d'alerte« Les tests unique et not_null partout », sans réfléchir au grain ni au coût des tests sur une grosse table. Ou aucun test qui bloque la publication.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Recruter un analytics engineer dbt : les points qui reviennent
Analytics engineer ou data engineer : lequel recruter ?
Le data engineer construit l'ingestion, l'infrastructure et les pipelines qui amènent les données dans l'entrepôt. L'analytics engineer part des tables brutes et produit des tables et des métriques fiables, documentées et testées pour les analystes, les tableaux de bord et les outils d'IA. Si vos données arrivent déjà via Fivetran ou Airbyte et que le besoin porte sur des indicateurs justes, c'est un analytics engineer qu'il vous faut. Si rien n'est encore branché, commencez par un data engineer.
Un profil dbt sur BigQuery peut-il prendre un poste sur Snowflake ?
Oui, si la pratique de dbt est solide : modèles, couches, tests et incrémental se transposent d'un entrepôt à l'autre. Ce qui change, c'est la facturation (volume lu sur BigQuery, crédits de warehouse sur Snowflake), l'organisation physique des tables et quelques stratégies incrémentales. Demandez au candidat comment il retrouverait le modèle le plus coûteux sur votre entrepôt. Une personne qui a compris le sien répond vite. Il en va de même entre dbt et Dataform.
Quel test technique proposer à un analytics engineer ?
Un exercice court sur de vraies structures donne plus d'informations qu'un QCM. Fournissez deux ou trois tables (commandes, lignes, clients) et demandez un modèle incrémental, ses tests et une métrique de chiffre d'affaires net. Une heure suffit. Faites ensuite commenter le travail en entretien : pourquoi ce grain, que devient une commande modifiée trois jours plus tard, combien coûtera le run sur votre entrepôt.
Faut-il exiger la maîtrise d'une couche sémantique ?
Cela dépend de votre stack. Si plusieurs outils lisent les mêmes indicateurs, ou si un assistant IA doit répondre à partir de vos données, la définition centralisée des métriques devient une part du poste, avec dbt Semantic Layer, LookML ou Cube. Pour un premier poste, la compréhension suffit : savoir pourquoi un ratio ne se moyenne pas et pourquoi deux rapports divergent. La pratique d'un outil précis s'apprend ensuite en quelques semaines.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.