Préparer des questions d'entretien pour un consultant Looker demande de séparer deux outils au nom proche. Looker, l'outil de BI de Google Cloud, repose sur LookML, un langage qui décrit une fois pour toutes les tables, les jointures et les indicateurs que les utilisateurs explorent ensuite sans écrire de SQL. Looker Studio, rebaptisé Data Studio en avril 2026, est un outil de tableaux de bord qui n'utilise pas LookML. En France, les offres viennent surtout de grands comptes et d'entreprises déjà installées sur BigQuery, souvent sous forme de missions freelance de plusieurs mois.
Le mot Looker recouvre donc, d'un CV à l'autre, des expériences éloignées. Des rapports faits dans Looker Studio ne préparent pas à écrire un modèle LookML. Côté Looker, beaucoup de profils ont surtout utilisé des explores conçus par d'autres. Le niveau s'entend quand la personne parle de relations de jointure, de lignes dupliquées par une jointure (fanout), de reconstruction d'une table dérivée ou de filtres d'accès liés aux attributs des utilisateurs.
Dès la préqualification, demandez si le candidat a écrit du LookML dans un dépôt Git avec revue de code : cette seule question écarte la plupart des profils Looker Studio. Les relances techniques viennent ensuite.
Le vocabulaire LookML expliqué à un recruteur
Looker (Google Cloud)
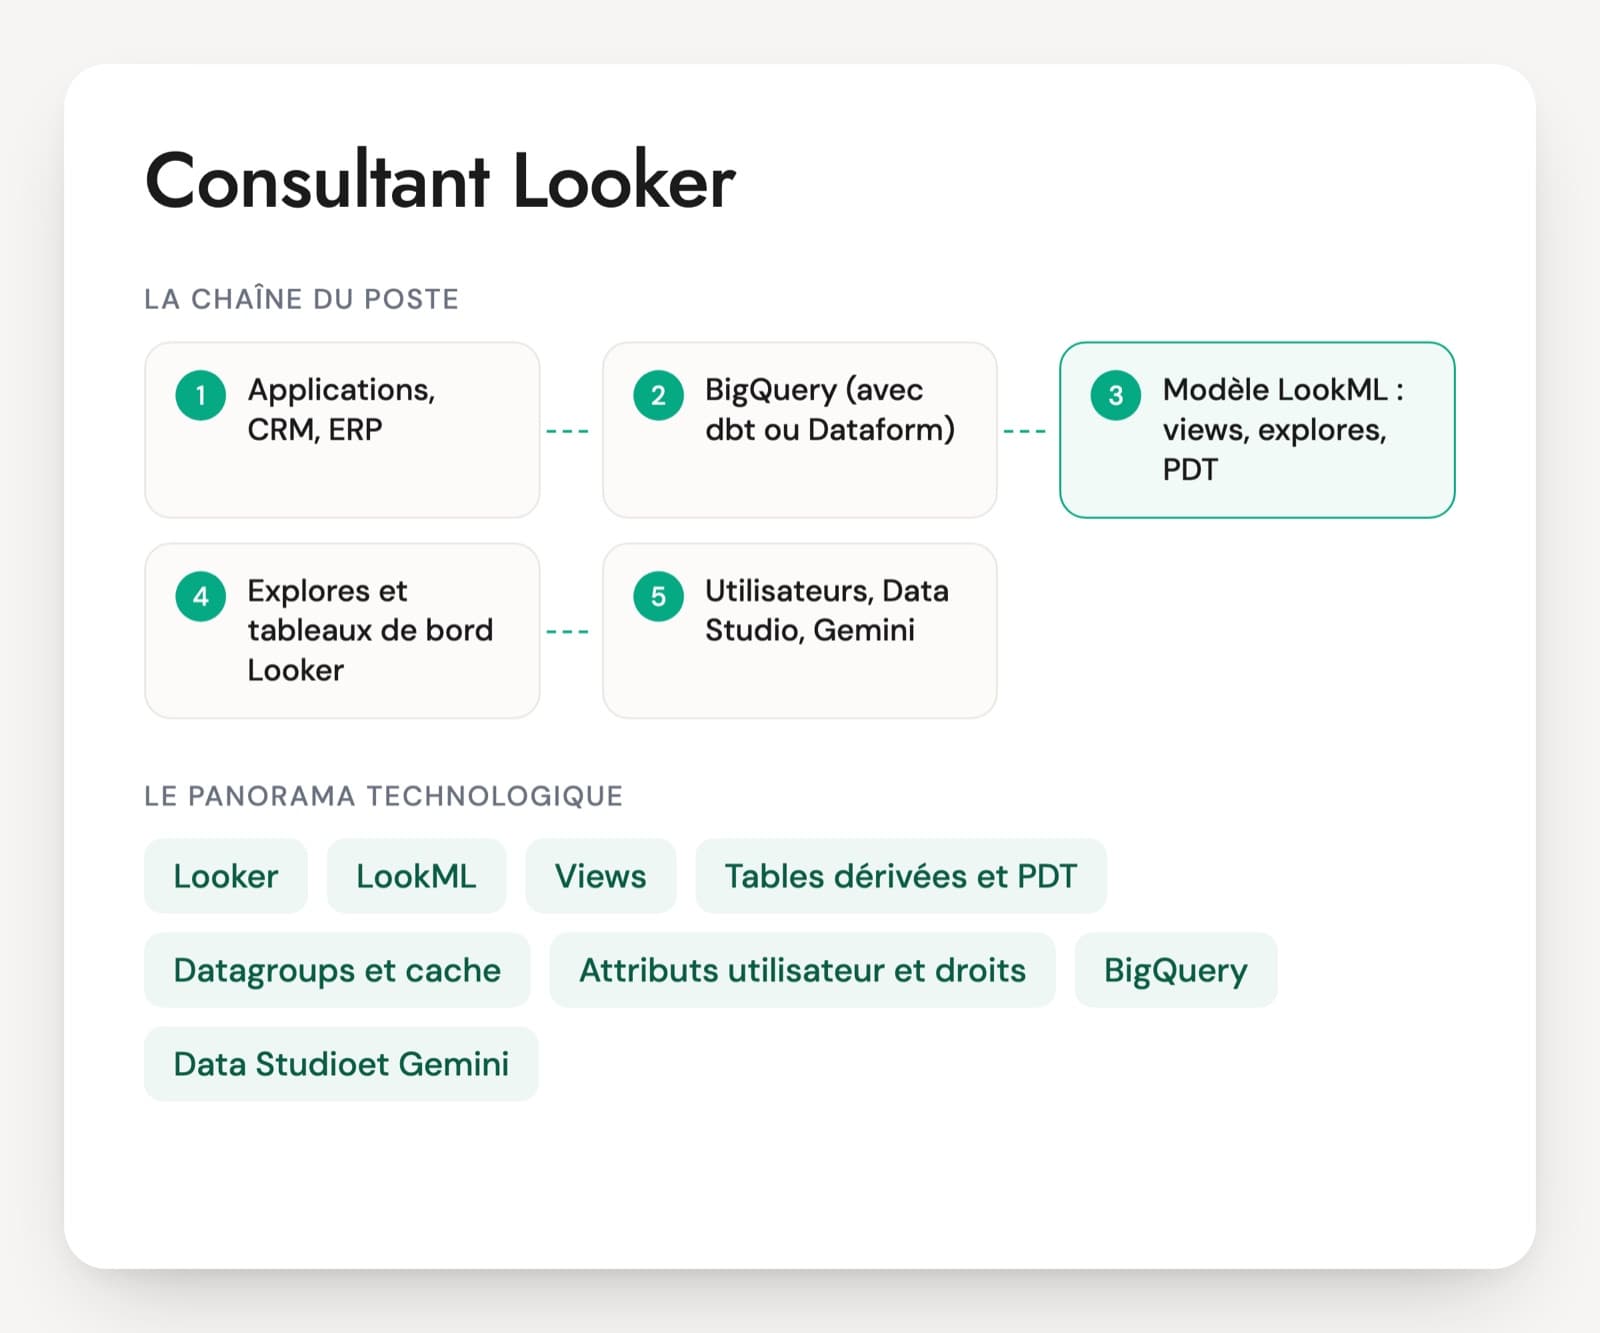
L'outil de BI de Google Cloud. Il ne stocke pas les données : chaque clic d'un utilisateur produit une requête SQL envoyée à la base, le plus souvent BigQuery. Il existe en version Looker (Google Cloud core), gérée depuis la console GCP, et en version d'origine, encore présente chez des clients plus anciens. Les deux se modélisent en LookML.
LookML
Le langage de modélisation de Looker, écrit dans des fichiers texte versionnés dans Git. Il décrit les tables, leurs champs, les jointures et les règles d'accès. Un indicateur défini une fois en LookML donne le même chiffre dans tous les tableaux de bord, ce qui fait de la qualité du modèle le cœur du poste.
Views, explores et models
Une view correspond à une table ou à une requête, avec ses dimensions et ses mesures. Un explore assemble plusieurs views par des jointures et devient l'espace où les utilisateurs posent leurs questions. Un model regroupe des explores et les relie à une connexion. Demandez comment la personne choisit la table de départ d'un explore.
Tables dérivées et PDT
Une table dérivée est une requête déclarée dans LookML et utilisée comme une table. Persistée (PDT), elle est écrite dans la base et reconstruite selon une règle, par exemple après le chargement de la nuit. Les PDT incrémentales n'ajoutent que les nouvelles données. Une PDT qui ne se reconstruit plus affiche des chiffres anciens sans aucun message d'erreur.
Datagroups et cache
Un datagroup fixe la durée de vie du cache et le moment où les PDT se reconstruisent, souvent à partir d'une requête qui détecte l'arrivée de nouvelles données. Bien réglé, il évite de relancer des requêtes BigQuery inutiles, donc de payer deux fois le même calcul.
Attributs utilisateur et droits
Looker attache à chaque utilisateur des attributs (région, filiale, client) que le modèle utilise pour filtrer les lignes avec access_filter ou pour réserver des champs avec access_grant. Les rôles combinent un jeu de permissions et un jeu de modèles. Masquer une tuile de tableau de bord ne suffit pas à protéger une donnée.
BigQuery
La base la plus fréquente derrière Looker dans les offres françaises, souvent avec dbt pour les transformations. Chaque requête générée par Looker est facturée par BigQuery, au volume lu ou sur une capacité réservée. Un consultant Looker sérieux lit le SQL produit et s'appuie sur le partitionnement et les tables d'agrégats pour que les tableaux de bord coûtent peu.
Data Studio (ex-Looker Studio) et Gemini
Data Studio, nom de Looker Studio depuis avril 2026, sert aux tableaux de bord en libre-service et peut se brancher sur un modèle Looker. Gemini in Looker et l'analyse conversationnelle répondent aux questions posées en langage naturel en s'appuyant sur la couche LookML. Leurs réponses ne valent que ce que vaut le modèle.
Le poste prend plusieurs formes. Dans l'équipe data d'un grand compte, le consultant Looker conçoit la couche sémantique, relit le LookML des autres et fixe les règles de développement. En mission plus courte, il reprend un modèle existant, corrige des chiffres contestés et accélère des tableaux de bord lents. Les offres associent souvent Looker à BigQuery, dbt, Airflow et une chaîne Git avec revue de code, parfois sur le cloud de confiance S3NS. Quand une entreprise expose des tableaux de bord à ses propres clients, l'intégration de Looker dans une application (embedding) et l'isolation des données entre clients entrent dans le périmètre. Les fonctions d'IA de Looker s'appuient sur le modèle LookML, qui reste le premier sujet à évaluer.
Où un consultant Looker doit faire ses preuves
- Modélisation LookML (views, explores)
- Jointures et agrégats justes
- Tables dérivées, PDT et cache
- Sécurité des données dans Looker
- Performance et coût sur BigQuery
- Git, tests et déploiement LookML
Cinq questions sur le LookML d'un consultant Looker
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Dans un explore commandes, l'ajout de la vue des lignes de commande fait doubler le chiffre d'affaires des commandes. Que s'est-il passé, et comment le corrigez-vous ?
Une bonne réponseLa jointure vers les lignes est un un-à-plusieurs : chaque commande est répétée autant de fois qu'elle a de lignes, c'est le fanout. La correction passe par le bon paramètre relationship sur la jointure et une primary_key sur chaque vue. Looker applique alors les agrégats symétriques, qui recalculent la somme sans compter deux fois la même commande. Selon le besoin, la mesure peut aussi être calculée au grain des lignes. La personne vérifie le SQL généré.
Signal d'alerteDéclarer la relation en one_to_one pour faire disparaître le problème, ou corriger le chiffre par un filtre dans le tableau de bord.
Question 2 · confirmé
Un tableau de bord affiche encore les ventes d'avant-hier alors que BigQuery est à jour. Il repose sur une PDT. Où cherchez-vous ?
Une bonne réponseD'abord le datagroup qui pilote la PDT : il vérifie que sa requête sql_trigger renvoie une valeur qui change vraiment après le chargement. Ensuite la page d'administration des PDT et leurs journaux, pour voir si la reconstruction a échoué (droits sur le schéma de travail, requête en erreur, délai dépassé). Puis la durée de cache (max_cache_age). La correction : un déclencheur fondé sur l'horodatage de fin de chargement, une reconstruction forcée et une alerte sur les échecs.
Signal d'alerteVider le cache sans chercher la cause, ou désactiver tout le cache de l'instance.
Question 3 · senior
Vos clients consultent un tableau de bord Looker intégré à votre application. Comment garantissez-vous qu'un client ne voit jamais les données d'un autre ?
Une bonne réponseChaque utilisateur intégré reçoit un attribut client_id, transmis dans l'URL signée de l'intégration (signed embedding). Les explores portent un access_filter sur le champ client, ou un sql_always_where qui lit l'attribut. Les jeux de modèles limitent ce que ces utilisateurs peuvent ouvrir. La personne teste avec plusieurs comptes et l'option de connexion en tant qu'utilisateur (sudo), et ne s'appuie jamais sur un filtre de tableau de bord que l'utilisateur pourrait modifier.
Signal d'alerteUn filtre de tableau de bord verrouillé ou masqué comme seule protection, ou un tableau de bord copié par client.
Question 4 · confirmé
Deux tableaux de bord affichent deux chiffres d'affaires différents pour le même mois. Comment réglez-vous le problème dans le modèle ?
Une bonne réponseRemonter chaque tuile jusqu'à son explore, son champ et son SQL : champ personnalisé, calcul de tableau, filtres différents ou deux mesures définies différemment dans deux vues. Puis une seule mesure documentée dans le modèle, avec ses règles (statut des commandes, taxes, avoirs), et le retrait des doublons. Après un renommage, le Content Validator repère les tuiles cassées.
Signal d'alerteModifier l'un des tableaux de bord pour qu'il colle à l'autre, sans corriger la définition dans LookML.
Question 5 · senior
Un tableau de bord de vingt tuiles met une minute à charger et coûte cher en BigQuery. Que faites-vous ?
Une bonne réponseMesurer d'abord : historique des requêtes dans System Activity, volume lu et durée dans BigQuery. Ensuite imposer un filtre sur la date de partition (always_filter, ou require_partition_filter côté BigQuery), créer des tables d'agrégats que Looker utilise automatiquement (aggregate awareness), régler le cache par datagroup et réduire le nombre de tuiles ou de requêtes distinctes. La personne vérifie que la dimension de date filtrée correspond bien à la colonne de partition.
Signal d'alerte« On achète plus de slots BigQuery » sans regarder quelles requêtes coûtent.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Ce que les recruteurs demandent sur le profil de consultant Looker
Looker et Looker Studio, est-ce la même compétence ?
Non. Looker repose sur LookML, un langage de modélisation versionné dans Git, et demande de concevoir des jointures, des mesures et des règles d'accès. Looker Studio, renommé Data Studio en avril 2026, sert à monter des tableaux de bord sur des sources variées, sans couche LookML. Un CV qui cite Looker Studio peut donc venir du marketing digital et n'avoir jamais écrit de modèle. Demandez à la personne de décrire un explore qu'elle a construit et les relations de ses jointures.
Faut-il exiger BigQuery en plus de Looker ?
Dans la plupart des offres françaises, oui, car Looker y tourne sur BigQuery. Looker n'exécute rien lui-même : il génère du SQL que BigQuery facture. Un consultant qui ignore le partitionnement, le volume lu par une requête ou le rôle d'une table d'agrégats peut livrer un modèle juste mais coûteux. Sur un autre entrepôt, comme Snowflake ou Redshift, la logique reste la même. Vérifiez que la personne sait lire le SQL généré et dire ce qu'il coûte.
À quoi ressemble un bon test technique pour un consultant Looker ?
Un petit projet LookML suffit : trois tables (commandes, lignes de commande, clients) et une consigne pour construire l'explore et une mesure de chiffre d'affaires. L'exercice révèle tout de suite si la personne déclare les relations, pose des clés primaires et repère le risque de fanout. Ajoutez une question sur la restriction d'accès par région. Faites-le en direct, avec partage d'écran, pour suivre son raisonnement plutôt que de récupérer un fichier rendu.
Qu'est-ce qui change pour un profil Power BI qui arrive sur Looker ?
La logique de couche sémantique est familière, mais l'outil s'utilise autrement. Le modèle s'écrit en code dans des fichiers LookML, passe par des branches Git et une revue avant la production. Les données ne sont pas importées en mémoire : chaque requête part vers la base. Les calculs ne s'écrivent pas en DAX mais en SQL dans les mesures LookML. En entretien, testez surtout les jointures et le fanout, qui n'existent pas sous cette forme dans Power BI.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.