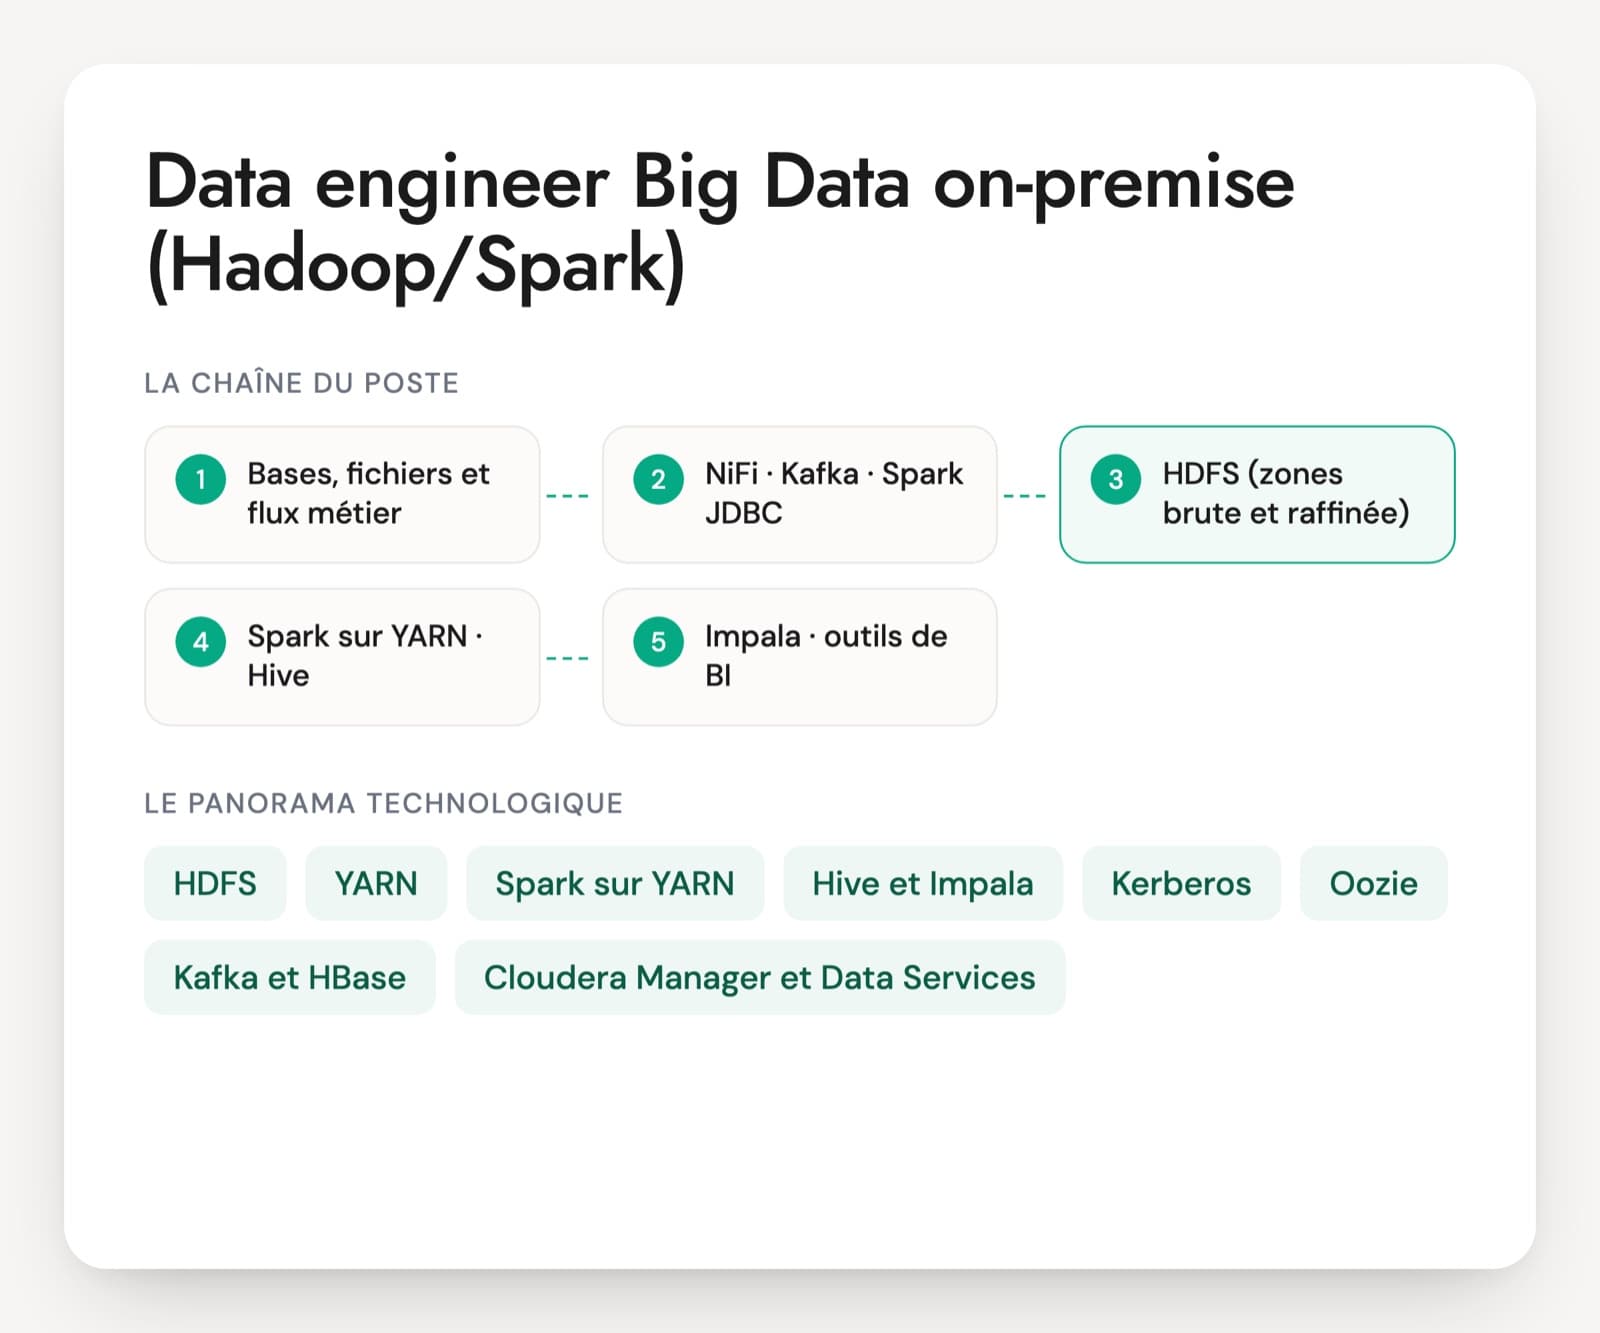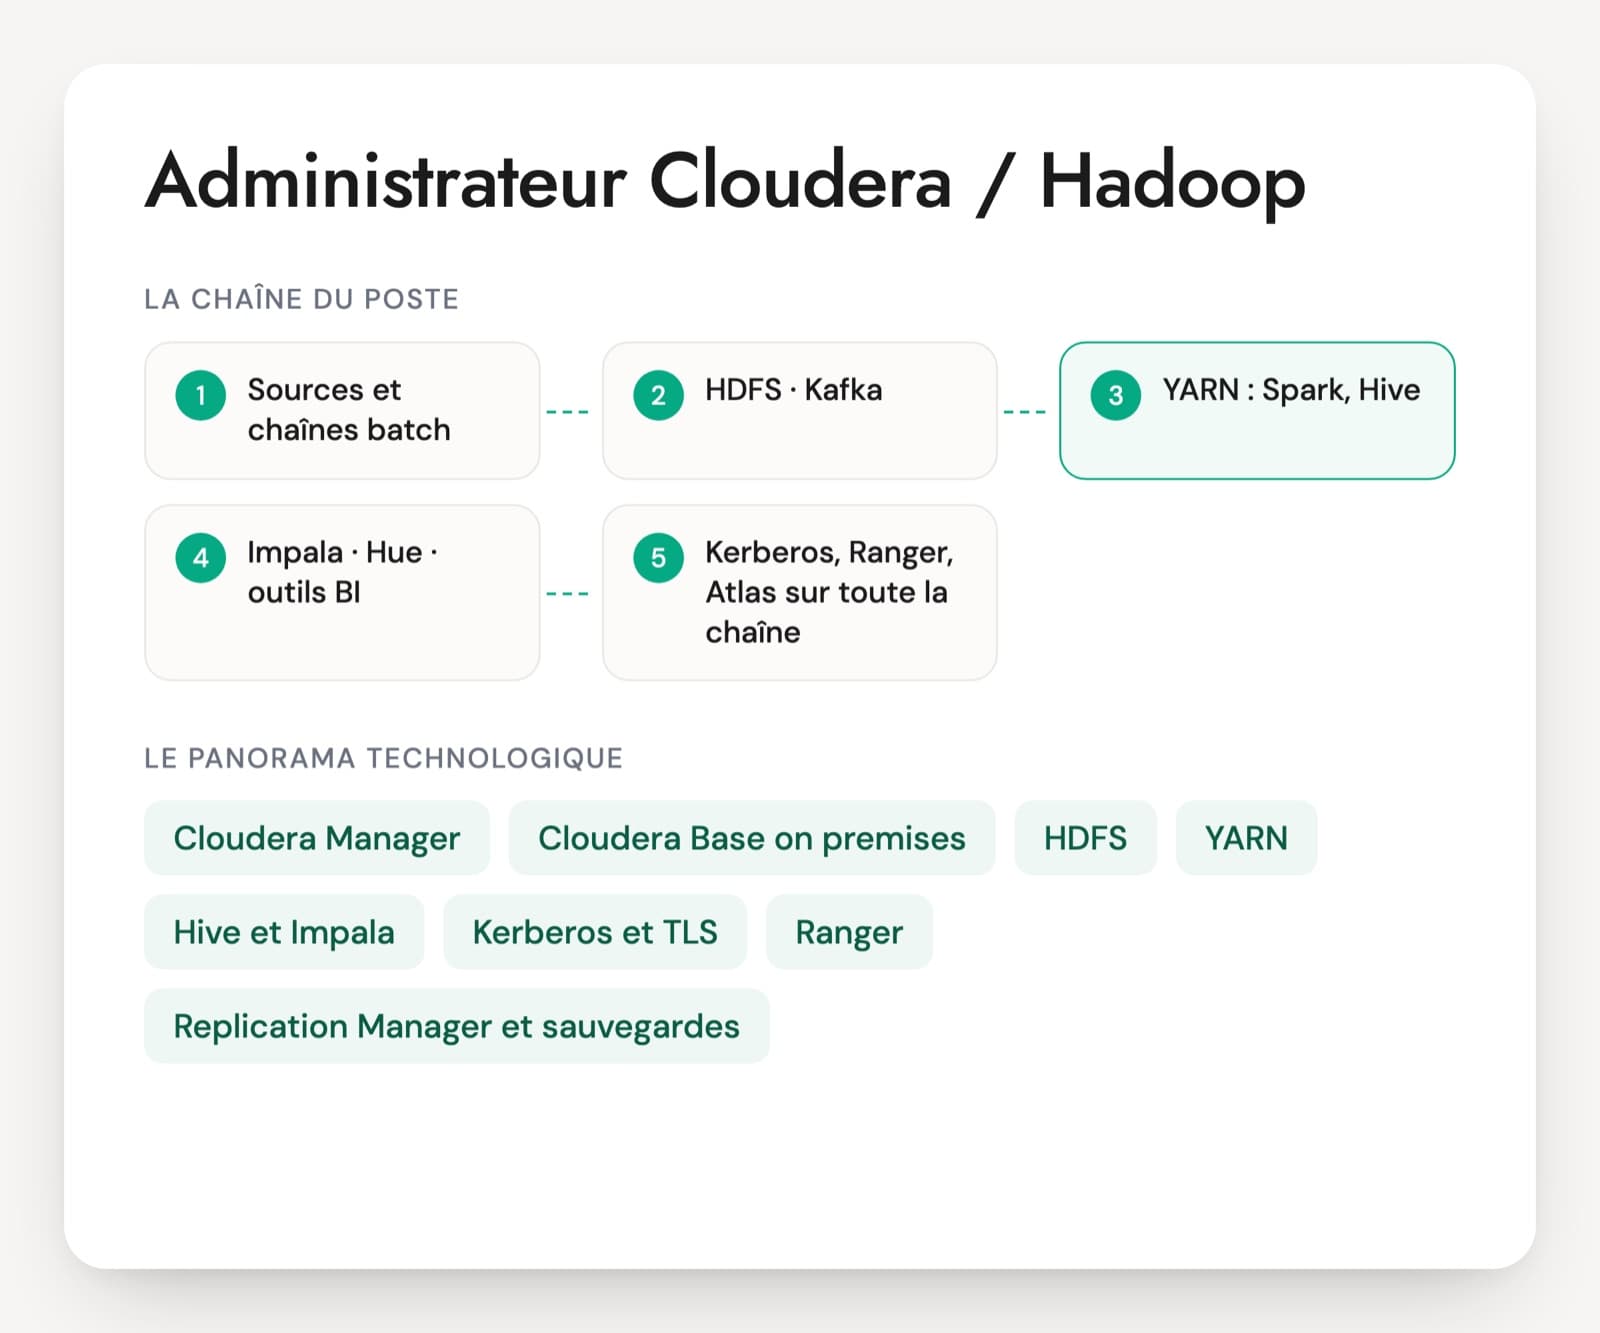
Les missions d'administrateur Cloudera se concentrent chez les assureurs, les mutuelles, les banques et les opérateurs qui gardent leurs données dans leurs datacenters. Sur Free-Work, les intitulés varient (expert data platform Cloudera, administrateur big data N3, tech lead Cloudera), mais le contenu se ressemble : maintien en condition opérationnelle du cluster, support de niveau 3, cellules de crise, montées de version de CDP et automatisation avec Ansible ou AWX.
Sur un CV, Hadoop, Hive ou Spark ne distinguent pas un administrateur d'un data engineer qui a utilisé le cluster. L'expérience d'exploitation s'entend quand la personne explique la bascule d'un NameNode, lit une erreur Kerberos, règle les pools d'Impala ou raconte une montée de version avec son retour arrière. Le passage de CDH à CDP, avec Sentry remplacé par Ranger et l'arrivée de Hive 3, reste le sujet qui révèle le mieux le niveau.
La taille du cluster, la version de CDP en place et la présence d'astreintes fixent le niveau attendu. Un candidat qui a mené une montée de version raconte la préparation, le retour arrière prévu et ce qui a cassé le lendemain. Le cas pratique du PDF part d'un cluster CDH 6 d'assureur à migrer.
Les composants d'un cluster Cloudera qu'un administrateur exploite
Cloudera Manager
La console d'administration du cluster. On y installe les composants sous forme de parcels, on change la configuration, on redémarre les services nœud par nœud et on suit les tests de santé. Elle a aussi une API REST pour automatiser. Un administrateur y passe ses journées, c'est le premier sujet à aborder.
Cloudera Base on premises (CDP)
La distribution Hadoop de Cloudera pour les datacenters, appelée longtemps CDP Private Cloud Base, en version 7.3 dans la documentation actuelle. Elle remplace CDH et HDP, qui ne sont plus supportés. Beaucoup de missions portent encore sur la migration depuis CDH.
HDFS
Le système de fichiers distribué du cluster. Le NameNode garde la carte des fichiers, les DataNodes stockent les blocs, chacun copié trois fois par défaut. En production, deux NameNodes fonctionnent en haute disponibilité avec des JournalNodes et ZooKeeper. Vérifiez que la personne sait ce qui se passe quand l'un d'eux tombe.
YARN
Le gestionnaire de ressources. Il attribue la mémoire et les cœurs aux traitements Spark, Hive ou MapReduce, répartis dans des files par équipe. Sur CDP, le Capacity Scheduler a remplacé le Fair Scheduler de CDH, ce qui oblige à revoir les files lors d'une migration.
Hive et Impala
Deux moteurs SQL sur les données de HDFS. Hive sert aux traitements batch, Impala aux requêtes interactives des outils BI. Leur metastore commun repose sur une base de données à sauvegarder. Sur Impala, l'administrateur règle l'admission control pour qu'une requête lourde ne fasse pas tomber les autres.
Kerberos et TLS
Kerberos authentifie chaque utilisateur et chaque service du cluster, le plus souvent adossé à l'Active Directory. Les traitements automatiques utilisent des keytabs, des fichiers d'identification à protéger. TLS chiffre les échanges, et Cloudera Manager sait générer les certificats (Auto-TLS). Les erreurs Kerberos sont le quotidien du support N3.
Ranger, Atlas et Knox
Ranger gère les droits d'accès aux tables, fichiers et sujets Kafka, avec masquage de colonnes et audit. Atlas tient le catalogue et le lignage, et ses classifications pilotent des politiques Ranger. Knox sert de passerelle pour exposer les services hors du réseau du cluster.
Replication Manager et sauvegardes
Replication Manager copie les données HDFS et les tables Hive vers un autre cluster, souvent celui du site de secours, en s'appuyant sur les snapshots. Le plan de reprise couvre aussi les bases de Cloudera Manager, du metastore et de Ranger, qui vivent hors de HDFS.
Linux, Ansible et AWX
Le cluster tourne le plus souvent sur Red Hat Enterprise Linux. L'administrateur prépare les nœuds (horloge, DNS, limites système, disques) et automatise avec Ansible, souvent piloté par AWX dans les offres françaises. Un bon niveau Linux est indispensable pour diagnostiquer.
Les missions relevées se situent surtout dans l'assurance et la mutualité, la banque et les télécoms, souvent en ESN ou en régie pour plusieurs années, avec du support N3, des cellules de crise et des interventions ponctuelles en heures non ouvrées. Le poste recouvre le maintien en condition opérationnelle, les montées de version de CDP, la sécurité (Kerberos, Ranger, TLS) et l'automatisation. Certaines offres ajoutent Kafka, Solr, NiFi ou OpenShift. Le profil diffère du data engineer Hadoop, qui développe les traitements sur le cluster : l'administrateur garantit que le cluster tient, qu'il est sûr et qu'il peut être mis à jour sans perte.
Les compétences d'exploitation à faire démontrer
- Exploitation avec Cloudera Manager
- HDFS et haute disponibilité
- YARN, Impala et capacity planning
- Kerberos, TLS et Ranger
- Montées de version et migration CDH vers CDP
- Linux, supervision, sauvegarde et PRA
Administrateur Cloudera : cinq questions tirées du quotidien de production
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Un matin, tous les jobs d'une équipe échouent avec « GSS initiate failed ». Que vérifiez-vous, et dans quel ordre ?
Une bonne réponseD'abord le ticket : klist sur le cache ou sur le keytab utilisé, sa date d'expiration et sa durée de renouvellement. Puis l'écart d'horloge entre le nœud et le KDC (chrony, cinq minutes de tolérance par défaut), un keytab périmé après un changement de mot de passe du principal (numéro de version kvno différent), la résolution DNS directe et inverse du nom d'hôte inscrit dans le principal, les types de chiffrement acceptés (AES plutôt que RC4) et l'accès réseau au KDC ou à l'Active Directory. La personne active le débogage Kerberos côté client pour lire l'échange.
Signal d'alerteDésactiver Kerberos « pour tester », ou régénérer tous les keytabs du cluster sans avoir trouvé la cause.
Question 2 · confirmé
Le NameNode actif tombe en pleine journée. Que doit-il se passer si le cluster est bien configuré, et que vérifiez-vous ensuite ?
Une bonne réponseAvec la haute disponibilité, le NameNode de secours prend la main : les JournalNodes (au moins trois) partagent le journal des modifications, et le ZKFC, appuyé sur ZooKeeper, déclenche la bascule avec isolation de l'ancien actif (fencing). La personne vérifie l'état des deux instances (hdfs haadmin -getServiceState ou Cloudera Manager), cherche la cause dans les journaux, souvent une longue pause du ramasse-miettes Java sur un tas trop petit pour le nombre de fichiers, puis redémarre l'ancien actif en secours et contrôle les checkpoints.
Signal d'alerte« Le Secondary NameNode prend le relais. » Ou aucune idée de ce qu'est un JournalNode.
Question 3 · senior
On vous confie la migration d'un cluster CDH 6 vers Cloudera Base on premises (anciennement CDP Private Cloud Base). Quelles sont les grandes étapes, et où sont les pièges ?
Une bonne réponseUn inventaire des services, des versions et des usages, puis la vérification des prérequis dans la matrice de support (système, JDK, base de Cloudera Manager). Le choix entre montée en place et nouveau cluster alimenté par Replication Manager. Cloudera Manager est mis à jour avant le runtime. Les pièges connus : Sentry remplacé par Ranger, Navigator par Atlas, le passage à Hive 3 où les tables managées deviennent transactionnelles (ACID), le Fair Scheduler converti en Capacity Scheduler, et des composants retirés comme Flume ou Pig. Le tout répété en préproduction, avec sauvegardes et retour arrière préparés.
Signal d'alerte« On clique sur Upgrade dans Cloudera Manager », sans inventaire, sans répétition et sans parler de Hive 3 ni de Sentry.
Question 4 · confirmé
Des requêtes Impala lancées depuis les outils BI saturent la mémoire et font échouer celles des autres. Quels réglages posez-vous ?
Une bonne réponseL'admission control avec des pools de ressources par groupe d'utilisateurs : mémoire maximale du pool, nombre de requêtes simultanées, file d'attente et délai d'expiration, limite de mémoire par requête par défaut. Des statistiques à jour (COMPUTE STATS) pour que le planificateur estime bien les volumes. La personne suit les requêtes dans Cloudera Manager et peut séparer coordinateurs et exécuteurs sur un gros cluster.
Signal d'alerte« On ajoute de la RAM », ou redémarrer les démons Impala à chaque saturation.
Question 5 · confirmé
Vous devez changer un paramètre HDFS sur un cluster de production de 80 nœuds. Comment procédez-vous depuis Cloudera Manager ?
Une bonne réponseLa modification se fait dans Cloudera Manager, au bon niveau (service entier ou groupe de rôles), après test en préproduction et dans le cadre d'un changement validé. Cloudera Manager signale la configuration obsolète sur les rôles concernés et montre l'écart. Le redémarrage se fait en rolling restart, possible grâce à la haute disponibilité, puis la personne contrôle les tests de santé. L'historique des configurations permet de revenir en arrière.
Signal d'alerteModifier hdfs-site.xml à la main sur les nœuds, alors que Cloudera Manager écrase ces fichiers au redémarrage suivant.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Recruter un administrateur Hadoop : les points qui reviennent
Administrateur Cloudera, administrateur Hadoop, expert data platform : que recouvrent ces intitulés ?
Le plus souvent, le même métier : exploiter un cluster Hadoop, aujourd'hui presque toujours sous distribution Cloudera. « Administrateur Hadoop » reste l'intitulé générique, « expert data platform Cloudera » ou « ingénieur DataOps N3 » apparaissent dans les offres d'ESN. Regardez surtout le niveau de support attendu (N2 ou N3), la présence d'une montée de version dans la mission et les composants annexes comme Kafka, Solr ou NiFi, qui changent le profil recherché.
Quel niveau Linux demander à un administrateur Hadoop ?
Un niveau d'administrateur système confirmé sur Red Hat. Il doit lire les journaux, diagnostiquer un disque, la mémoire ou le réseau, comprendre DNS et la synchronisation d'horloge, deux causes fréquentes d'erreurs Kerberos, et écrire des scripts shell et des playbooks Ansible. En entretien, demandez quels réglages système il vérifie avant d'intégrer un nœud : la réponse montre vite s'il a monté des clusters ou seulement utilisé un cluster existant.
Quelle place donner aux certifications Cloudera dans la sélection ?
Cloudera propose des examens, dont un pour l'administration de CDP, et une certification Red Hat valide la partie Linux. Ces titres montrent un socle de connaissances. Ils ne remplacent pas le récit d'une montée de version, d'une crise de production ou d'une kerbérisation. Pour un poste N3, une certification ancienne sur CDH n'empêche rien, à condition que la personne parle de Ranger, de Hive 3 et du Capacity Scheduler.
Sur quoi faire porter le test technique d'un administrateur Cloudera ?
Sur des traces réelles plutôt que sur un cluster à installer. Montrez une sortie de hdfs fsck, une erreur Kerberos complète, une capture des tests de santé de Cloudera Manager ou une requête Impala refusée par l'admission control, et demandez un diagnostic à voix haute. En trente minutes, vous voyez la méthode, l'ordre des vérifications et la connaissance des commandes. Gardez le cas de migration du PDF pour le second entretien.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.