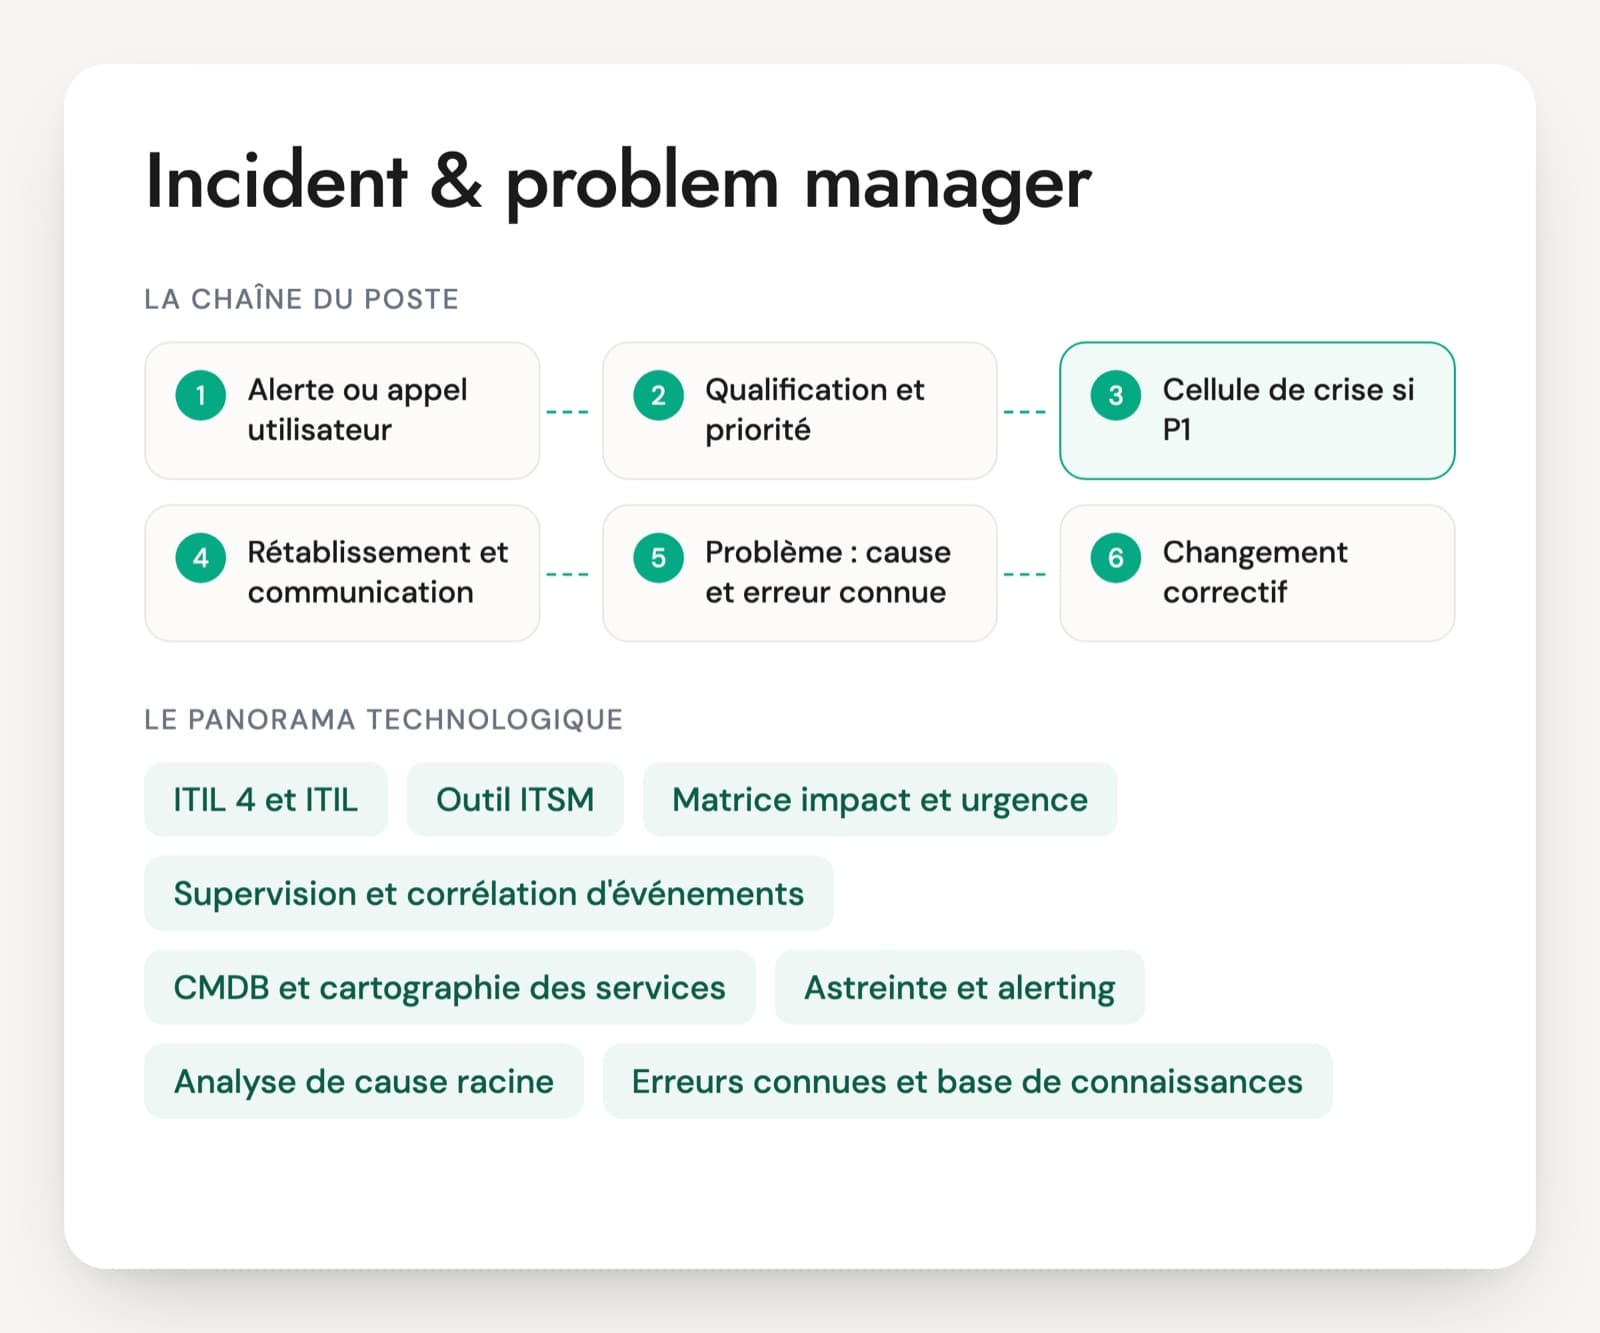
Un incident manager se juge sur les quinze premières minutes d'un incident majeur. Il déclare la crise, ouvre le pont, répartit les rôles, vérifie les changements de la veille et envoie un premier message aux métiers avant d'avoir la cause. Les questions d'entretien d'incident manager partent de là. Beaucoup d'offres fusionnent aujourd'hui incident et problem management : la même personne mène ensuite l'analyse de cause, rédige l'erreur connue et pousse le correctif en gestion des changements.
La certification ITIL 4 Foundation figure sur presque tous les CV et ne dit rien de la tenue d'une crise. Un profil réellement passé par des P1 raconte une chronologie datée, cite les outils consultés (ServiceNow, supervision, CMDB) et sépare le rétablissement de la recherche de cause. Un profil théorique récite la définition d'un incident et décrit un post-mortem où l'on cherche un coupable.
Le poste n'exige pas d'être expert système, mais il faut lire une alerte, comprendre une dépendance réseau ou base de données et poser la bonne question à l'astreinte. Le candidat raconte un incident vécu de bout en bout, avec les actions qui ont suivi. Le PDF ajoute un cas de 20 minutes sur une application en panne un samedi matin.
Les outils et repères d'un incident & problem manager
ITIL 4 et ITIL (Version 5)
ITIL 4 décrit la gestion des incidents et la gestion des problèmes comme deux pratiques distinctes, avec des certifications Practitioner dédiées. PeopleCert a publié début 2026 ITIL (Version 5), qui coexiste avec ITIL 4 et met l'accent sur les produits et services numériques et la gouvernance de l'IA. Les deux versions partagent le vocabulaire du métier : incident, problème, erreur connue, contournement.
Outil ITSM
ServiceNow, Jira Service Management, EasyVista ou BMC Helix portent les tickets, la matrice de priorité et les liens entre incident, problème et changement. Les plus répandus ont un module dédié aux incidents majeurs. La personne doit savoir rattacher des incidents enfants à un incident parent et sortir une chronologie de l'outil.
Matrice impact et urgence, SLA et OLA
La priorité se calcule à partir de l'impact (combien d'utilisateurs, quel service) et de l'urgence. Les SLA fixent les délais promis aux utilisateurs, les OLA ceux que les équipes internes se doivent entre elles. Un bon incident manager sait comment un indicateur de SLA peut être tenu sur le papier pendant que les utilisateurs souffrent.
Supervision et corrélation d'événements
Dynatrace, Datadog, Centreon, Zabbix ou Splunk envoient les alertes qui ouvrent une grande partie des incidents. Pendant une crise, des centaines d'alertes arrivent en même temps. Il faut trouver la première, celle qui explique les autres, et c'est là que la corrélation et la cartographie des services servent.
CMDB et cartographie des services
La base de gestion des configurations relie un service métier aux serveurs, bases, réseaux et équipes qui le portent. Elle sert à mesurer l'impact d'une panne et à appeler le bon groupe. Elle est rarement parfaite : reste à savoir ce que fait la personne quand la CMDB se trompe en pleine crise.
Astreinte et alerting
PagerDuty ou l'alerting intégré à Jira Service Management réveillent la bonne personne et escaladent si personne n'acquitte. Atlassian a arrêté la vente d'Opsgenie le 4 juin 2025 et en coupe l'accès le 5 avril 2027 : ses clients migrent vers Jira Service Management. L'incident manager n'administre pas forcément ces outils, mais il conçoit les règles d'escalade et vérifie que la cellule se monte en quelques minutes la nuit.
Analyse de cause racine
Les 5 pourquoi, le diagramme d'Ishikawa et la méthode Kepner-Tregoe sont les plus cités. Chacune convient à un type de problème : cause simple, causes multiples, panne intermittente. La revue post-incident se mène sans chercher de coupable et se termine par des actions avec un porteur et une date.
Erreurs connues et base de connaissances
Une erreur connue documente un problème dont la cause ou un contournement est établi. Le service desk s'en sert pour résoudre vite les incidents suivants. La fiche reste ouverte tant que le correctif définitif n'est pas passé en production.
Le titre recouvre deux réalités. Dans une grande DSI ou chez un infogérant, l'incident manager pilote les P1 et P2, anime les points d'incident et tient les indicateurs, souvent avec une astreinte. Dans une équipe plus petite, il cumule incident, problème et parfois changement, et travaille directement avec les ingénieurs de production. Les offres demandent presque toujours ITIL et un outil ITSM, ServiceNow en tête. La certification ITIL 4 Foundation, ou désormais ITIL Foundation (Version 5), atteste le vocabulaire. La tenue d'une crise réelle et le suivi d'un problème jusqu'au correctif se vérifient en entretien.
Les savoir-faire à vérifier chez un incident manager
- Qualification et priorisation des incidents
- Conduite d'un incident majeur
- Diagnostic avec la supervision et la CMDB
- Analyse de cause racine
- Erreurs connues et changements correctifs
- Indicateurs, SLA et revue d'incidents
Cinq questions d'incident majeur et de cause racine
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Lundi 9 h, le portail de commande ne répond plus et le service desk reçoit quarante appels en dix minutes. Que faites-vous dans le premier quart d'heure ?
Une bonne réponseIl déclare l'incident majeur selon les critères prévus, ouvre le pont et nomme les rôles : lui pilote, un responsable technique mène le diagnostic, quelqu'un se charge de la communication. Il rattache les tickets du service desk à un incident parent, regarde le calendrier des changements de la veille et envoie un premier message aux métiers avec l'heure du prochain point.
Signal d'alerteSe plonger lui-même dans les journaux et laisser la coordination à personne. Attendre d'avoir la cause pour prévenir les métiers. Laisser quarante tickets séparés traités par quatre techniciens différents.
Question 2 · junior à confirmé
Un membre du comité de direction signale que son imprimante ne fonctionne plus et exige une priorité 1. Comment fixez-vous la priorité ?
Une bonne réponseAvec la matrice impact et urgence : un seul utilisateur, un service non critique, un contournement possible avec une autre imprimante. La priorité reste basse. Si le contrat prévoit un traitement VIP, celui-ci joue sur le délai de prise en charge ou l'intervenant, sans fausser la priorité ni les statistiques.
Signal d'alerteUne P1 parce que c'est un directeur, ce qui mobilise la cellule de crise pour une imprimante. Ou un refus sec sans vérifier si une règle VIP existe.
Question 3 · confirmé
Le même serveur d'application redémarre seul une à deux fois par semaine depuis un mois, et chaque incident est clos par un redémarrage. Que faites-vous ?
Une bonne réponseIl ouvre un problème et y rattache les incidents. Il réunit les données : horaires des redémarrages, journaux système, consommation mémoire, tâches planifiées, changements récents. Il fait tester les hypothèses une à une, documente le contournement en erreur connue pour le service desk, fait passer le correctif par la gestion des changements et ne clôt qu'après une période d'observation sans récidive.
Signal d'alerteContinuer à redémarrer en considérant que l'incident est résolu. Clore le problème dès que le contournement est publié.
Question 4 · confirmé
Pendant un incident, la supervision affiche 300 alertes rouges en même temps. Comment trouvez-vous celle qui compte ?
Une bonne réponseIl cherche l'alerte la plus ancienne et la plus basse dans la pile : réseau, stockage, DNS, base de données, avant les applications qui en dépendent. Il s'appuie sur la cartographie des services ou la CMDB pour regrouper les alertes dérivées et sur la corrélation de l'outil quand elle existe. Il vérifie en parallèle les changements des dernières heures sur les composants touchés.
Signal d'alerteOuvrir 300 tickets, ou traiter les alertes dans leur ordre d'arrivée à l'écran.
Question 5 · confirmé
Le rétablissement prendra au moins trois heures. Que mettez-vous dans le message aux directions métier, et à quel rythme l'envoyez-vous ?
Une bonne réponseLe service touché dans les mots des métiers, qui est concerné et ce qui ne marche pas, le contournement s'il existe, ce qui est en cours sans jargon, et l'heure du prochain point. Le rythme est fixe, par exemple toutes les trente minutes, même sans nouveauté. Un seul émetteur et un seul canal, page de statut ou liste de diffusion. Aucune heure de retour promise sans base.
Signal d'alerteUn message technique du type « le nœud 2 du cluster a perdu le quorum ». Une promesse de résolution dans quinze minutes. Le silence jusqu'au retour du service.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Incident manager : questions fréquentes
Quelle différence entre un incident manager et un problem manager ?
L'incident manager rétablit le service le plus vite possible : il pilote la crise, coordonne les équipes et informe les métiers. Le problem manager cherche pourquoi l'incident est arrivé, documente l'erreur connue et suit le correctif. Les deux rôles sont souvent tenus par la même personne, sauf dans les grandes organisations. L'entretien couvre les deux versants, car un bon pilote de crise n'est pas toujours patient sur une panne intermittente.
ITIL 4 ou ITIL (Version 5) : quelle certification attendre ?
ITIL 4 Foundation reste la plus fréquente sur les CV. PeopleCert a publié ITIL (Version 5) début 2026, sans retirer ITIL 4, avec un module passerelle pour les certifiés ITIL 4. Les deux attestent le vocabulaire et les pratiques. Le module ITIL 4 Practitioner dédié à la gestion des incidents ou des problèmes montre un effort ciblé. Aucun de ces titres ne prouve qu'une personne a tenu une cellule de crise : seul un incident vécu et sa chronologie le montrent.
Faut-il un test technique pour un incident manager ?
Un exercice de code n'a pas de sens pour ce poste. Une simulation d'incident majeur, en revanche, en dit beaucoup : un scénario, quelques alertes et un appel de directeur suffisent pour juger l'ordre des actions et le premier message aux métiers. Vingt minutes suffisent. Une capture de supervision ou un extrait de journal permet de vérifier que la personne sait lire une information technique.
Un incident manager doit-il savoir diagnostiquer lui-même ?
Il ne corrige pas, mais il doit comprendre ce que disent les équipes. Lire une alerte, situer une panne dans la chaîne réseau, serveur, base de données, savoir ce qu'est un DNS ou un certificat expiré : sans ces bases, il ne peut ni arbitrer entre deux hypothèses ni contrôler un délai annoncé. Pour un profil venu de la production ou de la supervision, c'est un acquis. Pour un profil venu du pilotage pur, ce point se vérifie.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.