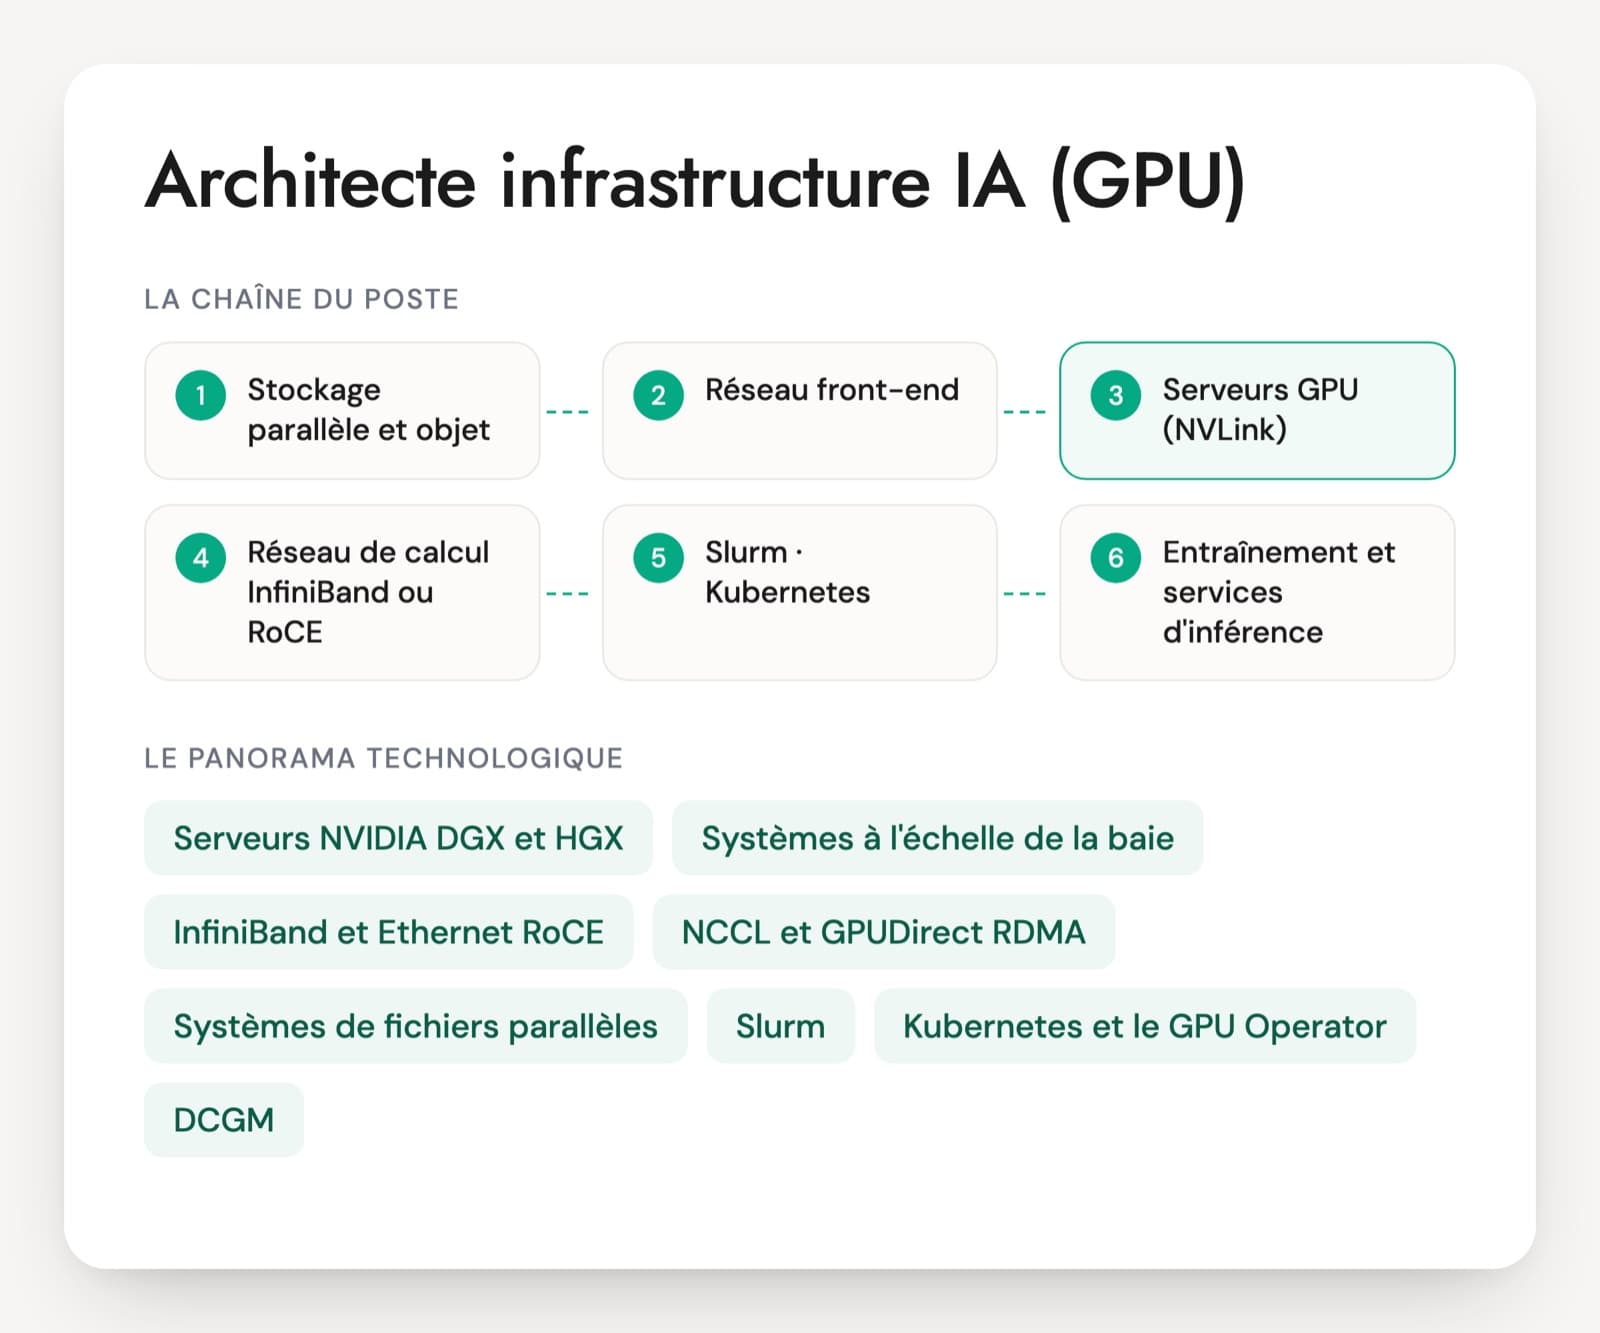
Le poste naît quand une organisation décide de faire tourner ses modèles sur son propre matériel, dans son datacenter ou en colocation, plutôt que de tout louer. L'architecte choisit les serveurs à huit GPU, conçoit le réseau InfiniBand ou RoCE qui les relie, dimensionne le stockage des données et des checkpoints, et vérifie que la salle tient la charge électrique et thermique. Il installe ensuite l'ordonnanceur, Slurm ou Kubernetes, et prépare la mise en service.
La couche du dessus, avec le registre de modèles et le feature store, relève de l'architecte plateforme ML. Ici, le profil vient plutôt du HPC, du datacenter ou du réseau. Les offres françaises parlent de bare metal, d'exécution de LLM sur serveurs dédiés, de dossiers HLD et LLD et de coordination avec les équipes réseau, stockage et sécurité.
L'entretien passe par le calcul. Mémoire d'un modèle, débit d'un checkpoint, kW par baie : un candidat expérimenté pose les chiffres sans hésiter et cite les tests qu'il lance à la livraison d'un cluster. Le PDF réunit 30 questions, un cas chiffré et une grille.
Matériel, réseau et logiciels d'un cluster GPU
Serveurs NVIDIA DGX et HGX
Les serveurs à huit GPU reliés par NVLink et NVSwitch. Le DGX est le système de NVIDIA, les serveurs HGX viennent de constructeurs comme Dell, HPE, Lenovo ou Supermicro. Un DGX B200 annonce 1 440 Go de mémoire GPU et jusqu'à 14,3 kW de consommation, ce qui donne l'ordre de grandeur du poste.
Systèmes à l'échelle de la baie (GB200 et GB300 NVL72)
Une baie entière de 72 GPU reliés en un seul domaine NVLink, refroidie par liquide. Ce format oblige à penser la salle, l'eau et l'électricité avant même de commander.
InfiniBand et Ethernet RoCE
Les deux familles de réseau de calcul entre serveurs, à 400 ou 800 Gb/s par GPU. InfiniBand est le choix historique du HPC. RoCE fait passer le même type de trafic sur Ethernet, à condition d'un réglage précis du réseau.
NCCL et GPUDirect RDMA
NCCL est la bibliothèque de communication entre GPU qu'utilisent les frameworks d'entraînement. GPUDirect RDMA laisse la carte réseau lire et écrire directement dans la mémoire du GPU. Les tests NCCL servent à valider un cluster et à diagnostiquer un ralentissement.
Systèmes de fichiers parallèles
Lustre, IBM Storage Scale, WEKA, VAST ou DDN servent les données d'entraînement et absorbent les checkpoints à plusieurs dizaines de Go/s. Le stockage objet garde les archives et les modèles publiés.
Slurm
L'ordonnanceur du HPC, très présent sur les clusters d'entraînement. Il réserve des nœuds entiers, connaît la topologie du réseau et gère les files, les priorités et les GPU déclarés comme ressources.
Kubernetes et le GPU Operator
La plateforme de conteneurs, surtout pour l'inférence. Le GPU Operator de NVIDIA installe le pilote, le device plugin et la supervision sur les nœuds GPU. Les jobs d'entraînement demandent un ordonnanceur de lots en complément.
DCGM
L'outil de NVIDIA pour surveiller et diagnostiquer les GPU d'un centre de données : température, puissance, erreurs, tests de recette. Son exporteur alimente les tableaux de bord.
Le poste se trouve chez les fournisseurs de cloud et d'hébergement qui ouvrent des offres GPU, chez les grandes organisations qui installent leurs propres clusters, chez les constructeurs et intégrateurs, et dans les ESN qui répondent à ces projets. Les missions portent sur un premier cluster, son extension ou le passage à une génération de GPU refroidie par liquide. Le travail croise les équipes réseau, stockage, sécurité, datacenter et data science. Aucune certification ne remplace l'expérience d'un cluster mis en service : les tests de recette et les incidents vécus se vérifient en entretien.
Les compétences d'infrastructure à vérifier sur un cluster GPU
- Dimensionnement des serveurs GPU
- Réseau de calcul InfiniBand ou RoCE
- Stockage parallèle et checkpoints
- Énergie, refroidissement et hébergement
- Ordonnancement Slurm et Kubernetes
- Recette et exploitation du cluster
Cinq questions d'entretien, calculs et diagnostics compris
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Une équipe veut servir un modèle open source de 70 milliards de paramètres à 200 utilisateurs simultanés. Comment dimensionnez-vous les serveurs GPU ?
Une bonne réponseD'abord la mémoire : 70 milliards de paramètres pèsent environ 140 Go en BF16, 70 Go en FP8, moitié moins en 4 bits. S'y ajoute le cache KV, qui grandit avec la longueur de contexte et le nombre de requêtes en parallèle. Le modèle se répartit donc sur deux à quatre GPU de 80 Go, ou moins avec des GPU à plus grande mémoire. Le candidat mesure ensuite avec le moteur prévu (vLLM, TensorRT-LLM, SGLang) sur un profil réaliste de tokens en entrée et en sortie, puis ajoute une marge N+1.
Signal d'alerte« Un GPU par utilisateur », ou un calcul qui ne compte que les poids du modèle.
Question 2 · senior
Vous concevez le réseau d'un cluster d'entraînement de 32 serveurs à huit GPU. Quelle topologie proposez-vous ?
Une bonne réponseTrois réseaux séparés : le réseau de calcul entre GPU, le réseau front-end pour le stockage et les accès, et la gestion hors bande. Le réseau de calcul compte une carte à 400 Gb/s par GPU, soit 256 ports, en fat-tree non bloquant à deux niveaux. Il est organisé en rails : la carte numéro n de chaque serveur arrive sur le même switch, pour que les GPU de même rang communiquent en un saut. Le candidat parle aussi d'optiques, de longueurs de câbles et de plan de brassage.
Signal d'alerteUn réseau Ethernet 25 Gb/s partagé pour tout, ou un réseau de calcul sursouscrit à 3 pour 1.
Question 3 · senior
Un entraînement de trois semaines écrit un checkpoint de 2 To toutes les heures. Comment dimensionnez-vous le stockage ?
Une bonne réponsePar le débit d'écriture : à 20 Go/s agrégés, 2 To prennent une centaine de secondes pendant lesquelles les GPU peuvent attendre. Il faut donc un système de fichiers parallèle tout-flash pour les données chaudes (Lustre, IBM Storage Scale, WEKA, VAST, DDN), des checkpoints asynchrones côté framework, et une règle de rétention : les derniers checkpoints en ligne, les autres vers un stockage objet. Le candidat dimensionne aussi la lecture des données d'entraînement.
Signal d'alerteUn NAS NFS classique, ou aucun calcul de débit.
Question 4 · senior
La salle accepte 15 kW par baie en refroidissement par air. On veut y installer des serveurs à huit GPU de dernière génération. Que répondez-vous ?
Une bonne réponseUn DGX B200 consomme jusqu'à 14,3 kW à lui seul : on tombe à un serveur par baie, avec beaucoup de place perdue. Les options sont le confinement d'allée, des portes arrière refroidies, ou le refroidissement liquide direct, qui demande une boucle d'eau, des CDU et des travaux sur le bâtiment. Les systèmes à l'échelle de la baie comme le GB300 NVL72 sont entièrement refroidis par liquide. Le candidat parle aussi d'alimentation par baie, de poids au sol, de délais de travaux et de colocation.
Signal d'alerte« On met quatre serveurs par baie, ça passera. »
Question 5 · senior
Slurm ou Kubernetes pour un cluster qui sert à la fois à l'entraînement et à l'inférence ?
Une bonne réponseSlurm réserve des nœuds entiers, lance tous les processus d'un job ensemble, tient compte de la topologie et gère les files et les priorités, avec les habitudes du HPC. Kubernetes convient aux services d'inférence, à l'autoscaling et aux conteneurs, avec le GPU Operator, et demande un ordonnanceur de lots en plus (Kueue, Volcano) pour l'entraînement. Beaucoup de clusters séparent les deux en partitions, ou font tourner Slurm sur Kubernetes. Le choix suit les usages et l'équipe.
Signal d'alerte« Kubernetes sait tout faire nativement », sans parler du lancement groupé des jobs distribués.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Architecte infrastructure IA, les questions fréquentes
Architecte infrastructure IA ou architecte plateforme ML, quelle différence ?
Le premier conçoit le matériel et ce qui le fait tourner : serveurs GPU, réseau de calcul, stockage, salle, ordonnanceur. Le second construit l'outillage des équipes de data science au-dessus : registre de modèles, feature store, pipelines, serving. Un projet qui commence par l'achat ou la location de serveurs GPU relève du premier. Quand les GPU existent déjà et que les équipes déploient chacune à sa façon, c'est le second.
Un profil HPC sans expérience des LLM peut-il convenir ?
Souvent, oui. Les clusters d'entraînement reprennent les briques du calcul scientifique : Slurm, InfiniBand, Lustre, MPI, recette d'un cluster. Ce qui change, c'est la taille des modèles, la mémoire qu'ils demandent, l'inférence en service continu et la densité électrique. L'entretien vérifie qu'il sait calculer la mémoire d'un modèle et qu'il connaît les contraintes de refroidissement des dernières générations de GPU.
Quel test technique est donné à un architecte infrastructure IA ?
Un dimensionnement chiffré fonctionne bien. L'énoncé fixe un besoin (un modèle à servir, un entraînement à lancer), une salle avec ses limites en kW par baie et un budget. Le candidat propose les serveurs, le réseau, le stockage et l'hébergement, en posant ses calculs. La notation porte sur la justesse des ordres de grandeur, la séparation des réseaux et le plan de recette. Les erreurs de calcul de mémoire ou de puissance sont éliminatoires.
Quelles preuves d'expérience attendre sur un CV ?
Le nombre de GPU et de serveurs du cluster, la génération des GPU, le type de réseau et de stockage, et le rôle exact du candidat : conception, installation ou exploitation. L'entretien revient sur les tests lancés à la réception et sur un incident réel, comme un lien défectueux ou un GPU en panne au milieu d'un entraînement. Un candidat qui a mis en service un cluster en parle avec des chiffres.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.