Le recrutement d'un ingénieur web sémantique tombe souvent sur un recruteur qui n'a jamais vu de triplet RDF. Le poste consiste à décrire un domaine (des pièces industrielles, des molécules, des textes juridiques, des jeux de données publics) dans une ontologie, à y relier des sources hétérogènes, puis à rendre le tout interrogeable en SPARQL. On le croise dans l'industrie, la santé, la documentation, les données publiques, et dans les projets d'IA générative qui veulent un graphe de connaissances derrière leurs agents.
Deux profils se présentent. Les docteurs en représentation des connaissances maîtrisent la logique et OWL, parfois sans avoir tenu un triple store en production. Les développeurs venus de la donnée savent charger et requêter, mais confondent volontiers une ontologie avec un schéma de base. L'expérience se reconnaît aux détails : savoir pourquoi rdfs:domain ne valide rien, séparer le raisonnement du contrôle confié à SHACL, avoir dû gérer des URI stables ou un alignement entre deux vocabulaires.
Ontologie existante ou à construire, triple store en place : l'équipe peut le préciser avant l'entretien. Un docteur sans expérience de production convient au premier cas, beaucoup moins si le graphe alimente déjà des agents en ligne.
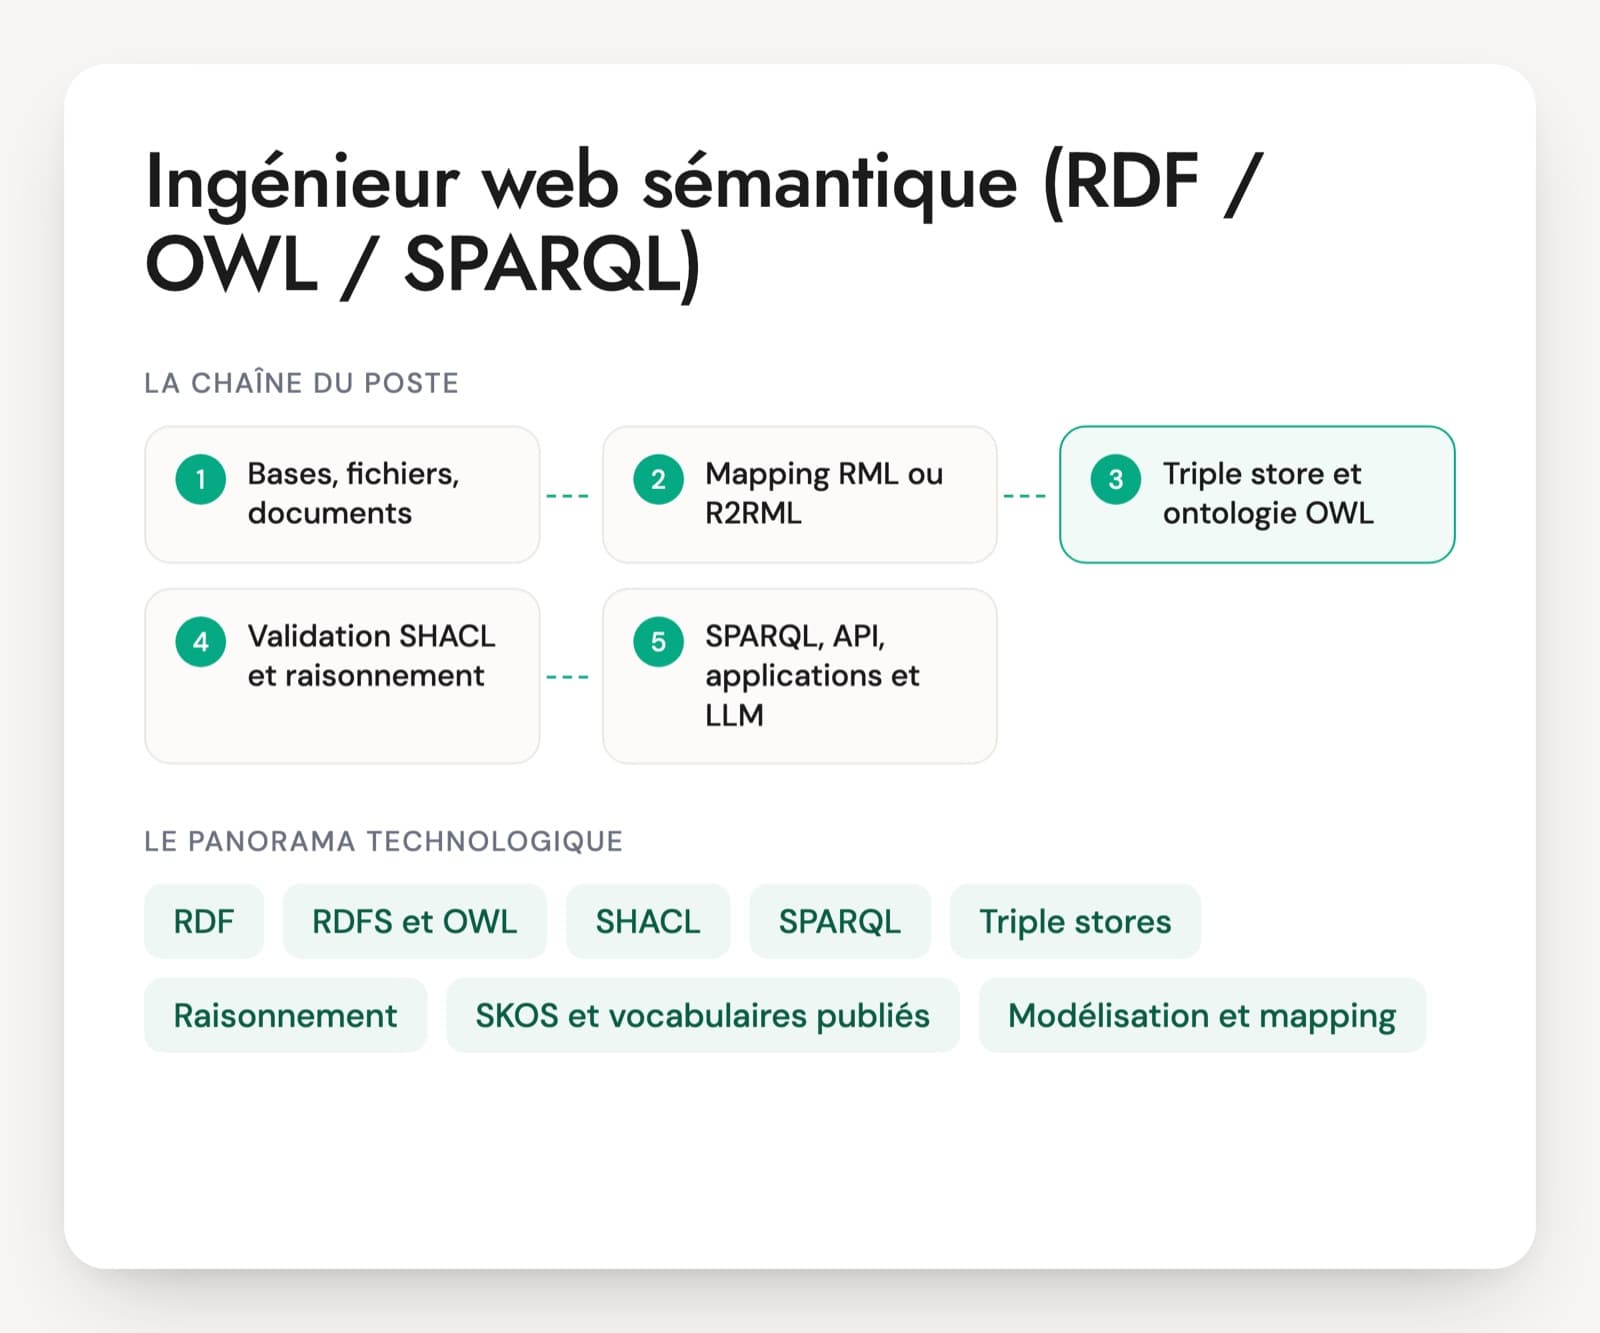
RDF, OWL, SHACL et les autres briques du web sémantique
RDF
Le modèle de données de base du W3C. Toute information s'écrit en triplets sujet, prédicat, objet, chacun identifié par une URI : telle pompe, est fabriquée par, tel fournisseur. Les triplets s'écrivent dans des formats comme Turtle ou JSON-LD et se regroupent en graphes nommés. RDF 1.2, qui permet de décrire une affirmation elle-même (sa source, sa date), en est encore au stade de Candidate Recommendation du W3C (version d'avril 2026).
RDFS et OWL
Les langages qui décrivent l'ontologie : classes, sous-classes, propriétés, cardinalités, classes disjointes. OWL repose sur une logique qui permet à un raisonneur de déduire de nouveaux faits. Il suppose un monde ouvert, où ce qui n'est pas écrit reste inconnu sans être faux. C'est le point qui déroute le plus les profils venus des bases relationnelles.
SHACL
Le langage de validation, recommandation du W3C depuis 2017. Il décrit ce qu'une donnée doit contenir (toute pompe a exactement un numéro de série, de type texte) et produit un rapport d'erreurs. OWL sert à déduire, SHACL à contrôler, et un profil expérimenté ne mélange pas les deux.
SPARQL
Le langage de requête des graphes RDF, l'équivalent de SQL dans ce monde. On y écrit des motifs de triplets, des chemins de propriétés (toutes les sous-catégories, à n'importe quelle profondeur) et des requêtes fédérées vers d'autres sources ; SPARQL Update modifie les données. Faites écrire une requête pendant l'entretien, la différence entre lecture et pratique apparaît vite.
Triple stores
Les bases qui stockent et interrogent les triplets : GraphDB (édité par Graphwise, ex-Ontotext), Stardog, Apache Jena Fuseki, Virtuoso, ou Amazon Neptune côté cloud, qui accepte aussi les graphes de propriétés. Ils diffèrent par le raisonnement proposé, la tenue en volume et les connecteurs vers la recherche plein texte.
Raisonnement
Le moteur qui déduit des faits implicites à partir de l'ontologie : une pompe centrifuge étant une sorte de pompe, elle sort dans la liste des pompes. GraphDB matérialise ces déductions au chargement, selon un jeu de règles choisi (RDFS, RDFS-Plus, OWL 2 RL et d'autres). Plus le jeu est riche, plus le chargement et les suppressions coûtent, ce qui impose des choix.
SKOS et vocabulaires publiés
SKOS décrit des thésaurus et des taxonomies (terme préféré, synonymes, terme plus large), plus légers qu'une ontologie OWL. Le métier consiste souvent à réutiliser des vocabulaires publiés comme schema.org, Dublin Core, PROV-O ou DCAT plutôt qu'à tout réinventer. Demandez quels vocabulaires la personne a repris, et pourquoi.
Modélisation et mapping
Protégé reste l'éditeur d'ontologies le plus répandu. Pour transformer des tables relationnelles, des CSV ou du JSON en RDF, on utilise des langages de correspondance comme R2RML ou RML, ou des scripts Python avec rdflib. Cette étape prend souvent la plus grande part d'un projet.
Graphes de connaissances et LLM
Les projets récents branchent un graphe RDF sur un modèle de langage : génération de SPARQL à partir d'une question en français, ou GraphRAG, où le graphe fournit au modèle des faits vérifiés et leurs relations. GraphDB intègre par exemple un module Talk to Your Graph. Vérifiez que la personne sait contrôler une requête générée avant de l'exécuter.
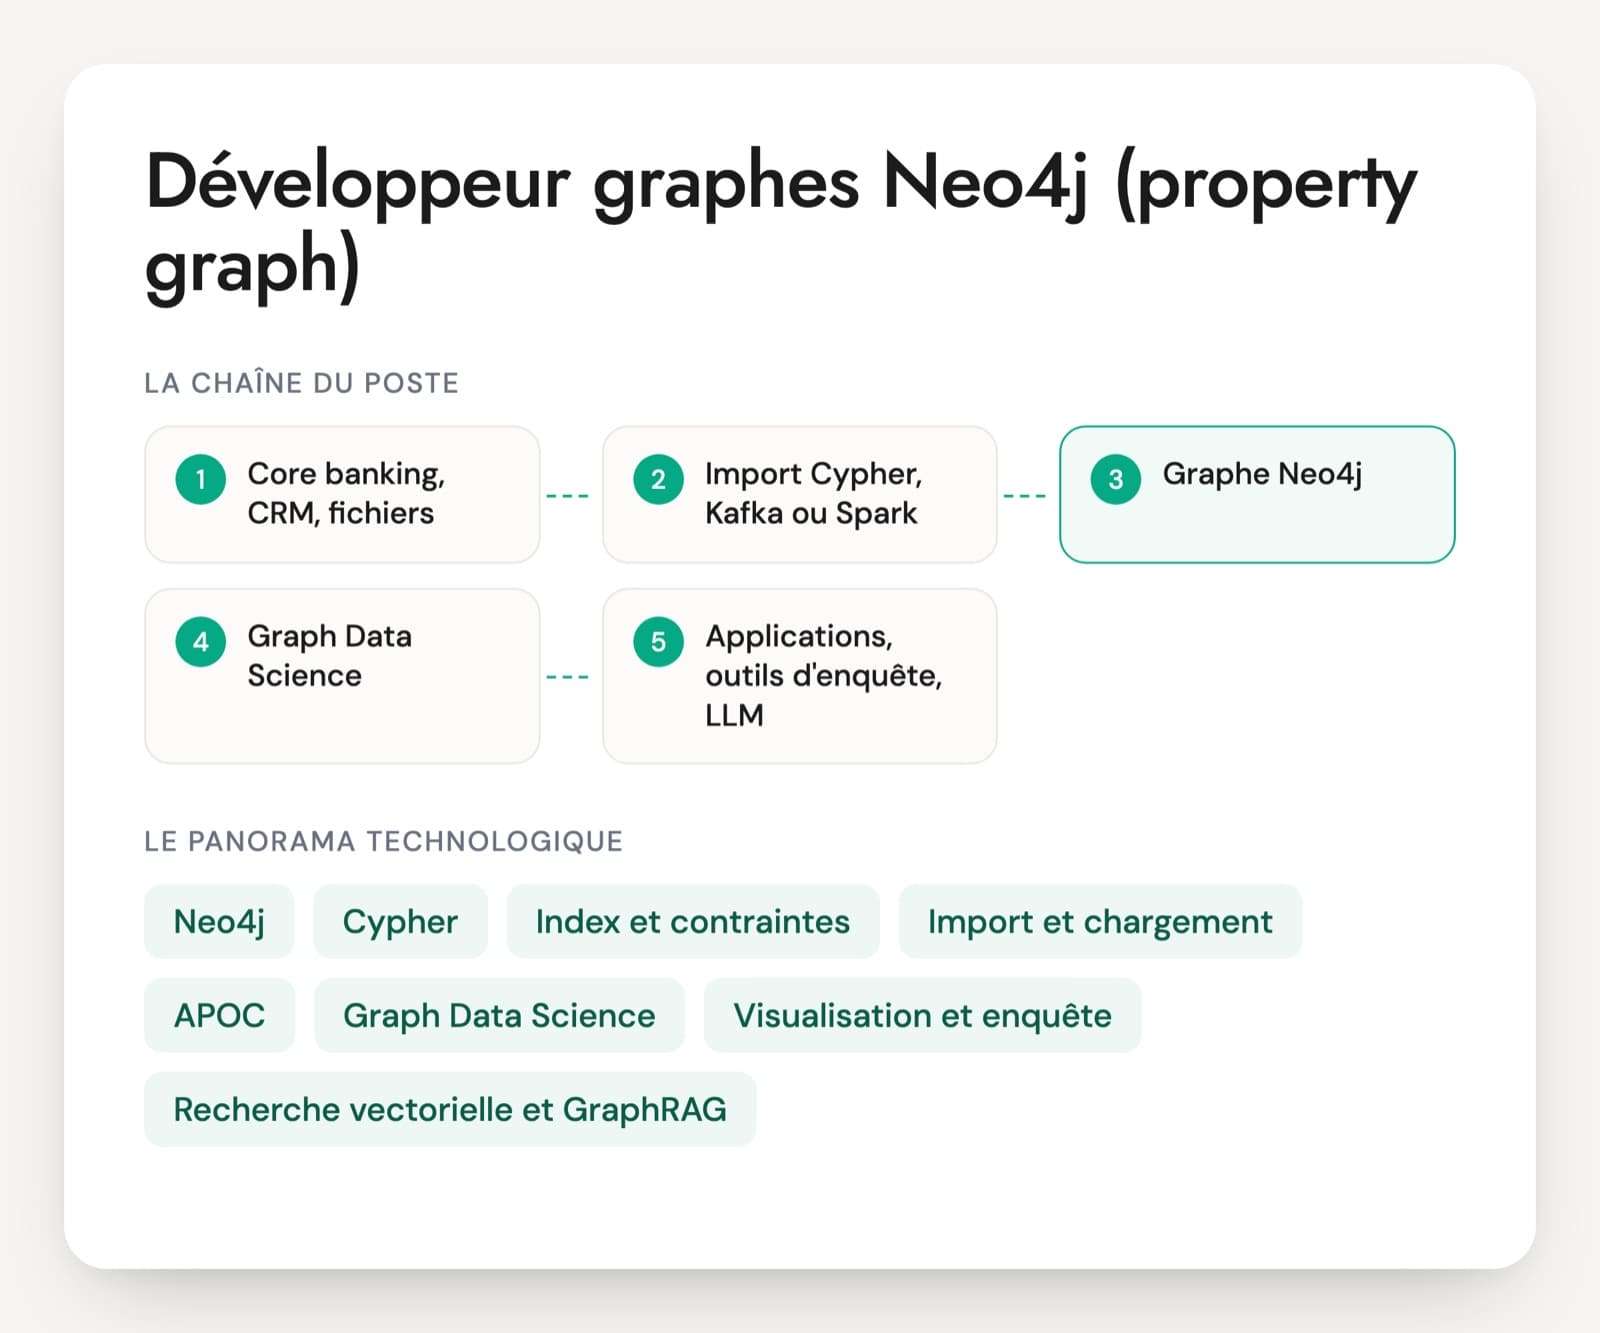
Le poste porte plusieurs noms : ingénieur web sémantique, ontologue, knowledge graph engineer, parfois data engineer avec une compétence RDF. Dans l'industrie, il structure des référentiels de produits, de pièces ou d'exigences. En santé et en recherche, il manipule des terminologies et des ontologies publiques. Dans le secteur public et la documentation, il publie des données liées avec DCAT ou SKOS. En ESN, les missions sont rares et souvent courtes, sur une phase de modélisation ou la reprise d'un graphe existant. Les offres demandent parfois l'un ou l'autre monde, RDF ou Neo4j, pour une même mission. Beaucoup de candidats ont un doctorat ou un passé en recherche : évaluez la modélisation, puis vérifiez à part la capacité à livrer et à maintenir un graphe utilisé en production.
Les acquis techniques à vérifier chez un ontologue
- Modélisation d'ontologies OWL et RDFS
- Écriture et optimisation de requêtes SPARQL
- Validation des données avec SHACL
- Raisonnement et choix du triple store
- Intégration de sources hétérogènes en RDF
- Gouvernance des URI et des vocabulaires
Cinq questions sur une ontologie confrontée aux vraies données
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Dans votre ontologie, la propriété aPourFournisseur a pour domaine la classe Pièce. Quelqu'un l'applique par erreur à un client. Que se passe-t-il ?
Une bonne réponseAucune donnée n'est rejetée : en RDFS et en OWL, le domaine sert à déduire une classe. Le raisonneur conclut que le client est aussi une Pièce. Si Client et Pièce sont déclarées disjointes, l'ontologie devient incohérente et le raisonneur le signale. Pour bloquer l'erreur à l'entrée, il faut une forme SHACL qui vérifie la classe des sujets de cette propriété.
Signal d'alerte« Le triple store refuse l'insertion », comme avec une clé étrangère. C'est la confusion la plus fréquente chez les profils venus du relationnel.
Question 2 · junior à confirmé
Un utilisateur demande la liste des produits sans date de mise en service. Votre requête SPARQL ne renvoie rien alors qu'il en existe. Pourquoi ?
Une bonne réponseUn motif de triplet obligatoire élimine les produits qui n'ont pas la propriété. Il faut un FILTER NOT EXISTS sur le motif de la date, ou un OPTIONAL suivi de FILTER(!BOUND(?date)). Il sait expliquer la nuance avec MINUS, et rappelle qu'en monde ouvert l'absence de date dans le graphe ne prouve pas que le produit n'en a pas.
Signal d'alerteChercher une valeur nulle comme en SQL, ou conclure que les données sont fausses.
Question 3 · confirmé
Comment vérifiez-vous, avant chargement, que chaque équipement a exactement un numéro de série et un site de rattachement valide ?
Une bonne réponseUne forme SHACL qui cible la classe Équipement : sh:minCount et sh:maxCount à 1 sur le numéro de série avec sh:datatype xsd:string, sh:class Site sur le rattachement. La validation tourne dans le pipeline avant l'insertion, ou dans le triple store quand il la gère à chaque transaction, et le rapport liste chaque nœud en erreur. Il distingue les sévérités (violation, avertissement) pour ne pas bloquer un lot entier sur un détail.
Signal d'alerteUne cardinalité OWL « exactement 1 » en pensant qu'elle bloquera les données incomplètes. En monde ouvert, le raisonneur suppose que le numéro manquant existe quelque part.
Question 4 · senior
Quel jeu de règles de raisonnement choisissez-vous dans GraphDB pour un graphe de 500 millions de triplets mis à jour chaque jour ?
Une bonne réponseLe jeu le plus léger qui couvre les besoins réels, souvent RDFS ou RDFS-Plus (hiérarchies, propriétés inverses et transitives), plutôt qu'OWL 2 RL complet. GraphDB matérialise les déductions au chargement : plus le jeu est riche, plus le nombre de triplets déduits, le temps de chargement et le coût des suppressions augmentent. Il se méfie d'owl:sameAs utilisé sans contrôle et place l'ontologie en lecture seule pour accélérer les mises à jour.
Signal d'alerteLe jeu le plus complet « pour être tranquille », sans regarder le coût, ou aucune idée que les déductions sont stockées.
Question 5 · confirmé
Vous devez transformer une base relationnelle de produits et un fichier Excel de fournisseurs en RDF. Comment organisez-vous le travail ?
Une bonne réponseIl part de l'ontologie cible et des vocabulaires réutilisés, définit un schéma d'URI stable fondé sur les identifiants métier, puis écrit des correspondances déclaratives (R2RML pour la base, RML pour le fichier) ou un script versionné. Il traite le rapprochement entre les deux sources (même fournisseur sous deux noms), valide le résultat avec SHACL et prévoit les chargements incrémentaux.
Signal d'alerteDes URI construites sur l'identifiant auto-incrémenté de la base, ou un export fait une fois à la main, impossible à rejouer.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Web sémantique et recrutement : ce qui revient le plus
Ontologue et ingénieur web sémantique, est-ce le même métier ?
Les deux titres se recouvrent largement. L'ontologue met l'accent sur la modélisation du domaine avec les experts métier, la logique OWL et l'alignement entre vocabulaires. L'ingénieur web sémantique y ajoute la partie logicielle : pipelines de transformation, triple store, API, mise en production. Dans une petite équipe, une seule personne fait les deux. Pour un poste en production, vérifiez la partie ingénierie autant que la modélisation.
RDF ou Neo4j : quelle compétence demander ?
Cela dépend du projet. RDF et OWL s'imposent quand il faut des standards ouverts, des identifiants partagés, du raisonnement ou la publication de données liées. Les graphes de propriétés comme Neo4j sont fréquents pour la fraude, la recommandation ou l'analyse de réseau, avec le langage Cypher. Certains moteurs, comme Amazon Neptune, acceptent les deux modèles. Un profil passe de l'un à l'autre, mais la façon de modéliser change : prévoyez un temps d'adaptation.
Comment évaluer la pratique de SPARQL sans environnement dédié ?
Un extrait de données en Turtle, une vingtaine de triplets imprimés ou partagés à l'écran, suffit. Demandez deux ou trois requêtes : une avec OPTIONAL, une agrégation, un chemin de propriété. Un test technique plus long peut se faire sur Apache Jena Fuseki, gratuit et rapide à installer, avec une ontologie à corriger et une forme SHACL à écrire. Faites commenter les choix à voix haute pour suivre le raisonnement.
Un doctorat en représentation des connaissances garantit-il le niveau ?
C'est un bon signal pour la modélisation et la logique, rarement une preuve de pratique en production. Demandez un graphe livré : son volume, le triple store choisi, la manière de le mettre à jour, les erreurs de données découvertes et le contrôle ajouté ensuite. Un profil sans doctorat qui a fait vivre un graphe pendant plusieurs années peut mieux convenir à un poste d'ingénierie.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.