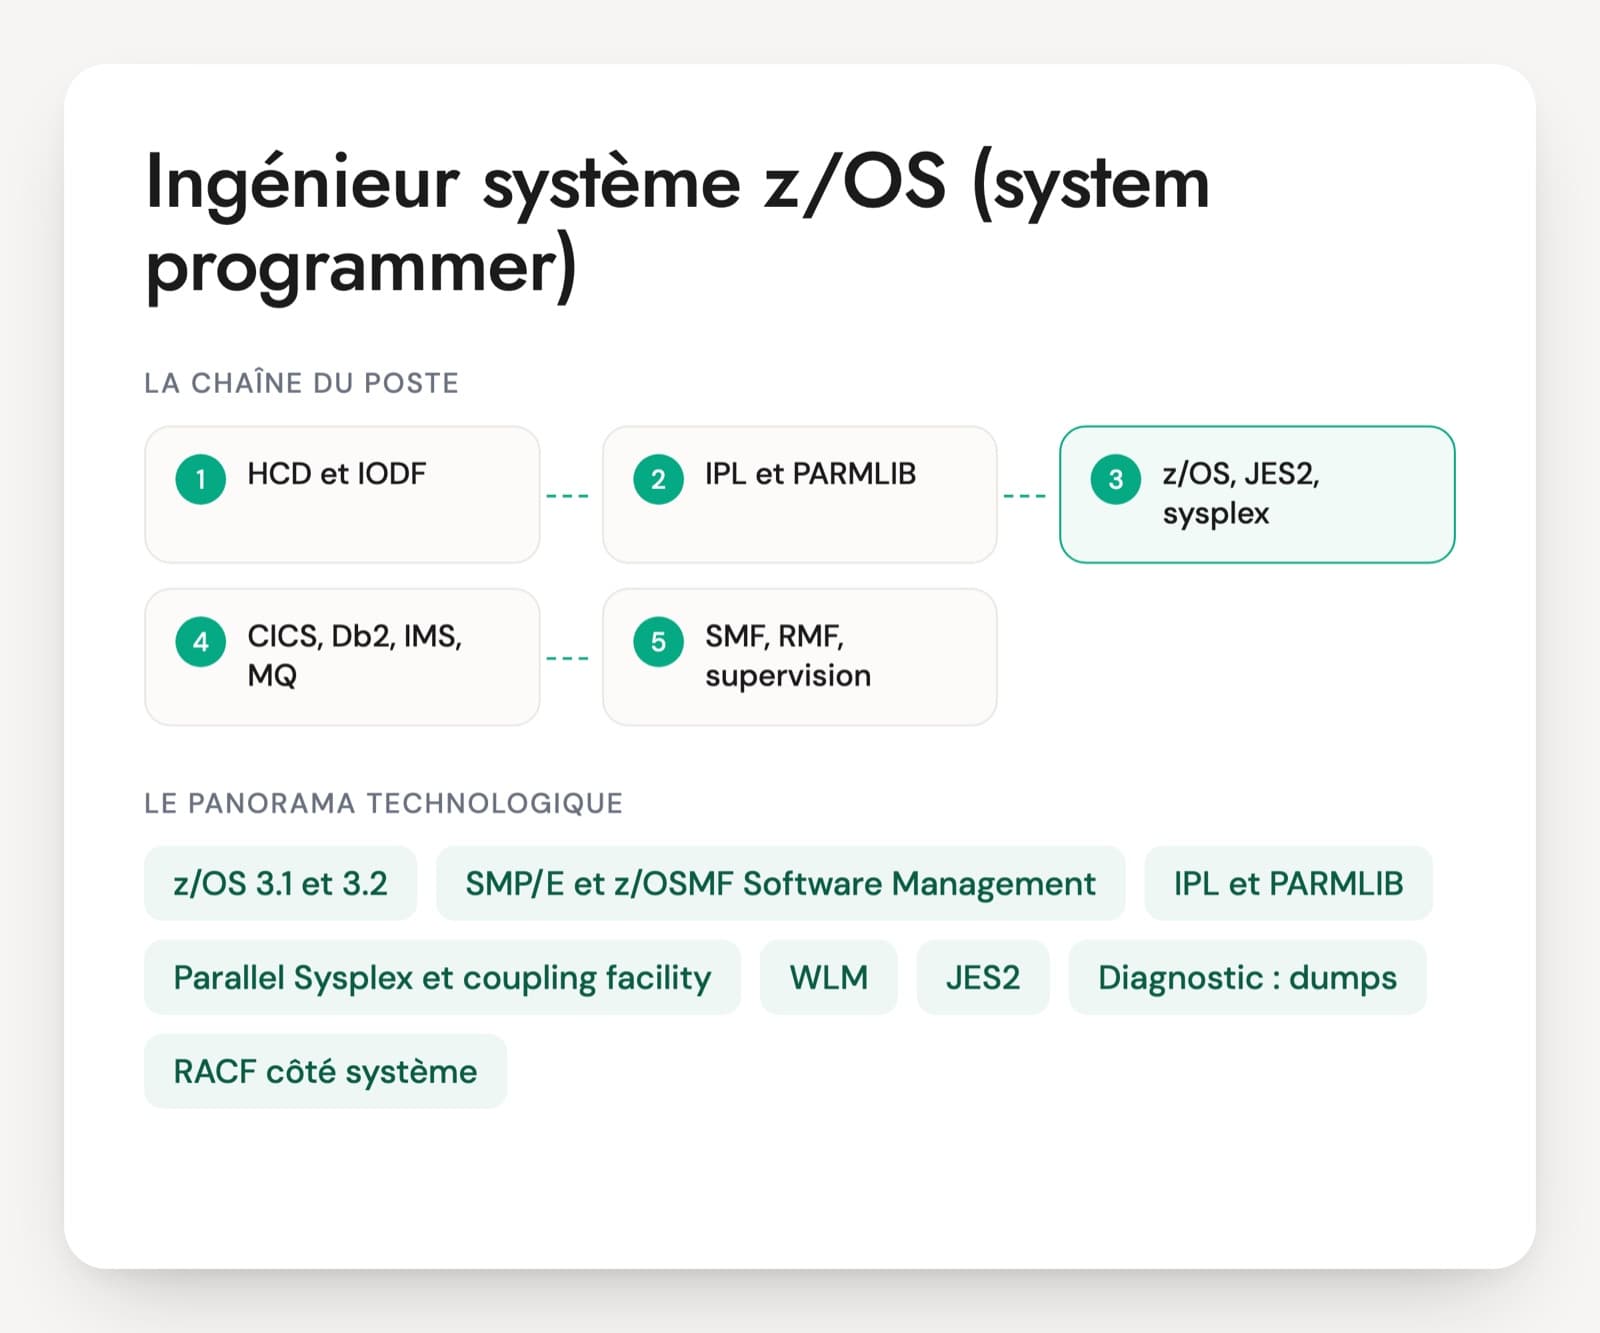
Sur un mainframe, le system programmer tient le système lui-même. Il applique la maintenance avec SMP/E, prépare les IPL, règle la PARMLIB, administre le Parallel Sysplex et ses coupling facilities, écrit la politique WLM et analyse les dumps quand un espace d'adressage tombe. Les applications, les tables Db2 et les chaînes batch appartiennent à d'autres équipes, qui comptent sur lui quand le système ralentit.
Le calendrier IBM pèse sur les recrutements actuels. z/OS 2.5 est sorti du support standard le 30 septembre 2026, avec une extension payante possible. z/OS 3.1 est disponible depuis septembre 2023 et z/OS 3.2 depuis le 30 septembre 2025, avec le serveur z17. JES3 n'est plus livré depuis z/OS 3.1. Beaucoup de sites lancent donc une migration, et les annonces demandent souvent une montée de version déjà conduite.
Le récit de la dernière maintenance appliquée est parlant : niveau RSU, holds traités, système de test, ordre de déploiement, retour arrière prévu. Un candidat qui a vraiment fait le travail cite des membres de PARMLIB, des commandes SETPROG ou SETXCF et des numéros de messages. Un profil d'exploitation ou de développement parle surtout de JCL et de SDSF.
Ce que le system programmer installe et règle
z/OS 3.1 et 3.2
Le système d'exploitation du mainframe IBM. z/OS 3.2 est sorti le 30 septembre 2025 avec le serveur z17, z/OS 3.1 en septembre 2023, et z/OS 2.5 a quitté le support standard le 30 septembre 2026. Trois versions consécutives peuvent cohabiter dans un sysplex, ce qui permet une migration système par système.
SMP/E et z/OSMF Software Management
SMP/E installe et trace chaque correctif (PTF) et chaque produit, avec ses prérequis et ses consignes d'installation (HOLDDATA). z/OSMF ajoute l'inventaire des instances logicielles, leur déploiement et les rapports de correctifs manquants. Les ServerPac récents se livrent au format z/OSMF.
IPL et PARMLIB
L'IPL est le démarrage du système. Il lit LOADxx, puis IEASYSxx et les autres membres de PARMLIB (PROGxx pour l'APF et le LNKLST, IEASYMxx pour les symboles). Beaucoup de réglages se changent à chaud par commande, à condition de reporter le changement dans PARMLIB pour le prochain IPL.
Parallel Sysplex et coupling facility
Plusieurs systèmes z/OS qui partagent données et charge. Ils communiquent par XCF et s'appuient sur des coupling facilities, qui hébergent les structures de verrous et de files de Db2, IMS, MQ ou GRS. Les couple data sets portent les politiques CFRM, SFM, ARM et WLM.
WLM, SMF et RMF
WLM répartit les ressources selon des objectifs écrits par le system programmer (temps de réponse, vélocité, importance). SMF enregistre l'activité du système et RMF mesure CPU, mémoire et entrées-sorties. Ces données servent aussi au calcul de la facture logicielle en MSU.
JES2, z/OS UNIX et réseau
JES2 gère les travaux batch et le spool. z/OS UNIX System Services, avec ses systèmes de fichiers zFS, porte Java, z/OSMF, Zowe et de nombreux produits récents. La pile TCP/IP et VTAM restent du ressort de l'équipe système sur beaucoup de sites.
Diagnostic : dumps, IPCS, SLIP
Quand un espace d'adressage boucle ou tombe, le system programmer prend un SVC dump, le lit avec IPCS ou l'envoie à IBM. Les pièges SLIP déclenchent un dump au moment d'une erreur précise. IBM Health Checker signale les réglages à risque avant l'incident.
RACF côté système
La sécurité est souvent tenue par une équipe à part, mais le system programmer définit ce dont le système a besoin : bibliothèques APF protégées, tâches démarrées (classe STARTED), commandes opérateur (OPERCMDS), profils FACILITY. Reste à savoir qui fait quoi sur le site.
REXX, Ansible et Zowe
REXX reste l'outil d'automatisation de base. Ansible, avec les collections IBM z/OS, et les workflows z/OSMF servent aux tâches de maintenance répétées. Zowe ouvre le mainframe à VS Code et aux chaînes CI, et son serveur s'installe et se sécurise côté système.
Le poste existe chez les grands utilisateurs de mainframe, chez les infogérants et chez IBM. Les équipes sont petites et anciennes, souvent organisées par domaine : système de base, stockage, sécurité, sous-systèmes. Un system programmer confirmé a appliqué plusieurs cycles de maintenance, préparé des IPL et participé à une migration de version. Un senior a conçu une configuration sysplex, écrit une politique WLM et mené une bascule sur le site de secours. Les astreintes de nuit et de week-end sont fréquentes, car les changements se font dans des fenêtres courtes.
Six savoir-faire système attendus
- Maintenance SMP/E et z/OSMF
- IPL, PARMLIB et changements dynamiques
- Parallel Sysplex et coupling facility
- WLM, performance et capacité
- Diagnostic par dump, SLIP et IPCS
- Migration de version et automatisation
Questions d'entretien pour un system programmer z/OS
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Un PTF arrive avec une HOLDDATA de type ACTION et une autre de type DOC. Comment préparez-vous son installation ?
Une bonne réponseRECEIVE avec une HOLDDATA à jour, puis APPLY CHECK pour lister les holds, les prérequis et les PTF en erreur (PE). La personne lit chaque hold ACTION, qui décrit une étape manuelle (IPL avec CLPA, membre de PARMLIB à modifier, job de mise à jour), et ne contourne le hold par BYPASS qu'une fois l'action prévue dans le plan. L'APPLY se fait sur un jeu de volumes cibles cloné, jamais sur le résident en service, puis un IPL sur ce clone.
Signal d'alerteAPPLY direct sur les bibliothèques en cours d'utilisation, avec BYPASS(HOLDSYSTEM) pour aller plus vite, ou aucune lecture des holds.
Question 2 · confirmé
Vous devez ajouter une bibliothèque en APF et dans le LNKLST sans IPL. Comment faites-vous, et que modifiez-vous pour le prochain IPL ?
Une bonne réponseSETPROG APF,ADD avec la liste APF au format dynamique. Pour le LNKLST, un nouvel ensemble défini à partir de l'actuel (SETPROG LNKLST,DEFINE,COPYFROM=CURRENT), la bibliothèque ajoutée, puis l'activation. Contrôle par D PROG,APF et D PROG,LNKLST. La même modification va dans PROGxx, sinon elle disparaît au prochain IPL.
Signal d'alerteModifier PROGxx et croire que le changement est actif, ou oublier de le reporter dans PARMLIB.
Question 3 · senior
Une coupling facility doit partir en maintenance. Comment videz-vous ses structures sans interrompre le service ?
Une bonne réponseD XCF,STR et D CF pour voir les structures et leurs connecteurs. Une politique CFRM dont la liste de préférence contient l'autre CF. Rebuild des structures vers l'autre CF (SETXCF START,REBUILD avec LOCATION=OTHER) ou arrêt du duplexage en gardant la bonne copie. Sur les versions récentes, le mode maintenance de la CF puis un REALLOCATE pour tout déplacer. Contrôle final que chaque structure est à sa place.
Signal d'alerteArrêter la CF et compter sur la reconstruction automatique, sans savoir quelles structures le supportent mal.
Question 4 · confirmé
Un batch critique dure trois fois plus longtemps depuis une semaine. Que regardez-vous côté système ?
Une bonne réponseLa classe de service WLM du job et sa classification, l'indice de performance dans le rapport RMF d'activité des workloads, les délais (CPU, entrées-sorties, mémoire). Un changement récent de politique WLM, une charge plus importante sur la même LPAR, un plafonnement de capacité atteint, un volume lent. Les enregistrements SMF 30 du job pour comparer CPU et entrées-sorties avec la semaine précédente.
Signal d'alerteMonter la priorité du job sans comprendre ce qui a changé, ou renvoyer tout de suite vers l'application.
Question 5 · confirmé
Une tâche système part en boucle et prend un processeur entier. Comment la diagnostiquez-vous avant de l'arrêter ?
Une bonne réponseIdentification de l'espace d'adressage dans SDSF ou RMF Monitor III, puis un SVC dump par la commande DUMP avec les zones utiles, avant toute annulation. Analyse dans IPCS (STATUS, SUMMARY, SYSTRACE pour voir la boucle) ou envoi à IBM ou à l'éditeur avec un dossier ouvert. Ensuite CANCEL, et FORCE seulement si CANCEL échoue.
Signal d'alerteFORCE immédiat, sans dump : la preuve disparaît et l'incident reviendra.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Ingénieur système z/OS : questions fréquentes
Quelle différence entre un ingénieur système z/OS et un ingénieur de production mainframe ?
Le system programmer installe et règle le système : SMP/E, PARMLIB, IPL, sysplex, WLM. L'ingénieur de production fait tourner les applications par-dessus : chaînes batch, ordonnanceur, déploiements, reprises après incident. Les deux lisent du JCL et utilisent SDSF, d'où des CV qui se ressemblent. Une question suffit : la personne a-t-elle déjà préparé un IPL ou appliqué un niveau RSU ? La réponse dit vite de quel côté elle travaille.
Un profil venu d'Unix ou de Linux a-t-il sa chance sur un poste z/OS ?
Oui pour un poste junior, si l'équipe peut former. Les notions de système d'exploitation, de performance et de diagnostic se transposent, mais le vocabulaire et les outils sont propres au mainframe : SMP/E, PARMLIB, coupling facility, WLM. La partie z/OS UNIX et Zowe sera plus familière. Pour un poste confirmé seul sur un périmètre, l'expérience z/OS reste nécessaire, car les erreurs de maintenance se paient par un IPL raté.
Montée de version z/OS sur un CV : quelles précisions attendre ?
La version de départ et d'arrivée, le nombre de systèmes et de sysplex, le rôle tenu (pilote ou exécutant), la méthode d'installation (ServerPac par z/OSMF ou autre) et les PTF de coexistence posés. Le candidat décrit un problème rencontré pendant la migration et la façon dont il a été résolu. Une migration de 2.4 vers 2.5 reste une bonne expérience, mais la personne doit connaître les changements de 3.1 et 3.2.
Un test technique a-t-il un sens sans accès à un mainframe ?
Oui, sous forme écrite ou orale. Le candidat reçoit une HOLDDATA réelle, un extrait de membre PROGxx ou un rapport RMF et dit ce qu'il en tire. Un incident décrit (spool plein, tâche en boucle, CF en maintenance) lui fait aussi dérouler les commandes dans l'ordre. Un exercice de ce type prend trente minutes et montre l'expérience réelle mieux qu'une liste de produits sur le CV.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.