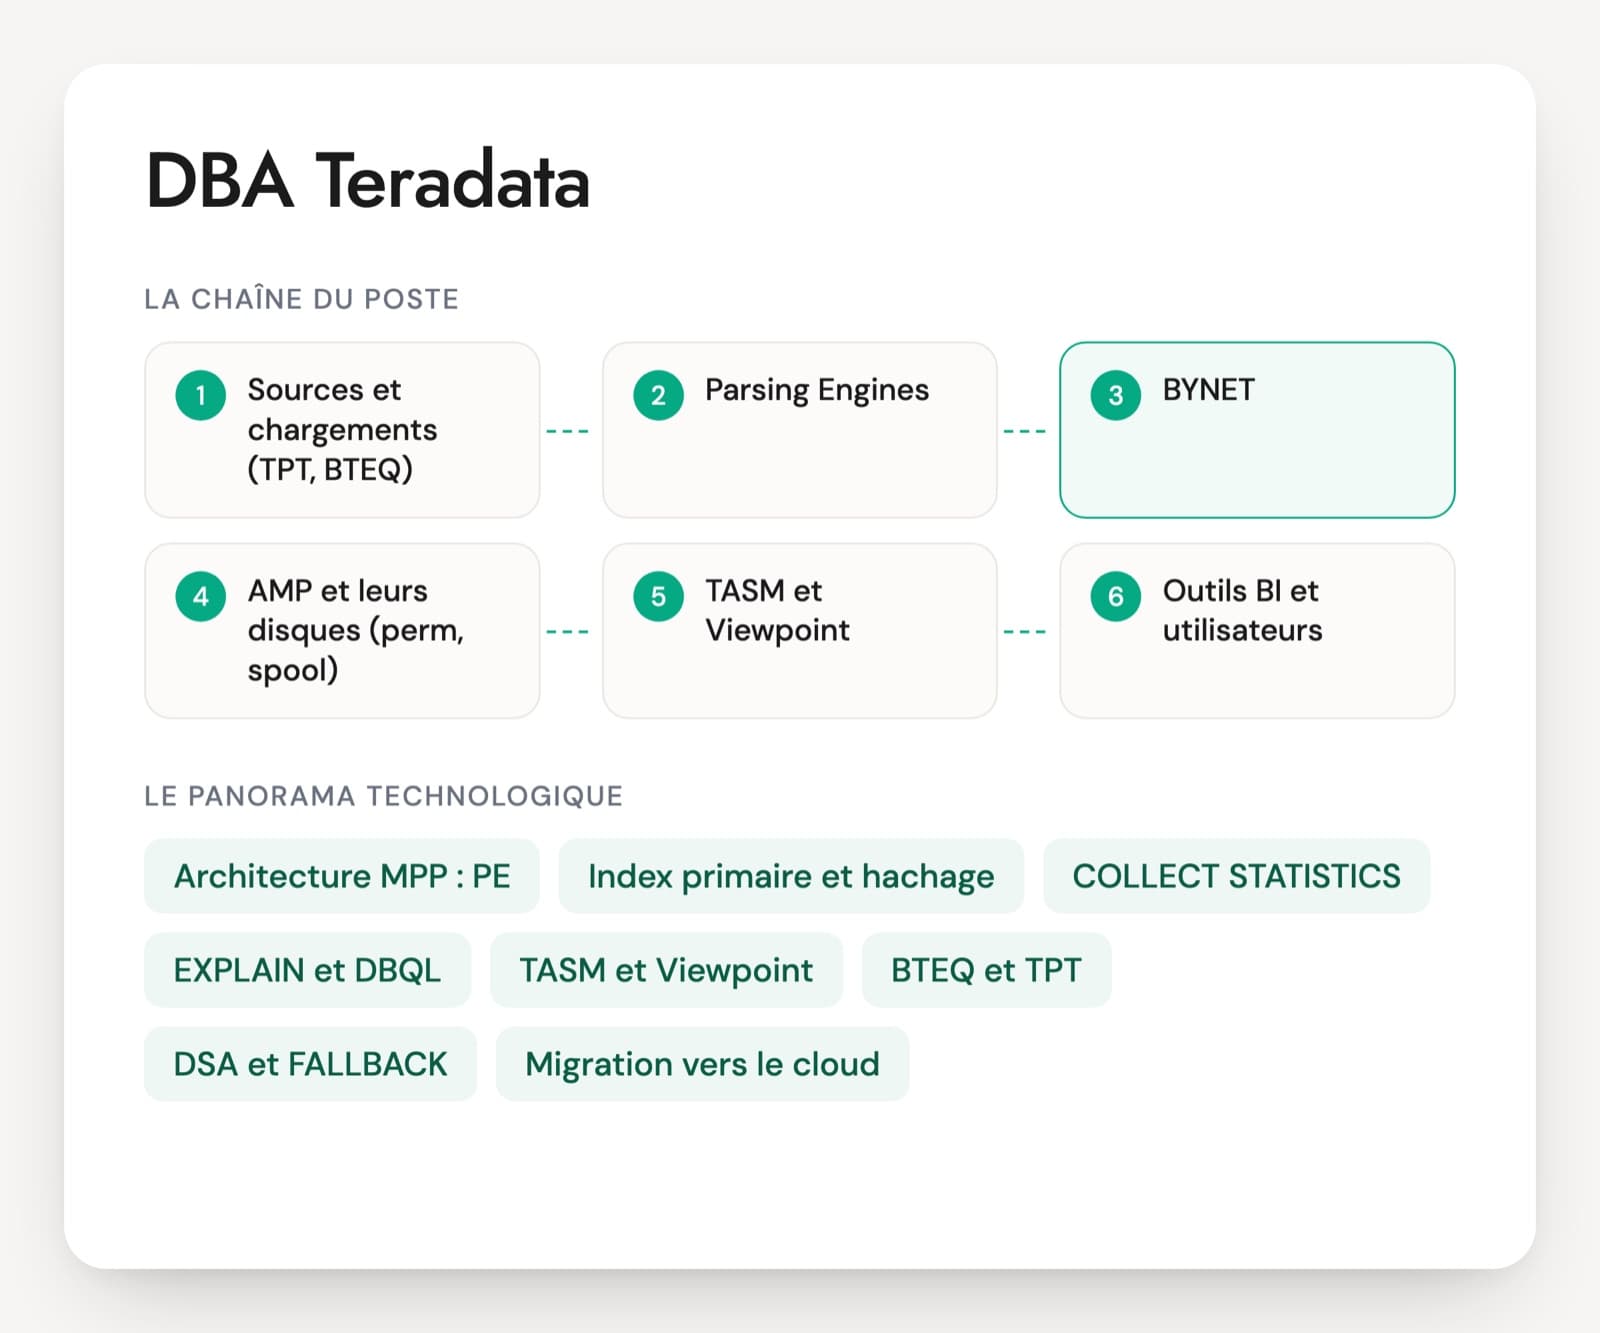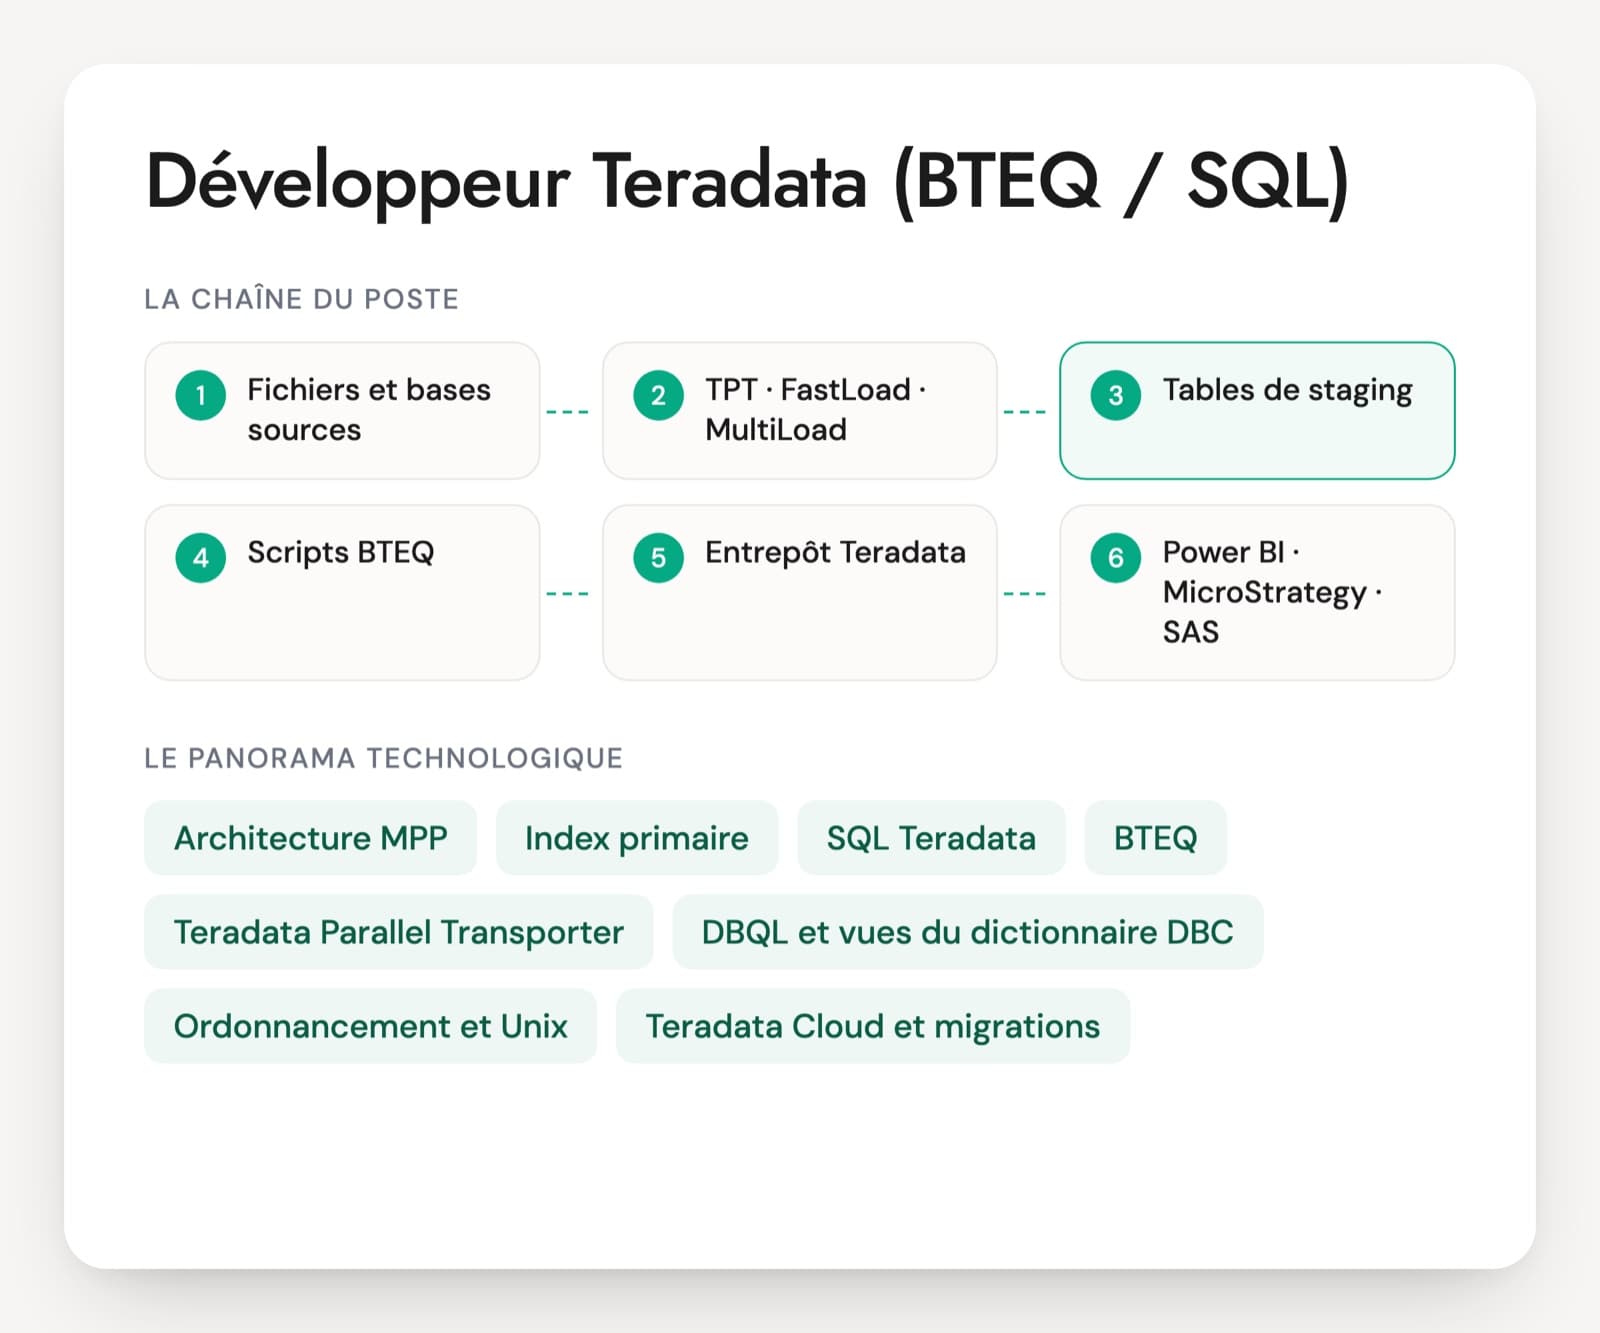
Le développeur Teradata travaille surtout dans les banques, les assurances, la grande distribution et les télécoms, sur des entrepôts installés depuis longtemps. Il écrit du SQL Teradata, enchaîne les requêtes dans des scripts BTEQ lancés par Control-M ou un autre ordonnanceur, et charge les fichiers avec Teradata Parallel Transporter (TPT). Les offres citent souvent aussi Unix, DataStage ou Informatica.
Un CV peut aligner dix ans de SQL sans que la personne ait compris ce qui fait la performance sur Teradata. Tout dépend de l'index primaire, qui décide sur quel processeur (AMP) chaque ligne est rangée. Un mauvais choix déséquilibre la table et fait échouer les requêtes faute de spool. Les profils solides parlent de skew, de statistiques, de plan EXPLAIN et de tables d'erreur sans qu'on les relance.
Montrez au candidat une table dont l'index primaire est mal choisi et faites-lui dire ce qu'il regarde en premier. Un profil qui a exploité Teradata cite la requête de skew qu'il utilise et le seuil qui l'inquiète. Le PDF contient un cas de 20 minutes sur un chargement de mouvements bancaires.
Teradata au quotidien : les outils du développeur
Architecture MPP (AMP, PE, BYNET)
Teradata découpe chaque table entre des dizaines ou des centaines d'unités de traitement, les AMP, qui travaillent en parallèle. Une requête n'est jamais plus rapide que l'AMP le plus chargé. Un développeur qui ignore ce principe écrira du SQL juste mais lent.
Index primaire, PPI et tables NoPI
L'index primaire fixe l'AMP de chaque ligne par hachage. Il sert à la fois à répartir les données et à accéder vite à une ligne. Le PPI ajoute un rangement par partition, souvent par mois, et les tables NoPI servent au chargement de transit. C'est le premier sujet à aborder en entretien.
SQL Teradata, EXPLAIN et statistiques
Le SQL Teradata ajoute des extensions comme QUALIFY. L'EXPLAIN décrit le plan d'exécution en anglais clair, avec un niveau de confiance qui dépend des statistiques collectées (COLLECT STATISTICS). Lire un EXPLAIN fait partie du travail courant.
BTEQ
L'outil en ligne de commande qui exécute des scripts SQL avec des commandes de contrôle (.IF, .QUIT, .EXPORT, .IMPORT). Une grande partie des traitements batch existants est écrite en BTEQ. La gestion des erreurs et des codes retour y est entièrement à la charge du développeur.
Teradata Parallel Transporter (TPT)
L'outil de chargement et d'extraction en masse. Ses opérateurs reprennent les anciens utilitaires : Load pour FastLoad, Update pour MultiLoad, Stream pour TPump, Export pour FastExport. Les CV citent encore souvent les utilitaires seuls, et beaucoup de sites en exploitent toujours.
DBQL et vues du dictionnaire DBC
Les journaux de requêtes (DBQL) et les vues DBC donnent le CPU, les entrées-sorties, l'espace et le skew de chaque requête ou table. Le développeur s'en sert pour diagnostiquer seul un traitement lent avant d'appeler le DBA.
Ordonnancement et Unix
Les scripts BTEQ et TPT tournent depuis des shells Unix lancés par Control-M, $Universe ou un autre ordonnanceur. Les offres demandent le shell, la propagation des codes retour et la reprise d'une chaîne interrompue.
Teradata Cloud et migrations
En mai 2026, Teradata a lancé la Teradata Autonomous Knowledge Platform, déployée en cloud sous le nom Teradata Cloud et sur site avec Teradata Factory. Les CV parlent encore de Vantage, VantageCloud ou IntelliFlex. Beaucoup de missions portent aussi sur la sortie de Teradata vers BigQuery, Snowflake ou Databricks.
On trouve le poste en ESN, chez des clients finaux du secteur bancaire, de l'assurance ou de la distribution, et dans des centres de services qui maintiennent des chaînes batch anciennes. La part de développement neuf varie : certaines missions consistent à faire évoluer un entrepôt, d'autres à le maintenir en condition opérationnelle, d'autres encore à préparer sa migration vers le cloud. Les offres associent souvent Teradata à Control-M, Unix, DataStage ou Informatica. Un développeur qui connaît Teradata en profondeur est précieux pour une migration, car il sait ce que le code existant fait vraiment.
Six compétences Teradata à contrôler
- Choix de l'index primaire et répartition
- Lecture de l'EXPLAIN et statistiques
- Scripts BTEQ robustes
- Chargements TPT et utilitaires
- Types de tables et modélisation
- Diagnostic et exploitation batch
Questions techniques pour un développeur Teradata
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Une table de 2 milliards de lignes a pour index primaire la colonne code_pays. Quels problèmes prévoyez-vous, et que proposez-vous ?
Une bonne réponseTeradata répartit les lignes entre les AMP selon le hachage de l'index primaire. Avec une trentaine de pays, quelques AMP portent presque toute la table : stockage déséquilibré (skew), chargements et requêtes qui attendent l'AMP le plus chargé. La personne propose une colonne très sélective et souvent utilisée en jointure, par exemple l'identifiant de la transaction, en NUPI si l'unicité n'est pas garantie, et garde le pays comme simple filtre ou comme partition si les accès se font par pays.
Signal d'alerte« J'ajoute un index secondaire sur code_pays », sans voir le problème de répartition. Ou ignorer que l'index primaire décide de l'emplacement physique des lignes.
Question 2 · confirmé
Le plan EXPLAIN d'une jointure annonce un product join et une estimation « with no confidence ». Qu'en déduisez-vous ?
Une bonne réponseL'optimiseur n'a pas de statistiques sur les colonnes de jointure ou de filtre, donc il devine les volumes. Le product join vient souvent d'une condition de jointure manquante ou mal écrite (une inégalité, une fonction sur la colonne), ou d'une estimation fausse qui lui fait croire qu'une table est minuscule. La personne relit la condition, collecte les statistiques utiles (COLLECT STATISTICS sur les colonnes de jointure et sur l'index primaire), relance l'EXPLAIN et vérifie que la confiance remonte et que le plan passe à un merge join ou à un hash join.
Signal d'alerteRelancer la requête la nuit, ou demander plus de spool au DBA, sans lire le plan. Ne pas savoir ce que signifie le niveau de confiance.
Question 3 · junior à confirmé
Un script BTEQ enchaîne cinq requêtes. La troisième échoue cette nuit, les deux suivantes tournent quand même et Control-M affiche le job en vert. Comment est-ce possible, et que corrigez-vous ?
Une bonne réponseBTEQ poursuit le script après une erreur si rien ne l'arrête. Le code retour peut aussi être perdu : script qui finit par un .QUIT 0 explicite, ou appel dans un shell qui renvoie le code de la dernière commande (un tee dans un pipe, par exemple). Correction : un .IF ERRORCODE <> 0 THEN .QUIT 8 après chaque requête, un code de sortie différent par étape si besoin, et un wrapper shell qui propage le code (set -o pipefail, test de $?). Les bons profils contrôlent aussi ACTIVITYCOUNT pour arrêter le script quand une insertion ne ramène aucune ligne.
Signal d'alerte« Je regarde le log le matin. » Ou ne pas savoir que BTEQ continue après une erreur.
Question 4 · confirmé
Vous chargez chaque nuit 300 millions de lignes dans une table vide, puis des mises à jour dans une table déjà remplie. Quels opérateurs TPT utilisez-vous ?
Une bonne réponseL'opérateur Load (le protocole de FastLoad) pour la table vide : très rapide, mais pas d'index secondaire, d'index de jointure, de trigger ni d'intégrité référentielle sur la cible. L'opérateur Update (le protocole de MultiLoad) pour la table remplie, avec insertions, mises à jour, suppressions ou upsert par lots. L'opérateur Stream (TPump) pour des petits volumes en continu, avec des verrous par ligne. La personne surveille les tables d'erreur et sait que ces chargements consomment des sessions et des places limitées par le DBA (throttles TASM).
Signal d'alerteDes INSERT ligne à ligne par ODBC ou l'opérateur SQL Inserter pour 300 millions de lignes. Ou ne connaître que FastLoad, sans savoir qu'il exige une table vide.
Question 5 · confirmé
Pourquoi une table SET peut-elle ralentir un chargement, et quand choisissez-vous MULTISET ?
Une bonne réponseUne table SET refuse les lignes strictement identiques. Pour chaque insertion, Teradata compare la ligne aux autres lignes de même hachage d'index primaire : avec un NUPI peu sélectif, ce contrôle coûte cher. Pire, un INSERT SELECT écarte les doublons sans aucune erreur, ce qui peut masquer une perte de données. La personne crée ses tables en MULTISET et garantit l'unicité là où elle compte : UPI, index secondaire unique ou déduplication explicite dans le SQL.
Signal d'alerteNe pas connaître la différence, ou penser que SET et MULTISET ne changent que le nom.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Recruter un développeur Teradata : vos questions
Quelles compétences attendre d'un développeur Teradata ?
Un SQL avancé, avec les fonctions de fenêtre et QUALIFY, et surtout la compréhension de l'index primaire et de la répartition sur les AMP. Ajoutez l'écriture de scripts BTEQ qui gèrent leurs erreurs, les chargements TPT ou les anciens utilitaires FastLoad et MultiLoad, la lecture d'un EXPLAIN et le shell Unix. Selon le poste, un ETL comme DataStage ou Informatica et un ordonnanceur comme Control-M complètent le profil.
Un bon développeur SQL Server ou Oracle peut-il tenir un poste Teradata ?
Oui, avec un temps d'adaptation. Le SQL se transpose bien, l'architecture beaucoup moins. Sur Oracle ou SQL Server, on optimise avec des index. Sur Teradata, on choisit d'abord comment les lignes sont réparties entre les AMP, et un index secondaire en plus ne règle rien. Testez cette bascule en entretien avec une question sur l'index primaire et le skew. Si la personne la comprend vite, la montée en compétence suit.
Quel test technique proposer à un développeur Teradata ?
Un exercice court en entretien. Donnez un EXPLAIN réel avec un product join, ou un script BTEQ qui continue après une erreur, et demandez à la personne de dire ce qu'elle voit et ce qu'elle corrige. Vingt minutes suffisent pour distinguer quelqu'un qui a exploité des chaînes batch de quelqu'un qui a écrit des requêtes isolées. Le cas pratique du PDF suit ce format.
Teradata a-t-il encore de l'avenir pour un candidat ?
Les entrepôts Teradata restent nombreux dans les grandes banques, assurances et enseignes, et beaucoup de missions portent sur leur maintenance ou leur migration. Teradata propose aussi une offre cloud, présentée depuis mai 2026 sous le nom Teradata Cloud. Pour un recruteur, la question est surtout celle du projet : un poste de migration demande en plus une connaissance de la plateforme cible, BigQuery, Snowflake ou Databricks.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.