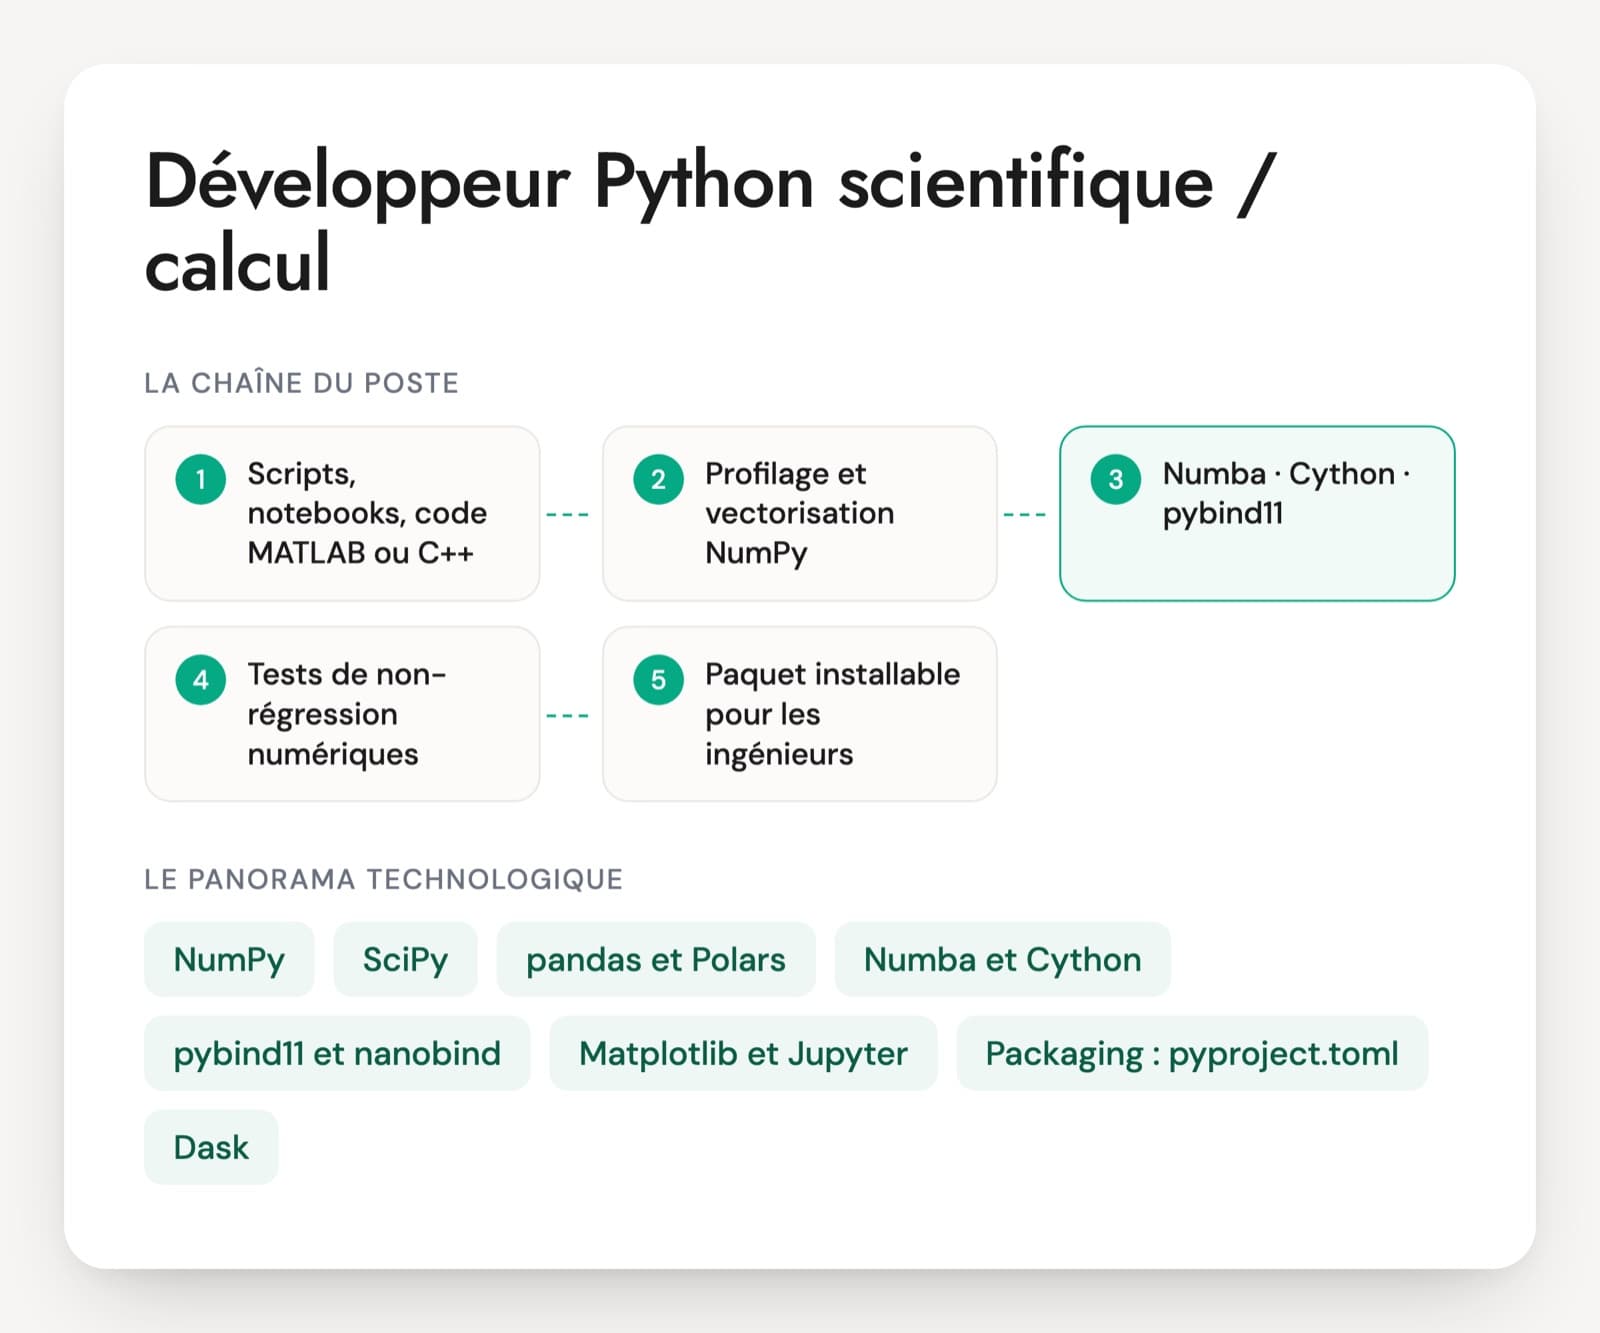
Le développeur Python scientifique travaille avec des ingénieurs calcul, des physiciens ou des quants. Il reprend des scripts et des notebooks, souvent lents et peu testés, et en fait des bibliothèques fiables. Le calcul passe par NumPy et SciPy, les parties critiques par Numba ou Cython, et le code C++ ou Fortran existant est appelé depuis Python. Certaines offres portent aussi sur la migration d'outils MATLAB ou SAS vers Python, avec l'obligation de retrouver les mêmes résultats.
Pour ce poste, les candidatures viennent de deux profils. Le data scientist connaît pandas et scikit-learn, mais a rarement réfléchi aux erreurs d'arrondi, à la mémoire d'un tableau de plusieurs gigaoctets ou au conditionnement d'une matrice. Le scientifique qui code connaît la méthode numérique, et livre parfois un outil impossible à installer sur le poste d'un collègue. Le poste demande les deux moitiés, et l'entretien vérifie la culture numérique autant que le génie logiciel.
Le format le plus parlant consiste à montrer une fonction lente écrite avec des boucles Python, à demander comment l'accélérer, puis comment prouver que le résultat n'a pas changé. Méfiez-vous des réponses qui parlent de vitesse sans jamais parler de tolérance de comparaison. Le PDF ajoute un cas de 20 minutes sur un code de simulation à accélérer.
Les bibliothèques d'un développeur Python scientifique
NumPy
Le tableau multidimensionnel et les opérations vectorisées, base de tout l'écosystème. La version 2, sortie en 2024, a changé les règles de promotion des types et retiré des alias comme np.float_. Un code écrit pour NumPy 1 peut donner un résultat légèrement différent sans aucune erreur, ce qui en fait un bon sujet d'entretien.
SciPy
Les algorithmes numériques : intégration, optimisation, interpolation, algèbre linéaire, matrices creuses, traitement du signal, statistiques. Le développeur doit savoir choisir un solveur, régler ses tolérances et lire ses messages de non-convergence.
pandas et Polars
Pour les données tabulaires, comme des séries temporelles de mesures, des résultats d'essais ou des sorties de simulation. Polars, plus récent, exécute ses requêtes en parallèle et de façon paresseuse, ce qui aide sur les gros volumes.
Numba et Cython
Deux façons d'accélérer une boucle que NumPy ne sait pas vectoriser. Numba compile une fonction Python à la volée grâce à un décorateur, Cython compile un code proche du Python vers du C. Le candidat doit mesurer avant d'optimiser et connaître les limites de chacun : types supportés, temps de compilation, déploiement.
pybind11 et nanobind
Deux bibliothèques pour exposer du code C++ à Python. On s'en sert quand un code de calcul existe déjà en C++, ou quand une partie critique doit y passer. Les questions utiles portent sur le passage des tableaux sans copie et sur la compilation des roues (wheels) pour chaque plateforme.
Matplotlib et Jupyter
Matplotlib produit les figures des rapports et des publications, Jupyter sert à explorer et à montrer un calcul. Le risque est de laisser le notebook devenir l'outil de production. Un bon profil sort le code vers un paquet testé et garde les notebooks pour la démonstration.
Packaging : pyproject.toml, uv, conda
Les utilisateurs sont des ingénieurs qui doivent installer l'outil sans aide. pyproject.toml décrit le paquet, uv ou pip installe depuis PyPI, conda, mamba ou pixi gèrent aussi les dépendances non Python comme BLAS ou un compilateur Fortran. Les extensions compilées pour Linux, Windows et macOS se construisent en CI, souvent avec cibuildwheel.
Dask, multiprocessing et calcul sur cluster
Quand un calcul dépasse une machine ou un cœur : multiprocessing ou concurrent.futures en local, Dask pour découper un tableau trop grand pour la mémoire, mpi4py et un ordonnanceur comme Slurm sur un cluster de calcul.
pytest et tests numériques
Les tests d'un code de calcul comparent des résultats avec une tolérance (numpy.testing.assert_allclose, pytest.approx), vérifient des cas à solution analytique et des propriétés comme la conservation d'une grandeur. Hypothesis génère des entrées variées pour trouver les cas limites.
Les intitulés varient : développeur Python scientifique, ingénieur logiciel scientifique, research software engineer, ingénieur calcul Python, quant developer. Les offres demandent souvent une formation scientifique, doctorat ou école d'ingénieurs, en plus du Python, parce qu'il faut comprendre la méthode numérique pour la coder correctement. Le Fortran et le C++ reviennent dans les annonces, au moins en lecture. La frontière avec le développeur calcul scientifique tient au langage principal : ici Python, avec du code compilé pour les parties critiques.
Calcul et génie logiciel, les compétences à vérifier
- Vectorisation et performance NumPy
- Précision et stabilité numérique
- Algorithmes SciPy et choix des solveurs
- Accélération avec Numba, Cython et C++
- Tests et validation des résultats de calcul
- Packaging et diffusion des outils de calcul
Cinq questions sur la vitesse et la justesse d'un calcul
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Une fonction calcule la distance entre 20 000 points et 500 centres avec deux boucles for imbriquées. Elle met 40 secondes. Comment la réécrivez-vous ?
Une bonne réponseAvec le broadcasting : les points en forme (20 000, 1, d) moins les centres en forme (1, 500, d), mis au carré et sommés sur le dernier axe, ce qui donne une matrice (20 000, 500) calculée en C. Il signale la mémoire : le résultat pèse environ 80 Mo en float64 et le tableau intermédiaire d fois plus, donc un découpage par blocs pour des tailles supérieures. Il cite scipy.spatial.distance.cdist, ou un KDTree si l'on cherche seulement le centre le plus proche. Il compare le résultat à l'ancienne version avant de comparer les temps.
Signal d'alerte« Je mets du multiprocessing » sans toucher aux boucles, ou np.vectorize présenté comme une vectorisation.
Question 2 · junior à confirmé
0.1 + 0.2 == 0.3 renvoie False. Comment comparez-vous des résultats de calcul dans un test ?
Une bonne réponseLes flottants binaires ne représentent pas exactement 0,1. Il compare avec une tolérance relative et une tolérance absolue : numpy.testing.assert_allclose, math.isclose, pytest.approx. Il choisit les valeurs selon le calcul, en fonction de la précision de la méthode et du nombre d'opérations, et sait qu'une tolérance relative seule échoue près de zéro.
Signal d'alerteArrondir à deux décimales avant de comparer, ou comparer avec ==.
Question 3 · confirmé
Une boucle de simulation ne se vectorise pas, car chaque pas dépend du précédent. Comment l'accélérez-vous ?
Une bonne réponseNumba avec @njit sur la fonction de boucle, en lui passant des tableaux NumPy et des types simples, ce qui supprime le coût de l'interpréteur sur chaque itération. Il mesure à part le temps de la première compilation (cache=True pour la réutiliser), vérifie que le résultat reste identique à la tolérance près, et sait que Numba ne couvre qu'une partie de Python et de NumPy. Autres options : Cython avec des types déclarés, ou un noyau C++ exposé avec pybind11 si l'équipe peut le maintenir.
Signal d'alerteDu multiprocessing sur une boucle où chaque pas dépend du précédent, ou l'idée que Numba accélère n'importe quel code Python.
Question 4 · confirmé
Vous remplacez une implémentation lente par une version rapide. Comment prouvez-vous aux ingénieurs que les résultats n'ont pas changé ?
Une bonne réponseUn jeu de cas de référence calculés avec l'ancienne version et enregistrés, comparés avec assert_allclose et des tolérances justifiées. Des cas à solution analytique connue, des propriétés physiques (conservation de la masse ou de l'énergie, symétrie) et des tests de convergence quand on raffine le pas. Les écarts restants sont documentés et expliqués au lieu d'être couverts par une tolérance large.
Signal d'alerte« J'ai regardé les courbes, elles se superposent ».
Question 5 · confirmé
scipy.optimize.minimize renvoie un résultat sans erreur. Que vérifiez-vous avant de l'utiliser ?
Une bonne réponseL'attribut success et le message, le nombre d'itérations, la valeur du gradient ou du critère d'arrêt. Il sait que le résultat peut être un minimum local et teste plusieurs points de départ. Il met les variables à l'échelle, fournit le gradient quand il est connu et choisit la méthode selon le problème : L-BFGS-B avec des bornes, SLSQP ou trust-constr avec des contraintes, Nelder-Mead sans gradient.
Signal d'alertePrendre res.x sans regarder res.success.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Recruter en Python scientifique, les questions fréquentes
Faut-il un doctorat pour ce poste ?
Pas toujours. Le doctorat aide quand le code implémente des méthodes issues de la recherche, ou quand il faut discuter d'égal à égal avec des chercheurs. Pour reprendre et industrialiser des outils existants, un ingénieur avec une bonne base en analyse numérique et une pratique sérieuse du génie logiciel convient souvent mieux. Demandez quelle méthode numérique la personne a codée elle-même et comment elle a validé le résultat.
Un data scientist peut-il occuper ce poste ?
Parfois, si son expérience dépasse pandas et scikit-learn. Vérifiez qu'il compare des flottants avec une tolérance, qu'il sait lire le message d'un solveur qui ne converge pas et qu'il accélère une boucle que NumPy ne vectorise pas. Si son travail s'est fait surtout dans des notebooks, demandez aussi comment il livrerait un paquet installable et testé à une autre équipe.
Quel test technique pour un développeur Python scientifique ?
Une fonction courte, écrite avec des boucles et volontairement lente, fournie avec ses résultats de référence. Demandez de l'accélérer en direct, puis de prouver que le résultat n'a pas changé. Trente à quarante-cinq minutes suffisent. Ajoutez une question orale sur un piège de précision, comme une somme en float32. Vous observez la méthode de mesure et le réflexe de validation.
Faut-il exiger le C++ ou le Fortran ?
Oui si le poste consiste à maintenir ou à interfacer un code compilé existant. La lecture du C++ ou du Fortran, la compilation avec CMake et l'exposition à Python avec pybind11 ou f2py font alors partie du quotidien. Si le poste reste en Python avec NumPy et Numba, une capacité de lecture suffit. Précisez dans l'annonce lequel des deux cas s'applique, les candidats ne se positionnent pas de la même façon.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.