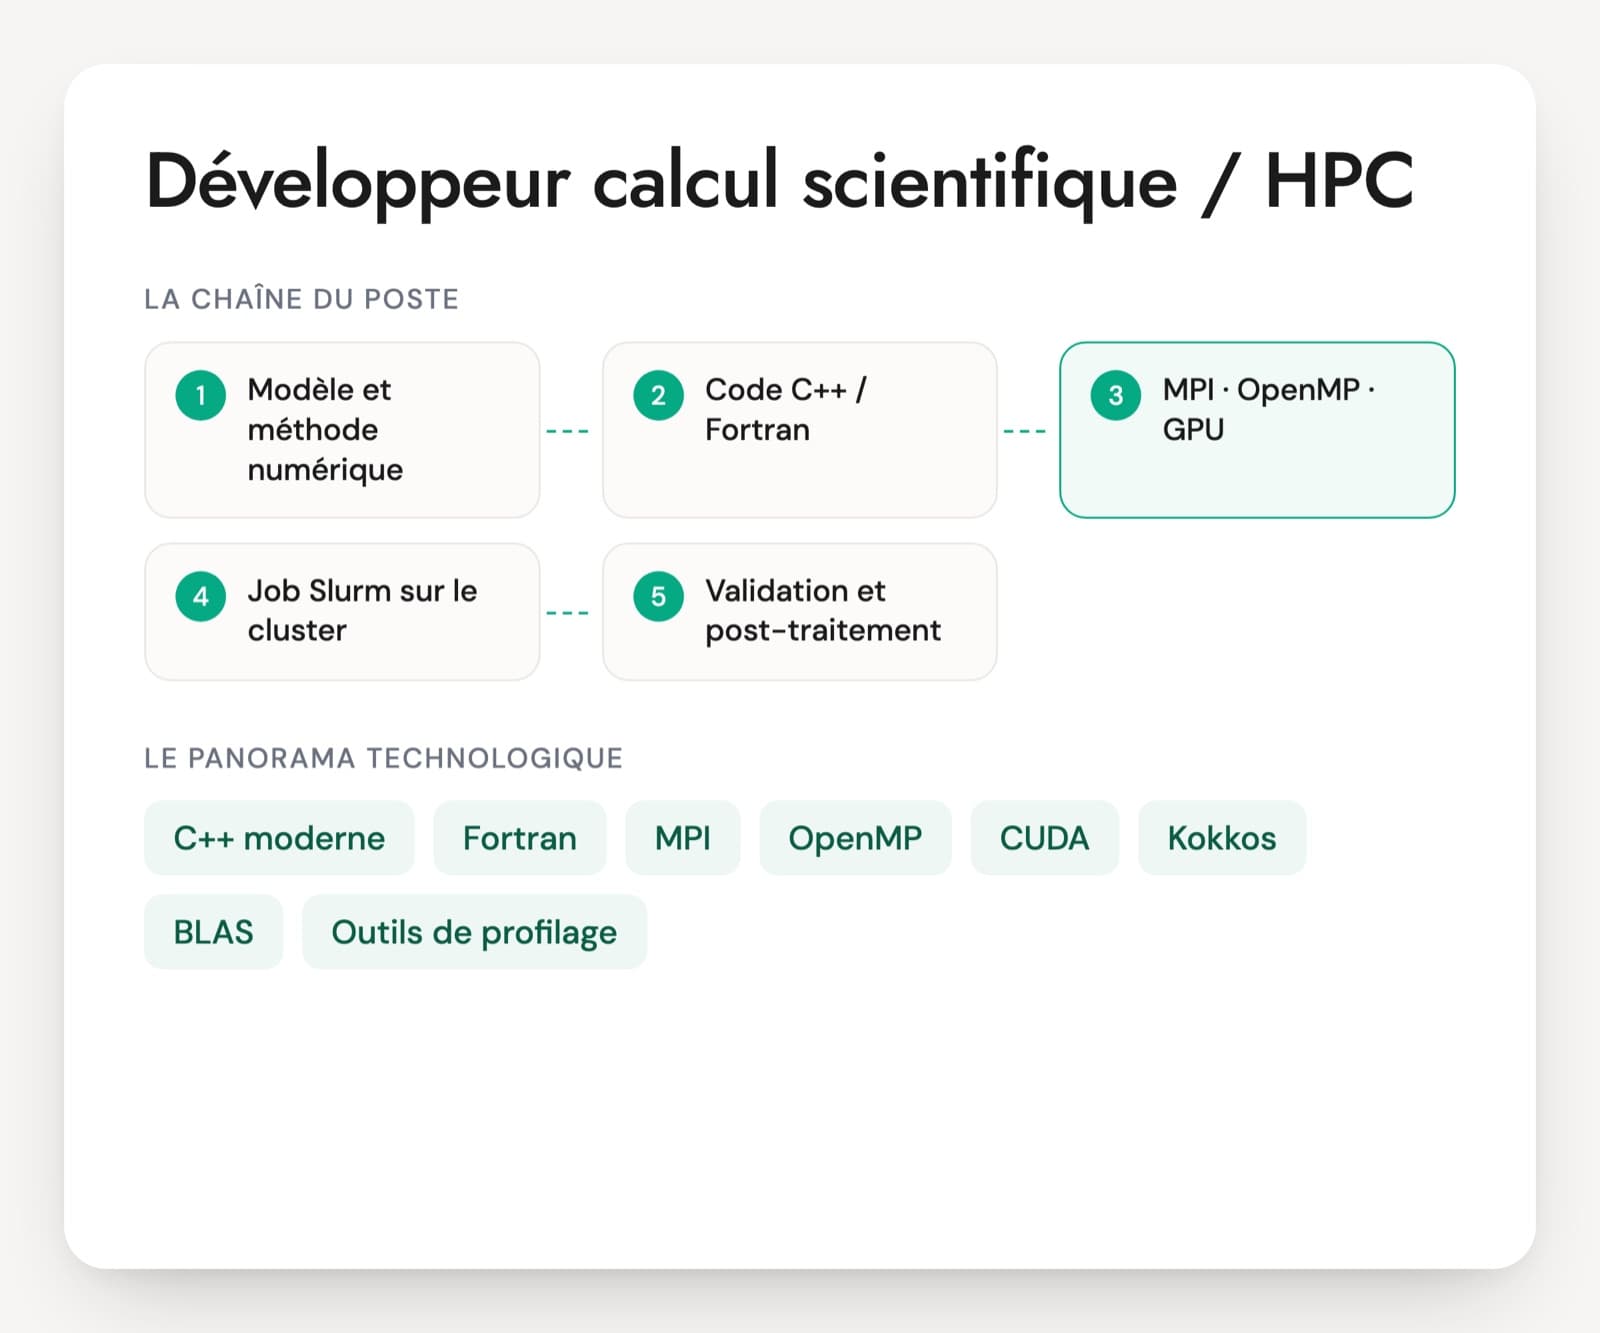
Le développeur calcul scientifique, aussi appelé ingénieur HPC ou ingénieur calcul haute performance, travaille sur des codes de simulation : mécanique des fluides, structures, électromagnétisme, climat, astrophysique. Il programme en C++ moderne ou en Fortran, parallélise avec MPI entre les nœuds et OpenMP à l'intérieur d'un nœud, porte les noyaux de calcul sur GPU avec CUDA, HIP, SYCL ou Kokkos, et lance ses calculs par Slurm sur un cluster ou un supercalculateur.
Ce poste n'est pas celui du développeur Python scientifique, qui écrit surtout des outils autour de NumPy et SciPy. Ici, le code compilé, la mémoire et la communication entre processus occupent la plus grande partie du travail. Beaucoup de candidats sortent d'une thèse : ils connaissent la méthode numérique de leur sujet et ont appris MPI sur le tas. D'autres viennent du génie logiciel et découvrent la précision numérique. Faites décrire un code réel : sa taille, le nombre de cœurs utilisés, la mesure de scalabilité, la validation des résultats.
Avant l'entretien, situez le poste entre deux pôles : concevoir des méthodes numériques et des solveurs, ou porter et optimiser un code existant sur de nouvelles architectures. Le PDF ajoute un cas de 20 minutes sur un solveur de diffusion qui ne gagne plus rien au-delà de 256 cœurs.
Langages, bibliothèques et outils d'un code HPC
C++ moderne
C++17 à C++23 : templates, sémantique de déplacement, bibliothèque standard et, pour le calcul, les vues multidimensionnelles std::mdspan arrivées en C++23. Le code doit rester lisible par des physiciens tout en évitant les copies et les allocations dans les boucles de calcul.
Fortran
Toujours très présent dans les codes de simulation. Le Fortran moderne (2008, 2018) apporte les modules, des tableaux multidimensionnels efficaces et les coarrays. Les codes mixtes C++ et Fortran sont fréquents, et l'interfaçage par iso_c_binding fait partie du métier.
MPI
La norme de communication entre processus, sur un ou plusieurs nœuds : envois point à point, communications collectives, échanges non bloquants. Implémentations courantes : Open MPI, MPICH et ses dérivés comme Intel MPI ou Cray MPICH. Tout code qui dépasse un nœud repose dessus.
OpenMP
Le parallélisme par directives en mémoire partagée, à l'intérieur d'un nœud, et le déchargement sur GPU avec les directives target. Les sujets classiques : variables partagées ou privées, ordonnancement des boucles, placement des threads et premier accès à la mémoire sur les machines NUMA.
CUDA, HIP, SYCL, OpenACC
Les modèles de programmation GPU. CUDA pour NVIDIA, HIP pour AMD avec une syntaxe très proche de CUDA, SYCL comme standard ouvert multi-fabricants (Intel oneAPI, AdaptiveCpp), OpenACC par directives, surtout dans des codes Fortran. Sur GPU, la performance dépend d'abord des transferts et des accès mémoire.
Kokkos
Une bibliothèque C++ de portabilité de performance : le même code source tourne sur CPU avec OpenMP et sur GPU avec CUDA, HIP ou SYCL. Le projet est hébergé par la High Performance Software Foundation, sous l'égide de la Linux Foundation, et revient dans des offres de portage de codes vers les GPU.
BLAS, LAPACK, PETSc, Eigen
Les bibliothèques d'algèbre linéaire. BLAS et LAPACK (OpenBLAS, Intel MKL, cuBLAS sur GPU) pour le dense, Eigen pour les petites matrices en C++, PETSc, hypre ou Trilinos pour les solveurs creux parallèles et les préconditionneurs. Un bon développeur HPC réutilise ces briques au lieu de réécrire un produit de matrices.
Outils de profilage
perf, Intel VTune, NVIDIA Nsight Systems et Nsight Compute, rocprof chez AMD, Score-P et Scalasca pour les codes parallèles, MAQAO pour l'analyse fine des boucles. Le modèle roofline sert à savoir si un noyau est limité par le calcul ou par la bande passante mémoire.
Slurm, Spack et environnement cluster
La soumission des jobs par Slurm, les environnements logiciels par modules ou Spack, les conteneurs Apptainer, les systèmes de fichiers parallèles comme Lustre ou GPFS. Les entrées-sorties de gros volumes passent par MPI-IO, HDF5 parallèle ou ADIOS2.
Le métier mélange trois activités dans des proportions qui changent d'un poste à l'autre : écrire des méthodes numériques (discrétisation, schémas en temps, solveurs), rendre un code parallèle et rapide, maintenir un code de plusieurs centaines de milliers de lignes utilisé par d'autres équipes. Le passage aux machines équipées de GPU pousse beaucoup d'équipes à réécrire leurs noyaux de calcul ou à les porter avec Kokkos, SYCL ou OpenMP target. La validation compte autant que la vitesse : un code deux fois plus rapide qui change la troisième décimale sans explication pose problème. Demandez comment le candidat compare deux versions d'un code et ce qu'il fait de la non-reproductibilité bit à bit des réductions parallèles.
Les compétences à évaluer sur un poste HPC
- C++ moderne et Fortran pour le calcul
- Parallélisme MPI et OpenMP
- Programmation et portage GPU
- Méthodes numériques et algèbre linéaire
- Précision, validation et reproductibilité
- Profilage, scalabilité et environnement cluster
Cinq questions sur un code parallèle qui doit aller plus vite
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Une boucle sur un tableau 3D de 512³ valeurs tourne quatre fois plus lentement en C++ que dans la version Fortran d'origine. Quelles causes cherchez-vous ?
Une bonne réponseL'ordre de parcours d'abord : Fortran range les tableaux par colonnes, C++ par lignes, donc une boucle traduite telle quelle parcourt la mémoire avec un grand pas et rate le cache. Ensuite l'aliasing : le compilateur Fortran suppose que les tableaux ne se chevauchent pas, en C++ il faut l'aider (restrict, copies locales des pointeurs) pour qu'il vectorise. La personne lit le rapport de vectorisation du compilateur (-fopt-info-vec, -qopt-report) et vérifie que le tableau est un bloc contigu et pas un vecteur de vecteurs.
Signal d'alerte« Le Fortran est plus rapide par nature », ou un vector<vector<vector<double>>> jugé normal pour un champ 3D.
Question 2 · senior
Votre code MPI accélère bien de 32 à 256 cœurs, puis le temps ne baisse plus à 1 024 cœurs. Comment cherchez-vous la cause ?
Une bonne réponseMesurer la part de calcul et de communication de chaque processus, avec un profileur MPI ou des minuteries, puis regarder : surface des sous-domaines qui grandit par rapport à leur volume, collective comme MPI_Allreduce appelée à chaque itération, déséquilibre de charge, partie restée séquentielle (entrées-sorties, initialisation). Pistes : recouvrir les échanges de halos par le calcul avec des communications non bloquantes, réduire le nombre de collectives, repartitionner le maillage, passer en hybride MPI et OpenMP.
Signal d'alerte« Il faut plus de nœuds », ou citer la loi d'Amdahl sans avoir rien mesuré.
Question 3 · confirmé
Vous portez un noyau de calcul sur GPU et il tourne plus lentement que sur CPU. Que regardez-vous en premier ?
Une bonne réponseLes transferts entre CPU et GPU, souvent faits à chaque itération alors que les données devraient rester sur le GPU. Puis l'accès mémoire dans le noyau : accès coalescés (threads voisins qui lisent des adresses voisines), occupation, divergence de branches, multitude de petits lancements de noyaux. La personne mesure avec Nsight Systems pour la chronologie et Nsight Compute, ou rocprof sur AMD, pour le noyau lui-même.
Signal d'alerteChanger le nombre de threads par bloc au hasard, ou conclure que « le problème n'est pas fait pour le GPU » sans profilage.
Question 4 · senior
Un solveur itératif sur une matrice creuse de 50 millions d'inconnues converge de plus en plus lentement quand le maillage s'affine. Que proposez-vous ?
Une bonne réponseLe nombre d'itérations d'un gradient conjugué ou d'un GMRES suit le conditionnement de la matrice, qui se dégrade avec la finesse du maillage. Il faut un meilleur préconditionneur : multigrille algébrique (BoomerAMG de hypre, GAMG de PETSc) pour les problèmes elliptiques, décomposition de domaine, ou ILU par blocs. Le solveur se choisit selon la matrice (symétrique définie positive ou non), en suivant l'évolution du résidu.
Signal d'alerteAugmenter le nombre maximal d'itérations, ou passer à un solveur direct sans estimer la mémoire nécessaire.
Question 5 · confirmé
Après une optimisation, la simulation donne des résultats qui diffèrent à la sixième décimale. Comment décidez-vous si c'est acceptable ?
Une bonne réponseD'abord trouver d'où vient l'écart : ordre des opérations changé (réduction parallèle, vectorisation), options du compilateur comme -ffast-math ou la fusion en FMA. Puis comparer à une référence (solution analytique, cas test validé) avec une tolérance justifiée par la précision du schéma, regarder si l'écart grandit au fil du temps et vérifier les grandeurs conservées (masse, énergie). Un écart borné et expliqué est acceptable ; un écart qui croît ne l'est pas.
Signal d'alerte« Tant que les courbes se superposent à l'œil », ou exiger une égalité bit à bit sans savoir pourquoi elle se perd.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Recrutement en calcul scientifique : thèse, Fortran, test
Quelle différence avec un développeur Python scientifique ?
Le développeur Python scientifique écrit surtout des outils de calcul et de post-traitement avec NumPy, SciPy et parfois Numba, sur un poste ou un petit serveur. Le développeur HPC travaille sur des codes compilés en C++ ou en Fortran, répartis sur des centaines de processus avec MPI et portés sur GPU. Les deux partagent la rigueur numérique. Les questions sur la mémoire, les communications et le passage à l'échelle ne concernent vraiment que le second.
Faut-il exiger un doctorat pour un poste HPC ?
Non, sauf si le poste consiste à concevoir des méthodes numériques nouvelles. Une thèse en simulation donne souvent une bonne pratique de MPI et d'un code réel, mais pas toujours les habitudes de génie logiciel : tests, revue de code, intégration continue. Un ingénieur sans thèse qui a porté un code sur GPU ou mené une étude de scalabilité peut tout à fait convenir. Jugez sur les codes décrits, pas sur le diplôme.
Quel test technique proposer à un développeur calcul scientifique ?
Un noyau court en C++ ou en Fortran, par exemple un stencil 3D ou un produit matrice-vecteur creux, à paralléliser avec OpenMP puis à commenter : ordre des boucles, accès mémoire, résultat attendu. Ajoutez une lecture de sortie de profileur ou de courbe de scalabilité réelle. Une heure suffit. Le but est de voir la méthode de mesure et le raisonnement, pas la mémoire des options du compilateur.
Fortran est-il encore un critère de recrutement ?
Oui, quand le code du poste est en Fortran, ce qui arrive souvent pour des codes de simulation qui ont plusieurs décennies d'histoire. Un bon développeur C++ apprend le Fortran moderne en quelques semaines, à condition de comprendre le stockage en colonnes et l'interfaçage avec C. L'inverse est plus long : passer d'un Fortran 77 procédural à un C++ moderne bien structuré demande un vrai accompagnement.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.