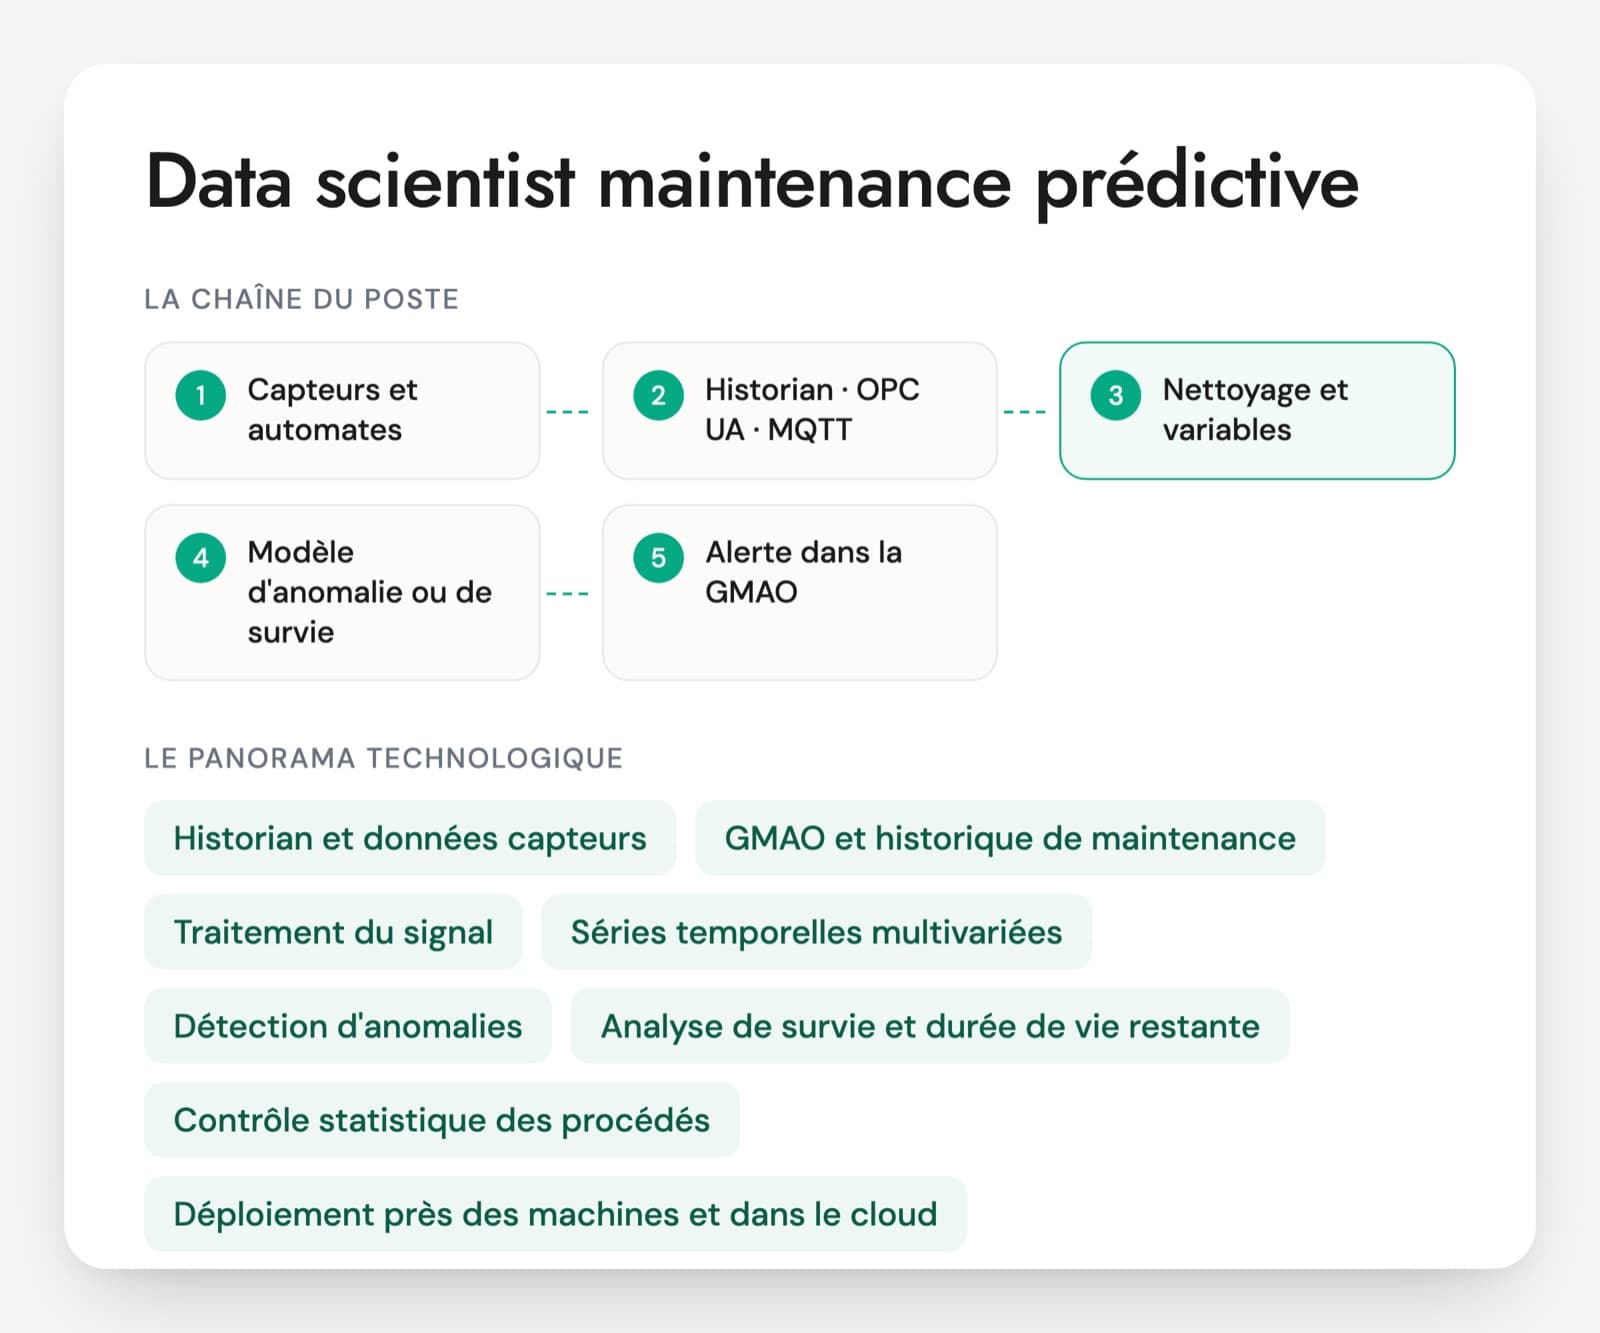
Un data scientist en maintenance prédictive travaille sur des machines en service : moteurs, pompes, compresseurs, matériel roulant. Il exploite les mesures de vibration, de température ou de pression stockées dans un historian, les croise avec les ordres de travail de la GMAO et construit des modèles qui repèrent une dérive ou estiment la durée de vie restante d'un composant. On le recrute chez les industriels de l'aéronautique, de l'automobile, du ferroviaire ou de l'énergie, chez les éditeurs de solutions de maintenance et en ESN.
La difficulté se voit dès le CV. Beaucoup de projets cités reposent sur le jeu public C-MAPSS de la NASA, où chaque moteur simulé va jusqu'à la panne avec des étiquettes propres. Sur un site, les pannes se comptent sur les doigts d'une main, la plupart des pièces sont changées avant de casser et les capteurs décrochent. Un profil qui connaît ce terrain parle de censure, de fausses alertes et de régimes de fonctionnement spontanément.
Pour un projet qui n'a encore aucun modèle en production, les questions sur les étiquettes de panne et sur le coût d'une fausse alerte vous en apprendront le plus. Le PDF déroule l'entretien complet : 30 questions sur six axes, un cas de 20 minutes sur une flotte de pompes, une grille de 1 à 4.
Les méthodes de la maintenance prédictive, du signal à l'analyse de survie
Historian et données capteurs
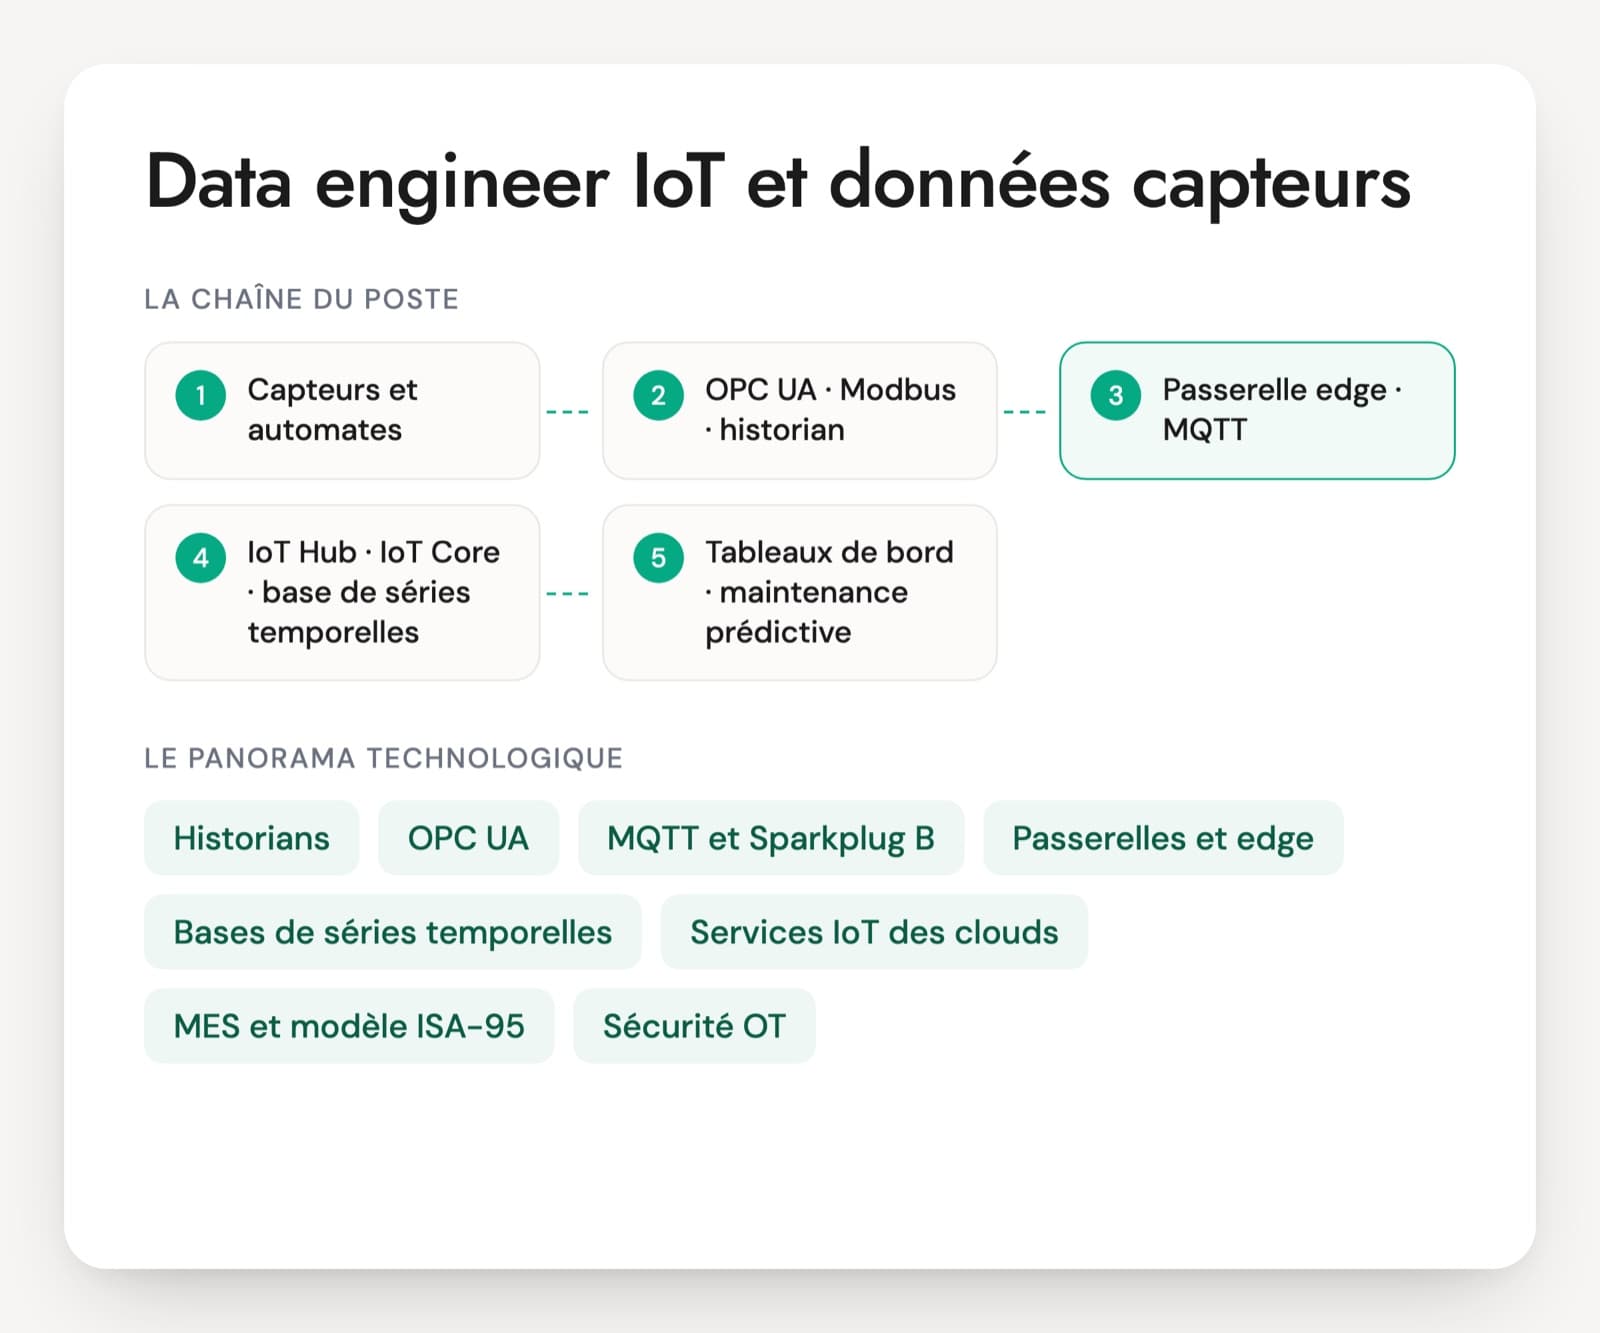
Les mesures des machines sont archivées dans un historian, comme AVEVA PI System (l'ancien OSIsoft PI), ou remontent par OPC UA et MQTT vers un data lake. Les fréquences vont d'une valeur par minute à plusieurs milliers par seconde pour une vibration. Le data scientist doit savoir ce que l'historian compresse et comment rééchantillonner sans perdre le signal utile.
GMAO et historique de maintenance
La GMAO (SAP PM, IBM Maximo, CARL Source) contient les ordres de travail, les pièces changées et les codes de panne. C'est la source des étiquettes, souvent saisies à la main et incomplètes. Un candidat expérimenté a passé du temps à relier un ordre de travail à une période de mesures.
Traitement du signal
Pour une machine tournante, le spectre d'une vibration en dit plus que sa valeur moyenne. FFT, analyse d'enveloppe, filtrage et indicateurs comme le RMS ou le kurtosis s'écrivent en Python avec NumPy et SciPy. Sur un poste centré sur les roulements ou les engrenages, demandez un exemple vécu.
Séries temporelles multivariées
Le quotidien consiste à construire des variables sur des fenêtres glissantes, aligner des capteurs aux fréquences différentes et tenir compte du régime de fonctionnement (charge, vitesse, produit fabriqué). Des bibliothèques comme tsfresh, sktime ou aeon aident. Le découpage des données dans le temps reste le point qui trahit le plus vite un manque de pratique.
Détection d'anomalies
Quand les pannes manquent pour un apprentissage supervisé, on apprend le fonctionnement normal et on signale ce qui s'en écarte, avec un Isolation Forest, une ACP et sa statistique T² de Hotelling ou un autoencodeur. Le plus dur est de fixer le seuil d'alerte avec les équipes de maintenance, qui jugeront l'outil sur ses fausses alertes.
Analyse de survie et durée de vie restante (RUL)
La durée de vie restante (remaining useful life) s'estime avec des modèles de survie : loi de Weibull, modèle de Cox, forêts de survie, avec lifelines ou scikit-survival. Ces modèles gèrent les pièces remplacées avant la panne, dont on ignore la durée de vie réelle. Une régression classique les traite mal.
Contrôle statistique des procédés (SPC)
Cartes de contrôle de Shewhart, CUSUM et EWMA, indices de capabilité : ce sont les outils historiques de la qualité en usine. Les ingénieurs méthodes et qualité les utilisent depuis longtemps, et un data scientist qui les ignore aura du mal à se faire entendre sur un site. Ils servent aussi de référence simple avant un modèle plus lourd.
Déploiement près des machines et dans le cloud
Les modèles tournent sur une passerelle installée près de la machine (edge) ou dans le cloud, avec Azure IoT, AWS IoT SiteWise ou une plateforme interne. Le réseau industriel (OT) est séparé du réseau de gestion, ce qui limite ce qu'on peut y installer. Le service Azure AI Anomaly Detector a été retiré le 1er octobre 2026, Microsoft renvoie vers Fabric ou vers sa version open source.
Le poste change selon l'employeur. Chez un industriel, le data scientist travaille avec les équipes maintenance et fiabilité d'un ou plusieurs sites et gagne leur confiance alerte après alerte. Chez un éditeur ou un intégrateur de solutions de maintenance, il construit des modèles qui serviront à plusieurs clients, sur des machines qu'il ne verra jamais. En ESN, il arrive souvent sur un projet déjà lancé, avec des données dont personne n'a vérifié la qualité. Partout, l'expérience se mesure à la façon de parler des pannes : leur nombre, leur étiquetage, leur coût et ce qu'on fait d'une alerte.
Ce qu'un data scientist doit maîtriser pour prédire une panne
- Données capteurs et traitement du signal
- Séries temporelles multivariées
- Détection d'anomalies et seuils d'alerte
- Analyse de survie et durée de vie restante
- Évaluation sur pannes rares
- Mise en production près des machines
Questions sur des données de capteurs réelles, pannes rares comprises
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Le site vous donne deux ans de mesures et douze pannes recensées dans la GMAO. Comment construisez-vous vos étiquettes ?
Une bonne réponseEn reliant chaque panne à une fenêtre de mesures qui la précède, avec une date de début de dégradation discutée avec les techniciens. La date de l'ordre de travail ne suffit pas, la dégradation commence souvent bien avant. La personne vérifie que les ordres retenus sont des pannes et pas des visites préventives, écarte les arrêts et les périodes de maintenance, et dit que douze événements ne suffisent pas pour un classifieur fiable. Elle propose alors une détection d'anomalies ou un modèle de survie, et garde les pannes connues pour la validation.
Signal d'alertePrendre les codes de la GMAO tels quels, lancer un XGBoost sur les douze pannes et annoncer 99 % de précision, obtenue parce que presque toutes les fenêtres sont normales.
Question 2 · confirmé
Votre modèle d'anomalies déclenche quinze alertes par semaine et les techniciens ont cessé de les regarder. Que faites-vous ?
Une bonne réponseD'abord compter, avec les techniciens, combien d'alertes correspondaient à un vrai problème. Puis chercher la cause des fausses alertes : changement de régime (démarrage, changement de produit, charge), capteur défaillant, seuil fixe trop bas. Le correctif passe par le régime de fonctionnement ajouté au modèle, une anomalie qui doit persister sur plusieurs points avant d'alerter et un seuil fixé à partir du nombre d'alertes que l'équipe peut traiter.
Signal d'alerteMonter le seuil jusqu'à ce que les alertes disparaissent sans regarder les pannes manquées, ou réentraîner un modèle plus complexe sans savoir d'où viennent les alertes.
Question 3 · senior
Une partie des roulements a été remplacée avant de casser. Comment en tenez-vous compte pour estimer leur durée de vie restante ?
Une bonne réponseCe sont des données censurées à droite : on sait seulement que le roulement a tenu jusqu'au remplacement. Un modèle de survie (Weibull, Cox, forêt de survie) les intègre directement. Les écarter biaise l'estimation vers des durées courtes, les compter comme des pannes la fausse aussi. L'évaluation se fait avec un indice de concordance ou un score de Brier adapté à la censure. Un bon profil ajoute que la maintenance préventive en place réduit le nombre de pannes observables.
Signal d'alerteSupprimer les pièces remplacées pour ne garder que celles allées jusqu'à la panne, ou poser une régression sur la durée de vie comme si toutes les durées étaient connues.
Question 4 · confirmé
Comment découpez-vous vos données d'entraînement et de test sur une flotte de quarante machines ?
Une bonne réponseDans le temps, jamais au hasard : deux fenêtres glissantes voisines se ressemblent et un découpage aléatoire gonfle les scores. Selon l'usage visé, des machines entières sont aussi réservées au test, pour vérifier que le modèle marche sur un équipement qu'il n'a jamais vu. Les variables ne sont calculées qu'avec les mesures disponibles à l'instant de la prédiction, et les normalisations sont apprises sur l'entraînement seul.
Signal d'alerteUn train_test_split aléatoire sur les fenêtres, avec des scores excellents qui s'effondrent en production.
Question 5 · confirmé
Un capteur de température décroche pendant trois heures, puis revient avec un décalage de deux degrés. Comment votre chaîne le gère-t-elle ?
Une bonne réponseDeux problèmes distincts. Le trou de données ne se comble pas par interpolation sur une longue durée. La dérive se repère en comparant avec des capteurs voisins ou redondants. Quand l'entrée est douteuse, le modèle doit s'abstenir plutôt que lancer une alerte. Un profil expérimenté connaît aussi les valeurs figées qu'un historian renvoie quand la mesure ne bouge plus.
Signal d'alerteUn fillna avec la dernière valeur, puis le modèle tourne comme si de rien n'était, ou une alerte de panne déclenchée par un capteur cassé.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Recruter en maintenance prédictive, les questions des managers
Faut-il un ingénieur mécanique ou un data scientist généraliste pour la maintenance prédictive ?
Les deux parcours existent. Un ingénieur mécanique ou fiabiliste comprend les modes de défaillance et parle le langage des équipes de maintenance, mais il doit prouver son niveau en Python et en statistiques. Un data scientist généraliste maîtrise les modèles et doit montrer qu'il sait lire un signal et un historique de pannes. En entretien, la question sur les étiquettes et celle sur la censure révèlent vite ce qui manque à chacun.
Maintenance prédictive et maintenance conditionnelle, quelle différence pour le poste ?
La maintenance conditionnelle déclenche une intervention quand une mesure franchit un seuil fixé à l'avance, par exemple une vibration trop forte. La maintenance prédictive cherche à anticiper la panne à partir de tendances et de modèles, parfois en estimant une durée de vie restante. Beaucoup de projets commencent par améliorer des seuils conditionnels existants. Vérifiez que le candidat sait dire ce que son modèle apporte par rapport à un seuil bien réglé.
Un projet sur le jeu de données C-MAPSS de la NASA compte-t-il comme une expérience ?
C'est une bonne base d'apprentissage, très utilisée dans les cours et les articles. Ses moteurs simulés vont tous jusqu'à la panne, avec des étiquettes propres, ce qui n'arrive presque jamais sur un site. Comptez-le comme une preuve de méthode, pas comme une expérience industrielle. Demandez ce qui changerait avec cinq pannes réelles et des capteurs qui décrochent : la réponse montre si la personne mesure l'écart.
Quel test technique proposer sans sortir les données de l'usine ?
Un jeu de données simulé ou anonymisé suffit : quelques capteurs, un régime de fonctionnement qui change, des trous, une dérive et trois ou quatre pannes. Demandez un découpage entre entraînement et test, une proposition de modèle et un seuil d'alerte justifié, en une heure au plus. Faites commenter le travail à voix haute. Vous verrez la méthode, ce qu'un score obtenu sur un classement public ne montre pas.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.