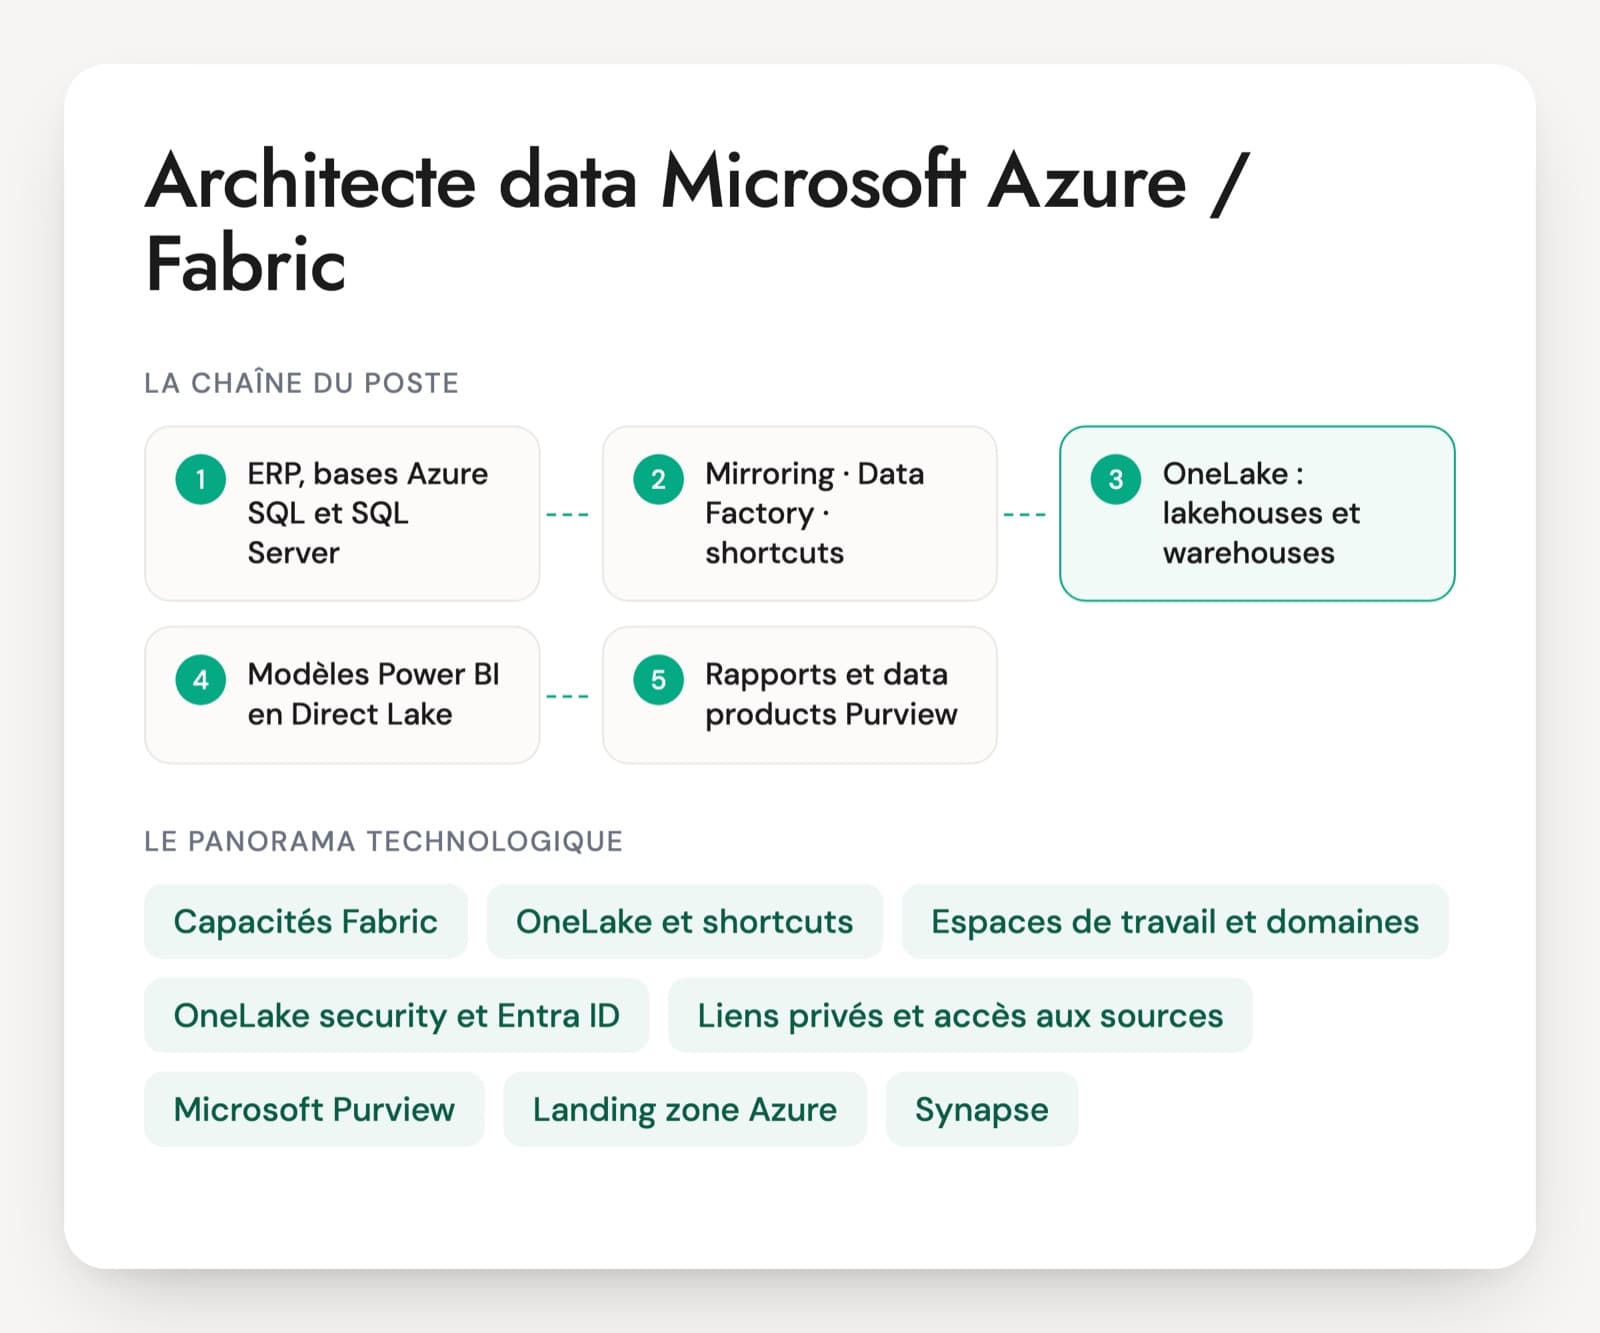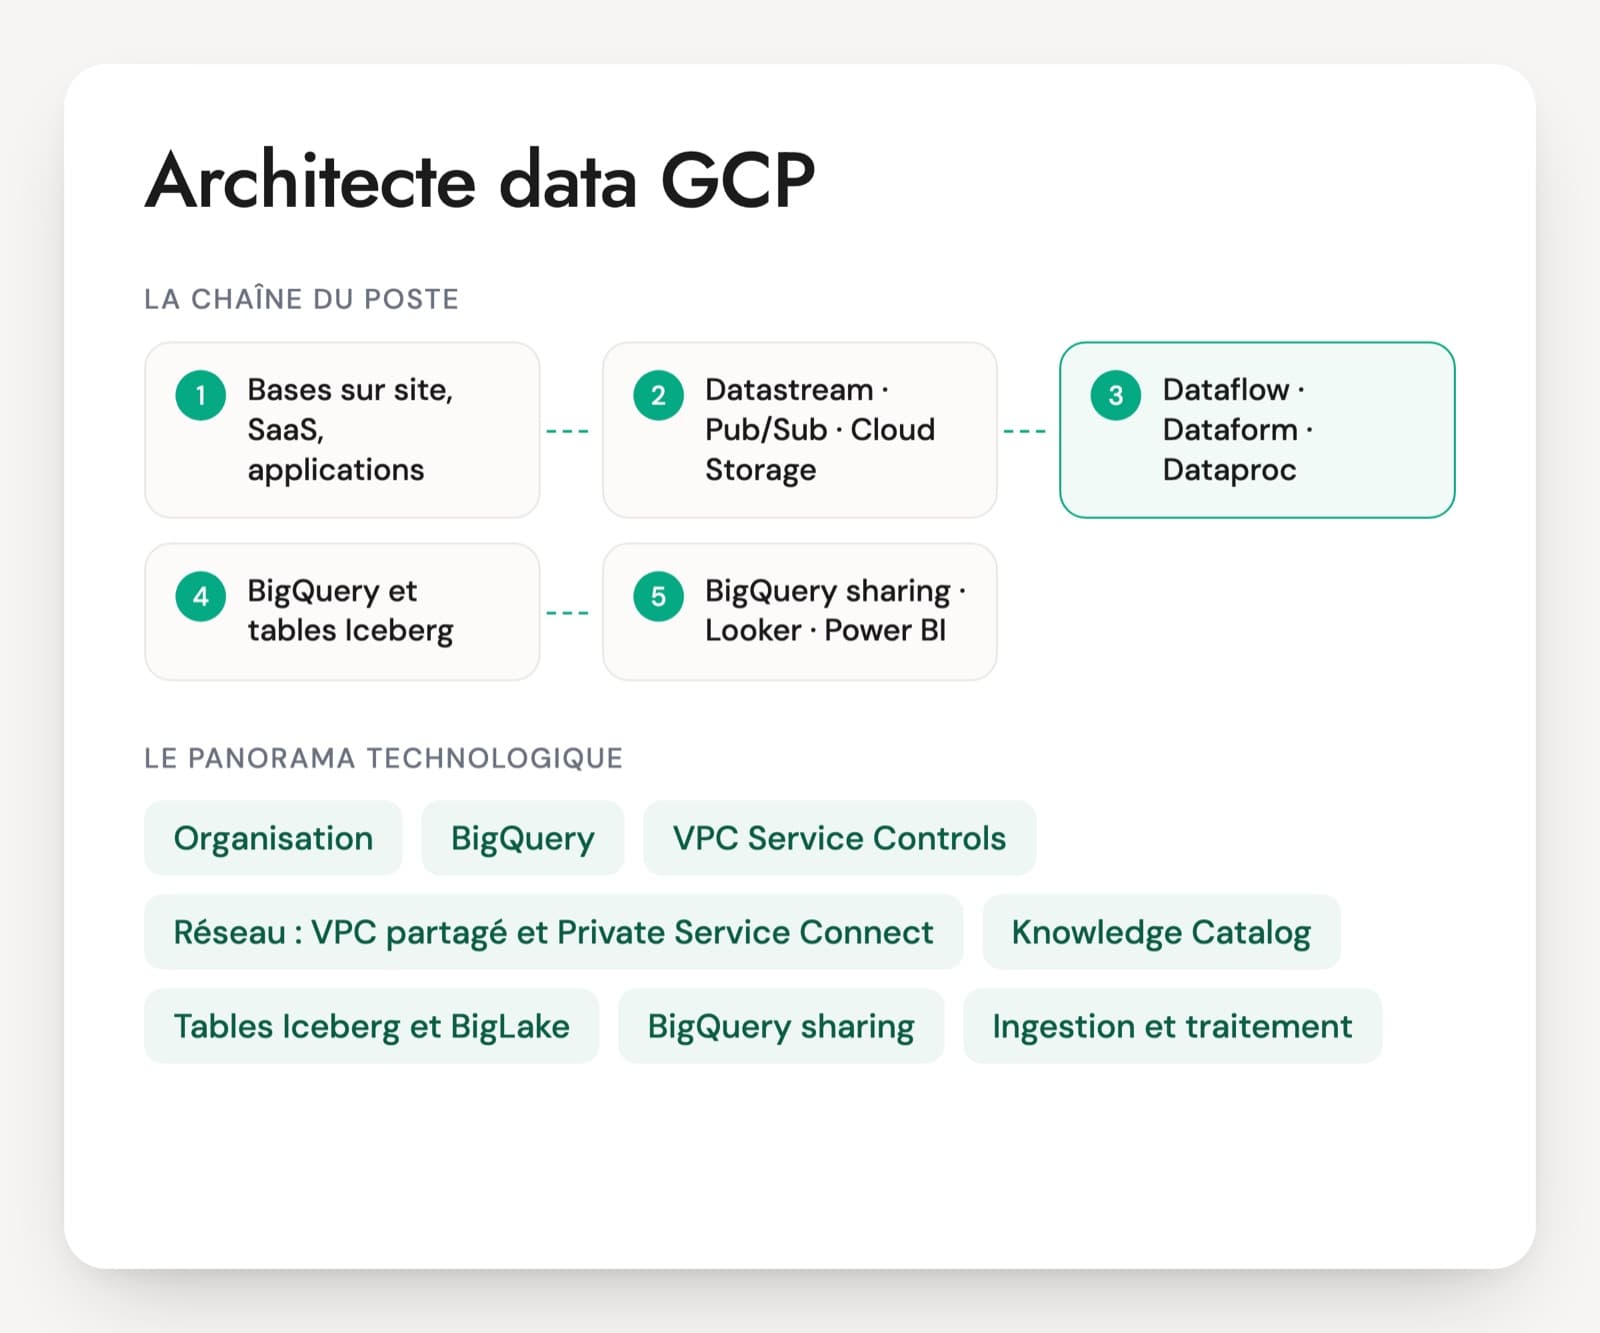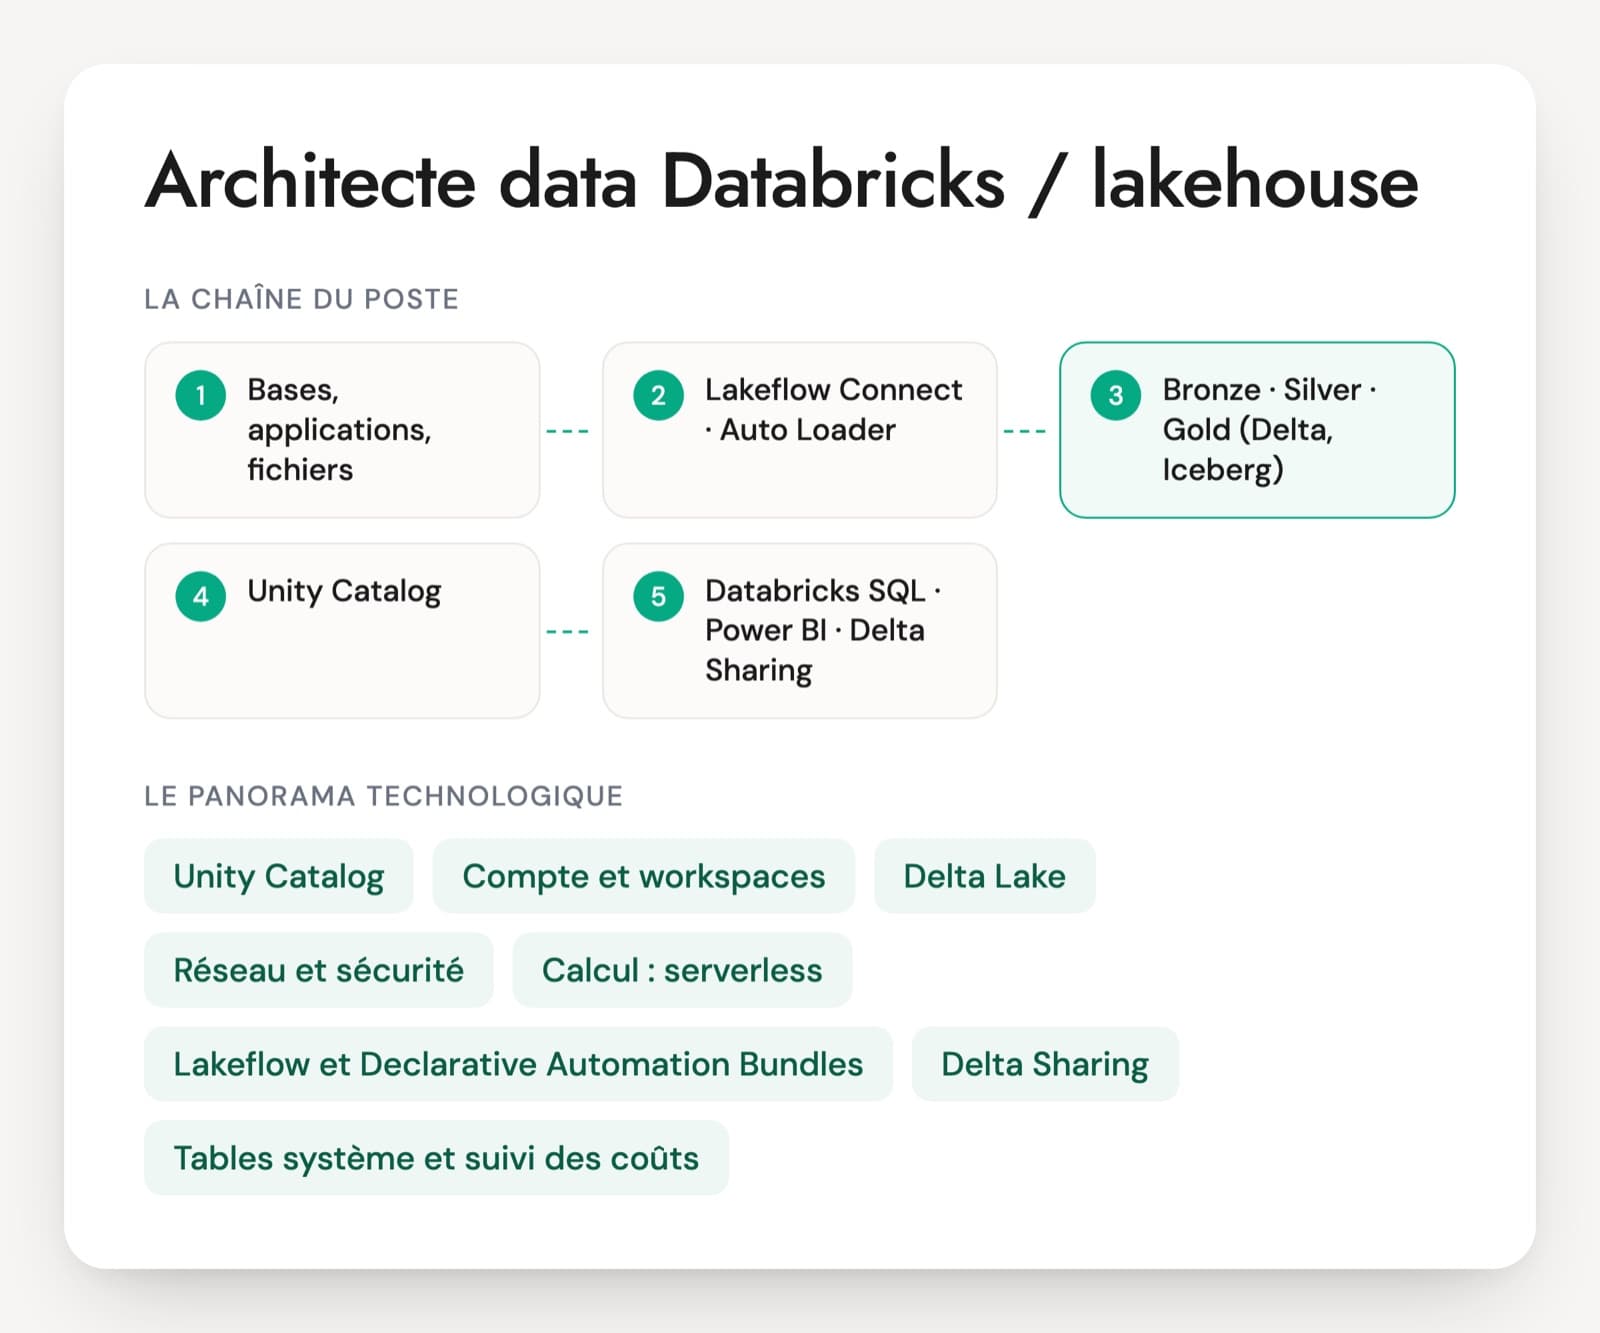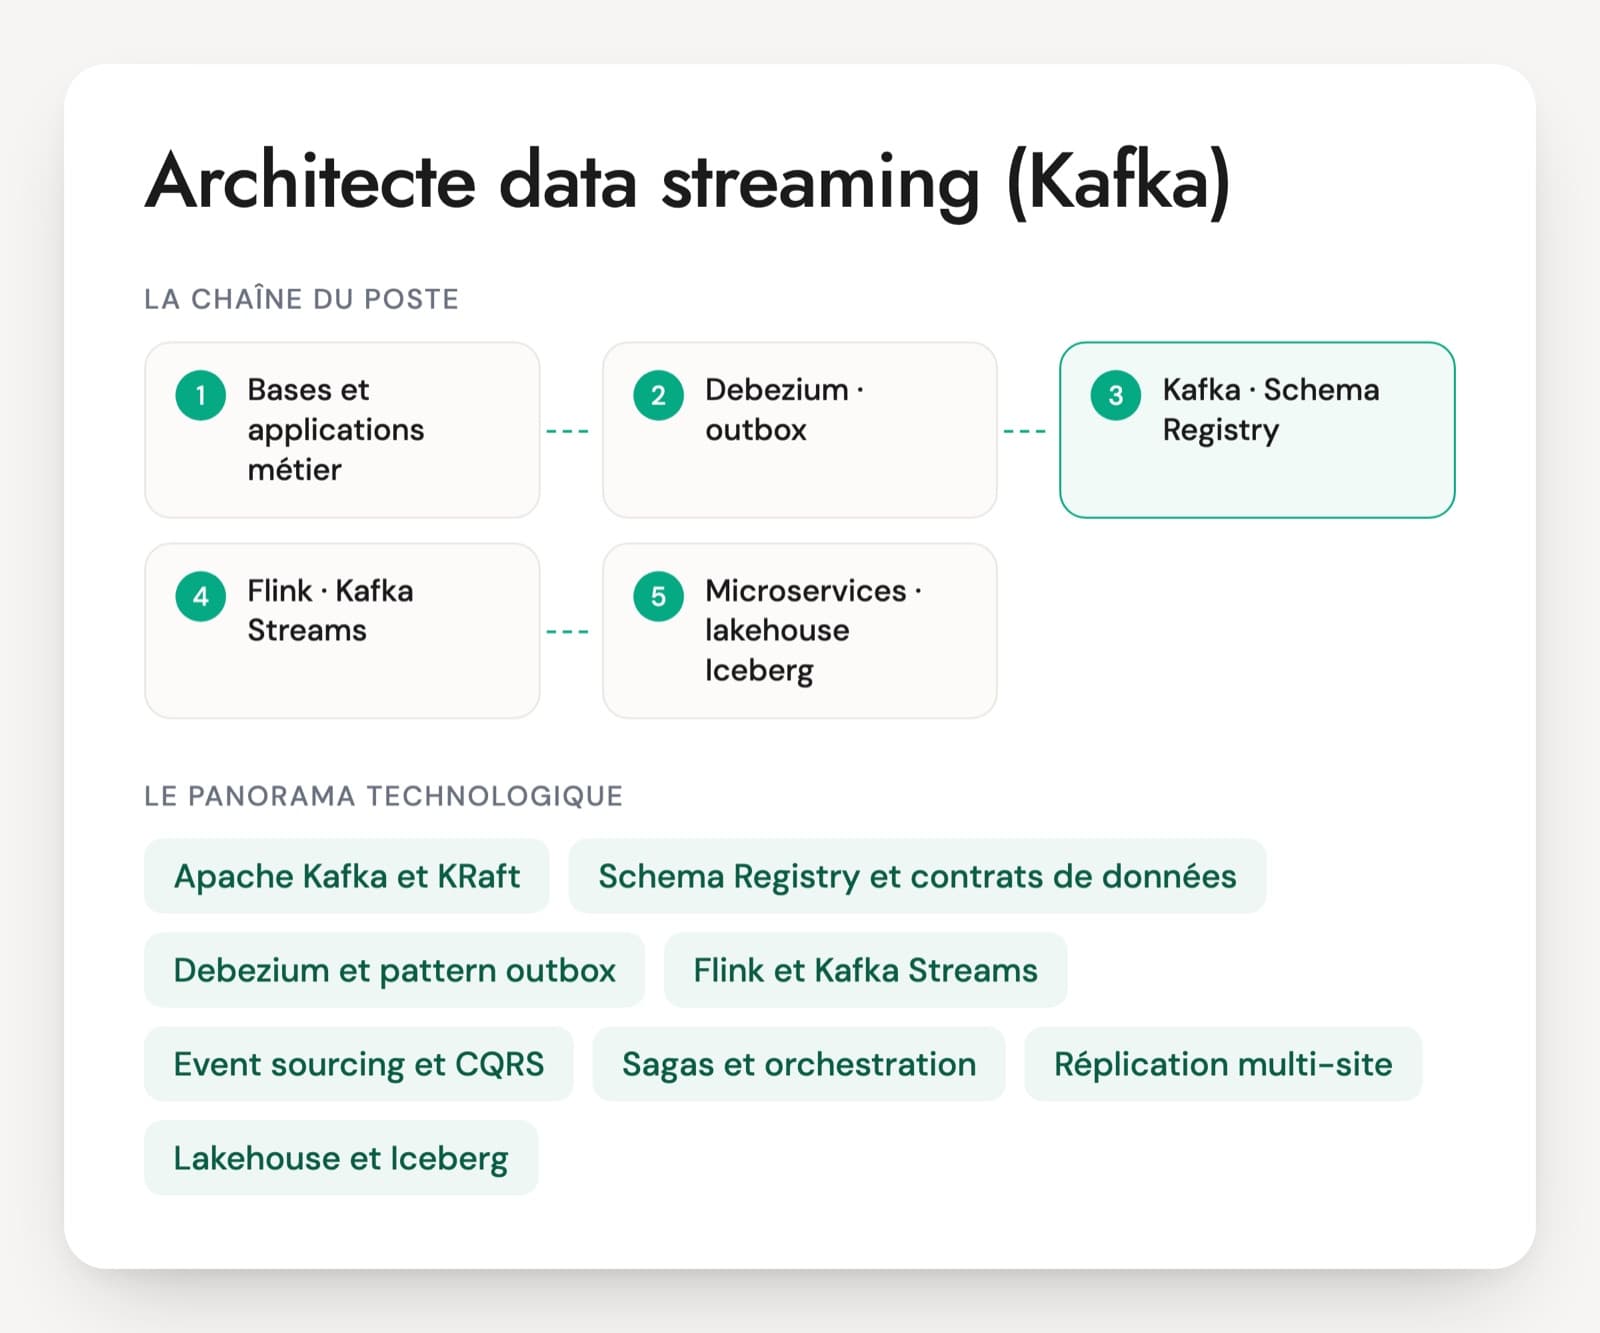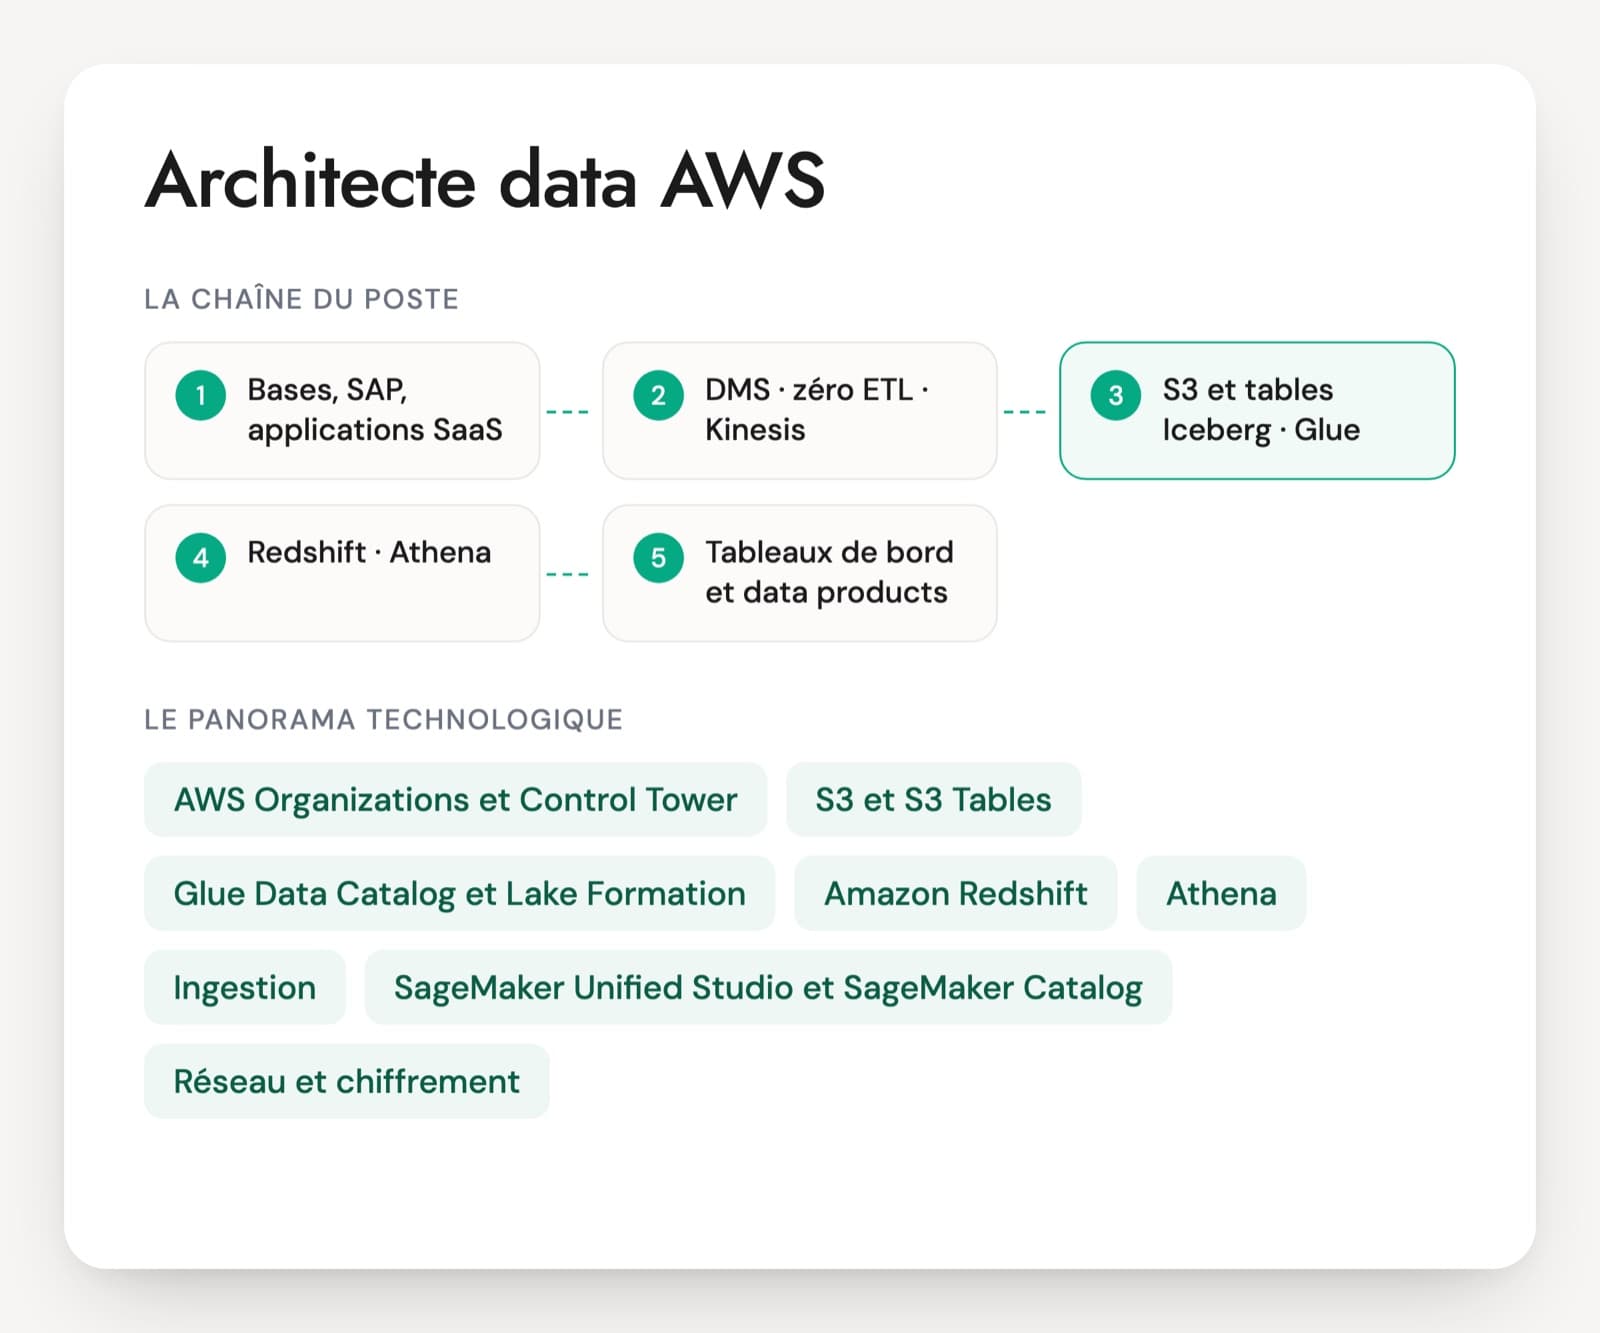
Un architecte data AWS conçoit le cadre dans lequel les data engineers travaillent. Il répartit la plateforme entre comptes avec Organizations et Control Tower, choisit entre un lac sur S3, Redshift ou les deux, organise le partage des données entre comptes avec Lake Formation, pose le réseau privé et le chiffrement, et suit la facture. En ESN, il intervient en cadrage, en avant-vente ou sur la reprise d'une plateforme existante. Chez un client final, il répond de la plateforme devant la DSI, le RSSI et la finance.
Le titre recouvre des parcours très différents. Certains candidats sont d'anciens data engineers AWS qui ont surtout écrit des jobs Glue. D'autres sont des architectes cloud qui maîtrisent les comptes et le réseau sans connaître la modélisation ni le coût d'Athena ou de Redshift. Les offres parlent souvent de data mesh et d'architecture médaillon. L'entretien doit vérifier que la personne a déjà choisi entre plusieurs options et sait expliquer pourquoi.
Un bon point de départ : une plateforme que le candidat a découpée en comptes, combien, selon quelle logique, et ce qu'il changerait aujourd'hui. Le cas pratique du PDF porte sur la plateforme par domaines d'un fournisseur d'énergie.
Les services AWS vus par l'architecte data
AWS Organizations et Control Tower
Organizations regroupe les comptes en unités organisationnelles. Control Tower pose une landing zone avec des comptes de journalisation et d'audit et des contrôles prêts à l'emploi. Les SCP limitent ce que les identités des comptes peuvent faire, les RCP limitent l'accès aux ressources, y compris depuis l'extérieur de l'organisation. Le découpage des comptes data se décide à ce niveau.
S3 et S3 Tables
S3 reste le stockage du data lake. S3 Tables ajoute des buckets dédiés aux tables Apache Iceberg, avec compaction et nettoyage automatiques et une intégration au Glue Data Catalog. L'architecte choisit le format des tables, le rangement des buckets par compte et par zone, et les règles de cycle de vie.
Glue Data Catalog et Lake Formation
Le Glue Data Catalog décrit les tables du lac. Lake Formation y ajoute des droits fins par base, table, colonne et ligne, et le partage entre comptes par étiquettes (LF-tags) ou par ressource nommée, via AWS RAM. C'est le service central d'une plateforme multi-comptes, et souvent le plus mal compris.
Amazon Redshift
L'entrepôt de données d'AWS, en clusters provisionnés RA3 ou en Serverless. Le partage de données (data sharing) donne à d'autres entrepôts, comptes ou régions un accès direct sans copie, en lecture comme en écriture. Il sert à isoler les charges : un entrepôt pour les traitements, d'autres pour la BI.
Athena, Glue et EMR
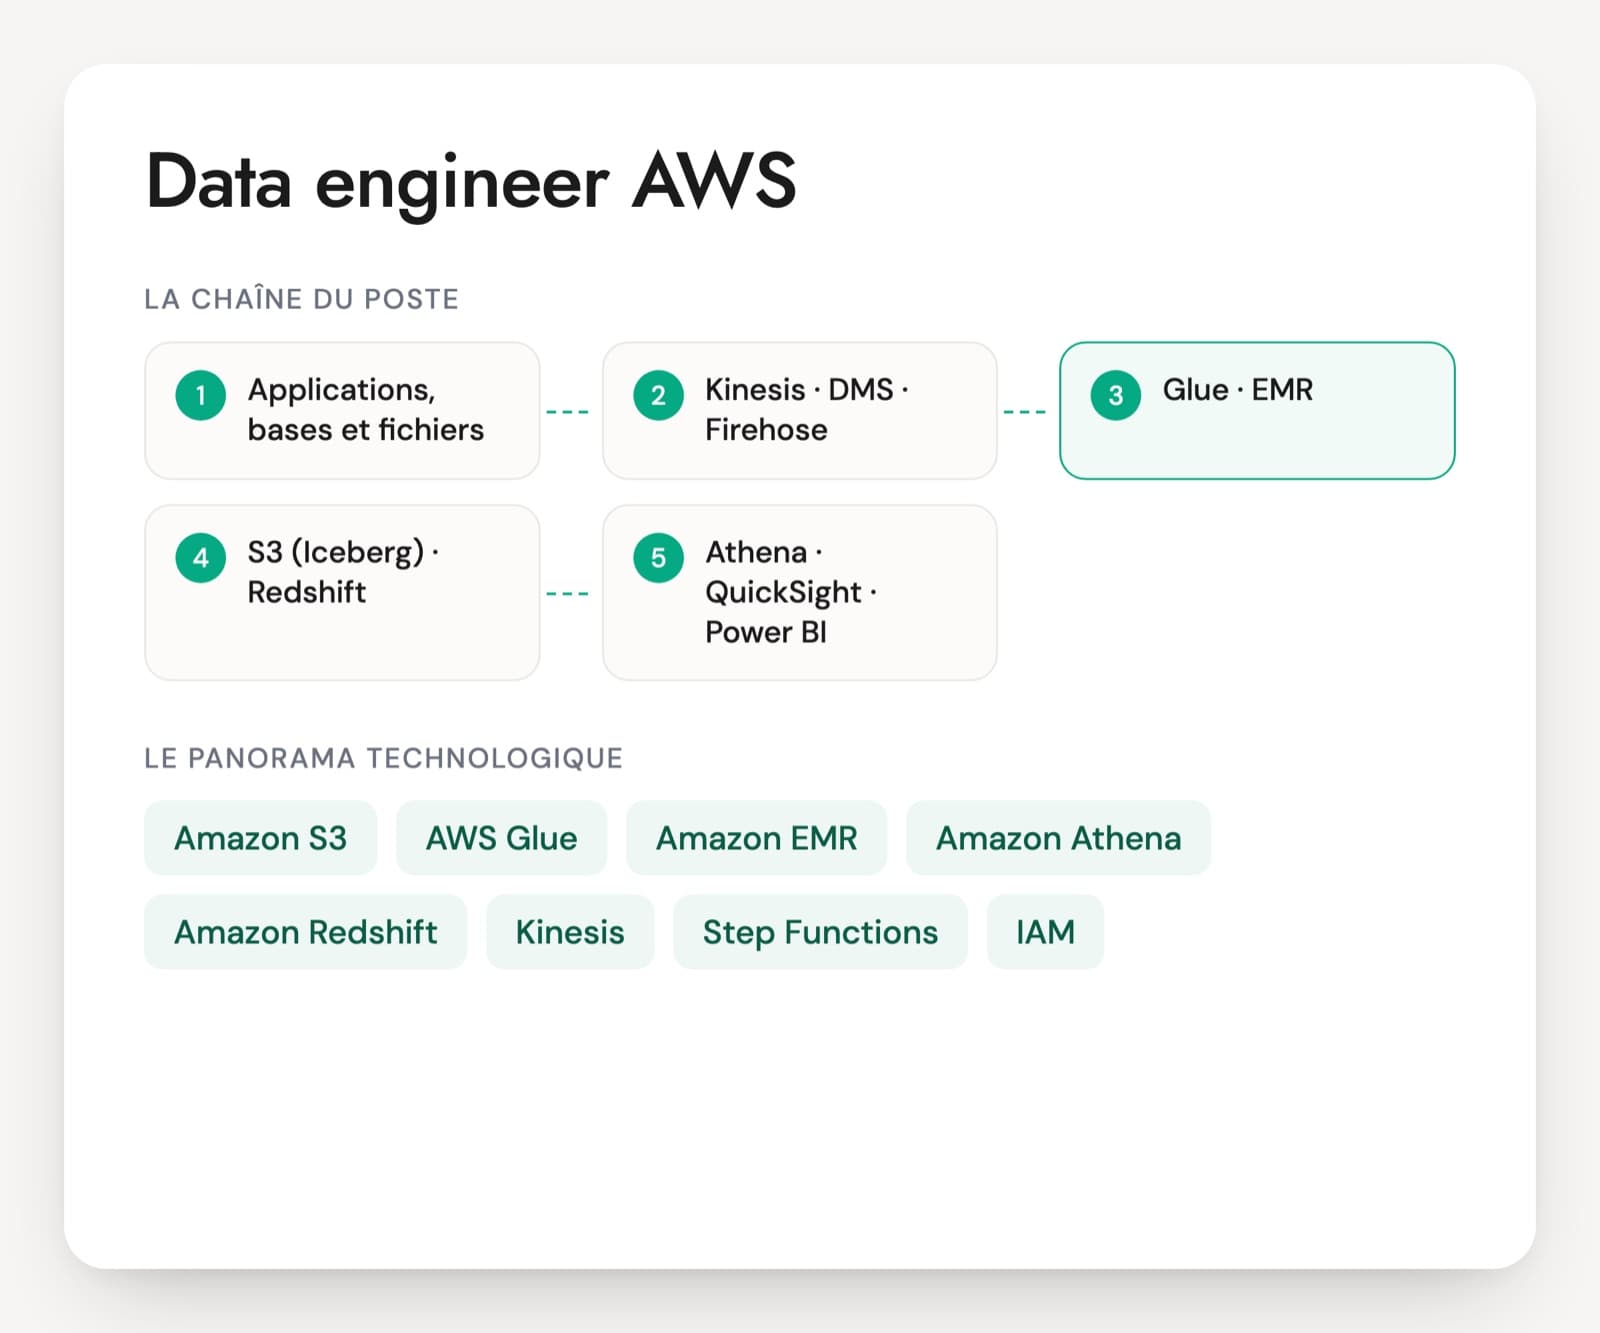
Athena interroge S3 en SQL et se paie au volume lu. Glue et EMR (sur EC2, EKS ou Serverless) font tourner Spark. L'architecte décide quel moteur sert à quoi et comment chaque équipe paie son usage.
Ingestion
DMS et les intégrations zéro ETL pour répliquer les bases (Aurora ou RDS vers Redshift), Kinesis ou MSK pour le temps réel, AppFlow ou Glue pour les applications SaaS. Le choix dépend de la latence demandée et du coût d'exploitation.
SageMaker Unified Studio et SageMaker Catalog
La nouvelle génération de SageMaker regroupe les outils d'analytics et de ML dans un même environnement. SageMaker Catalog, bâti sur Amazon DataZone, sert à publier des data products, tenir un glossaire et gérer les abonnements. On le rencontre surtout dans les projets data mesh.
Réseau et chiffrement
Points de terminaison VPC (gateway pour S3, interface pour Glue, Athena, STS ou KMS), PrivateLink, KMS avec des clés gérées par le client et leurs politiques, S3 Block Public Access. Un mauvais choix réseau se voit aussi sur la facture, par exemple quand les données transitent par une passerelle NAT.
Suivi des coûts
Cost Explorer, export détaillé des coûts (Data Exports), étiquettes de répartition et budgets. Côté data, les postes à surveiller sont Redshift (nœuds réservés ou Serverless), le volume lu par Athena, les heures Glue et EMR et les transferts entre zones et régions.
Le poste se trouve surtout dans les grands comptes qui ont fait d'AWS leur cloud principal (énergie, industrie, distribution, banque) et dans les ESN qui portent leurs programmes data. Les missions vont du cadrage d'une plateforme organisée par domaines à la reprise d'un lac construit sans gouvernance, en passant par la sortie d'un entrepôt Oracle, Teradata ou Hadoop. L'architecte data travaille avec l'équipe cloud qui tient la landing zone, avec le RSSI sur le périmètre de données et avec la finance sur la répartition des coûts. Les certifications Solutions Architect Professional et Data Engineer Associate attestent la connaissance d'AWS. La pratique d'une plateforme multi-comptes se vérifie en entretien.
Ce qu'un architecte data AWS doit maîtriser
- Organisation multi-comptes et landing zone
- Partage de données avec Lake Formation
- Choix de stockage : S3, Iceberg, Redshift
- Réseau privé, IAM et chiffrement KMS
- Modèle de coût et FinOps data
- Migration et résilience de la plateforme
Cinq questions d'architecture pour un poste data sur AWS
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · senior
Une plateforme data doit servir six domaines métier sur AWS. Comment répartissez-vous les comptes ?
Une bonne réponseUn compte par domaine et par environnement pour les producteurs, un compte de gouvernance central qui porte le catalogue de référence et les droits Lake Formation, des comptes de journalisation et de sécurité posés par Control Tower. Il justifie par l'isolement des droits et des quotas, la répartition des coûts et le rayon d'impact d'une erreur. Il cite aussi le prix de ce modèle : des partages entre comptes à administrer et un réseau à interconnecter.
Signal d'alerteUn seul compte pour toute la plateforme avec des préfixes S3 par équipe, ou un compte par personne. Aucun mot sur la gouvernance centrale.
Question 2 · senior
Le domaine Ventes doit partager trois tables avec le domaine Finance, dans un autre compte, sans copie et sans les colonnes personnelles. Comment le faites-vous avec Lake Formation ?
Une bonne réponseLes tables sont enregistrées dans le catalogue du compte producteur ou du compte central, sous contrôle Lake Formation et plus seulement IAM. Le partage passe par les LF-tags, méthode recommandée, ou par ressource nommée avec un filtre de colonnes, et s'appuie sur AWS RAM. Côté Finance, l'administrateur du lac accepte l'invitation si les comptes ne sont pas dans la même organisation, crée des liens de ressource pour Athena ou Redshift Spectrum et redonne les droits à ses propres rôles. Il connaît le mode d'accès hybride pour migrer sans casser les accès IAM existants.
Signal d'alerteUne politique de bucket qui ouvre le préfixe S3 au compte Finance, ou une copie nocturne des tables sans les colonnes personnelles.
Question 3 · senior
Data lake sur S3 avec Athena, Redshift, ou les deux : comment tranchez-vous pour une nouvelle plateforme ?
Une bonne réponseIl part des usages : volumes, nombre de requêtes BI simultanées, latence attendue, compétences de l'équipe, moteurs qui doivent lire les mêmes données. Souvent un lac en tables Iceberg sur S3 comme socle ouvert, lisible par Spark, Athena et Redshift, et Redshift pour la BI très sollicitée. Il chiffre les deux modèles, volume lu par Athena contre capacité Redshift, et dit ce qui est stocké une fois et ce qui est copié.
Signal d'alerte« Redshift pour tout » ou « Athena pour tout » par habitude, sans chiffrage ni mot sur la concurrence des requêtes ou le format ouvert.
Question 4 · confirmé
Les jobs Glue tournent dans un VPC privé et la facture réseau explose. Que cherchez-vous ?
Une bonne réponseLe trafic vers S3 qui passe par une passerelle NAT, facturée au volume, au lieu d'un point de terminaison VPC de type gateway pour S3, sans frais de traitement. Puis les transferts entre zones de disponibilité et entre régions, et les appels aux API (STS, Glue, KMS) qui peuvent passer par des points de terminaison de type interface. Il lit Cost Explorer par type d'usage et les journaux de flux VPC.
Signal d'alerteAgrandir la passerelle NAT, ou ignorer qu'il existe des points de terminaison VPC pour S3.
Question 5 · senior
Redshift coûte plus que prévu et la charge varie fortement entre le jour et la nuit. Quelles options d'architecture proposez-vous ?
Une bonne réponseIl mesure d'abord, avec les tables système et l'usage par heure. Puis il propose : traitements et BI séparés sur plusieurs entrepôts reliés par le partage de données, Serverless avec une capacité de base et un plafond pour la charge irrégulière, nœuds réservés pour la part stable d'un cluster RA3, pause des environnements hors production, données froides déportées vers S3 et interrogées au besoin. Il compare les options sur des chiffres de consommation.
Signal d'alerteAjouter des nœuds, ou passer en Serverless par principe sans fixer de plafond.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Embaucher un architecte data AWS : questions fréquentes
Qu'attendre d'un architecte data AWS par rapport à un architecte cloud AWS ?
L'architecte cloud conçoit la landing zone, le réseau et la sécurité pour toutes les applications. L'architecte data s'appuie sur ce socle et décide de l'organisation des données : comptes de domaine, catalogue, droits Lake Formation, choix entre lac et Redshift, modèle de coût des moteurs d'analyse. Un bon profil data parle aussi de réseau et de KMS, car le partage entre comptes en dépend directement.
Quelles certifications AWS regarder sur le CV ?
La Solutions Architect Professional atteste la conception d'architectures complexes sur AWS, la Data Engineer Associate la connaissance des services data. La Data Analytics Specialty a été retirée en 2024 : un CV qui la cite renvoie à une expérience plus ancienne. Aucune ne prouve une plateforme multi-comptes tenue en production. Faites raconter un partage Lake Formation entre comptes ou une facture réduite, avec les chiffres.
Un exercice écrit est-il utile pour recruter un architecte data AWS ?
Un test technique à faire chez soi apporte peu pour ce poste. Une étude de cas orale de 20 à 30 minutes montre mieux le raisonnement. Vous décrivez une entreprise avec plusieurs domaines, des contraintes de sécurité et un budget, la personne dessine les comptes, les stockages et les partages, puis vous changez une contrainte. Notez la qualité des compromis et les ordres de grandeur plus que les noms de services.
Faut-il qu'un architecte data AWS sache coder ?
Il doit lire du code et en écrire un peu : SQL avancé, Python pour Glue ou Lambda, Terraform ou CDK pour l'infrastructure. Il ne passe pas ses journées à développer, mais un architecte qui ne sait pas lire un job Spark ou une politique IAM valide des choix sans voir leurs conséquences. En entretien, faites-lui commenter une politique de bucket ou le plan d'une requête Redshift.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.