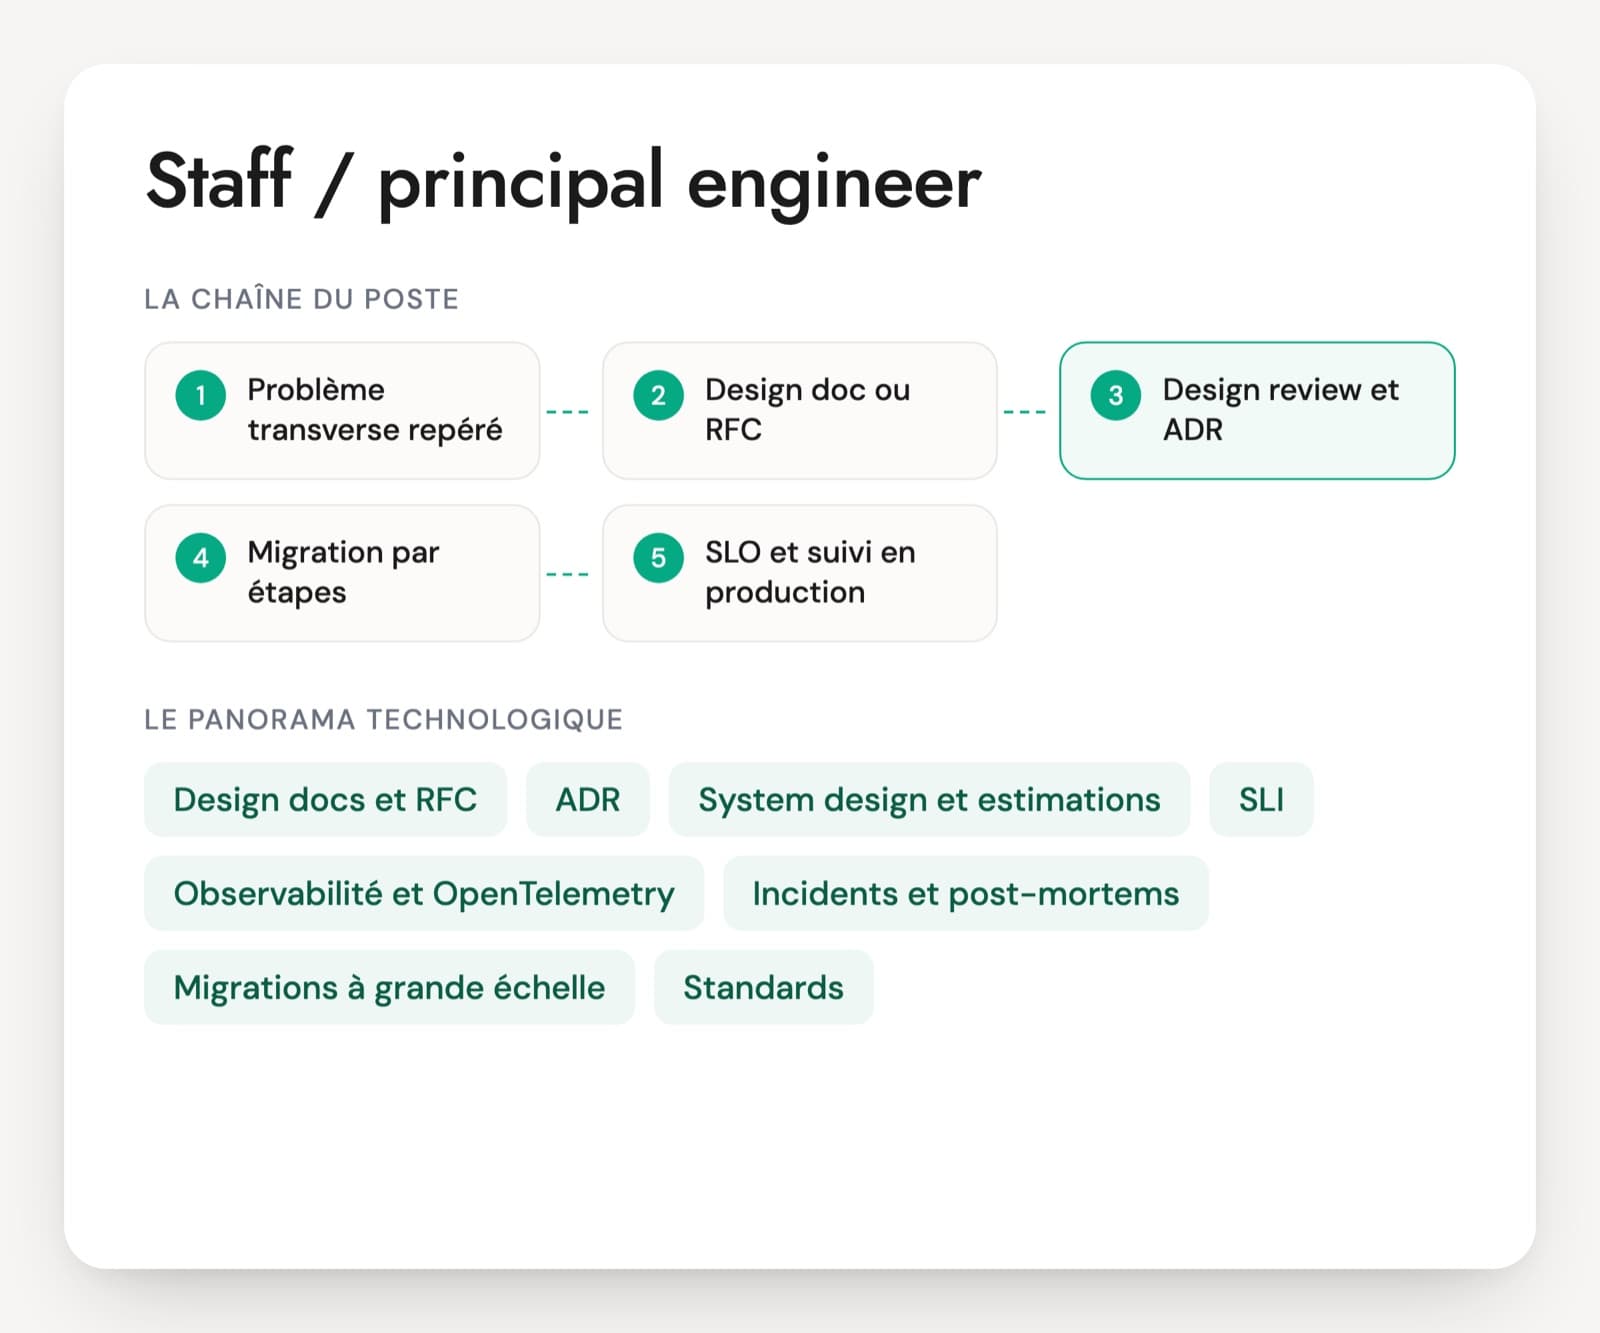
Le titre est encore récent en France et recouvre des postes différents. Dans la typologie de Will Larson, certains staff engineers jouent le rôle de tech lead d'une équipe, d'autres celui d'architecte d'un domaine (le stockage, les API, la plateforme), d'autres règlent des problèmes difficiles d'un bout à l'autre. Les offres françaises parlent d'architecture cible, d'ADR, de dette technique, d'observabilité et d'incidents critiques. Écrivez dans l'offre lequel de ces profils correspond au poste, avant la première question.
L'écart avec un senior se voit dans le périmètre des réponses. Un développeur senior conçoit un service propre. Un staff engineer explique ce que son choix coûte aux autres équipes, comment le système se comporte quand une dépendance ralentit, et comment on passe de l'existant à la cible sans coupure. Il chiffre des ordres de grandeur sans calculatrice et sait dire ce qu'il ne fera pas.
Demandez un design doc ou un RFC que la personne a écrit, anonymisé. Sa structure en dit long : alternatives écartées, non-objectifs, plan de retour arrière, impact sur les SLO. Une revue de ce document en entretien vaut mieux qu'un exercice d'algorithmique.
Les pratiques d'ingénierie qu'un staff engineer tient
Design docs et RFC
Le document qui décrit un problème, la solution proposée et les alternatives avant d'écrire du code. Il circule auprès des équipes concernées, reçoit des commentaires puis passe en design review. Un staff engineer en écrit et en relit beaucoup, c'est son principal outil de travail.
ADR (architecture decision records)
Une note courte par décision d'architecture : contexte, décision, conséquences. Elle se range avec le code et ne se réécrit pas, une nouvelle décision remplace l'ancienne. Les offres de staff engineer et d'architecte les citent de plus en plus souvent.
System design et estimations
Découper un système en composants, choisir entre synchrone et asynchrone, entre cohérence forte et cohérence à terme, placer caches et files de messages. Le travail commence par des estimations de débit, de volume et de latence, faites en quelques minutes pour savoir où le système cassera.
SLI, SLO et budget d'erreur
Le SLI mesure le service rendu, souvent un ratio de requêtes réussies. Le SLO fixe la cible, par exemple 99,9 % sur 28 jours. Le budget d'erreur, égal à 100 % moins le SLO, décide quand on ralentit les livraisons pour traiter la fiabilité, selon une politique écrite à l'avance.
Observabilité et OpenTelemetry
Métriques, traces distribuées et logs structurés, reliés par un identifiant de requête. OpenTelemetry est devenu le standard ouvert pour les produire. Un staff engineer définit ce que chaque service doit exposer pour qu'une astreinte trouve la cause d'un incident rapidement.
Incidents et post-mortems
Gestion de crise pendant la panne, puis analyse écrite sans recherche de coupable : chronologie, causes, détection, actions avec un responsable et une date. Le staff engineer cherche les causes communes entre plusieurs incidents, là où une équipe seule ne les voit pas.
Migrations à grande échelle
Remplacer une base partagée, découper un monolithe, changer de version de framework sur cinquante dépôts. Les techniques reviennent : remplacement progressif autour de l'existant, double écriture, lectures comparées, feature flags, expand puis contract sur les schémas, date de retrait annoncée.
Standards, API et plateforme commune
Charte d'API (versionnage, erreurs, pagination), contrats d'événements avec registre de schémas, modèle de service prêt à l'emploi avec CI, logs et traces déjà configurés. Le but est que le bon choix soit aussi le plus simple pour les équipes, et que des contrôles automatiques le vérifient.
Le poste existe dans les organisations qui comptent plusieurs équipes de développement, en général à partir de quelques dizaines d'ingénieurs. Il reste un poste d'expertise : le staff engineer ne fait pas les entretiens annuels et n'a pas de budget, son influence passe par ses documents, ses revues et le code qu'il écrit encore. Le principal engineer est le niveau au-dessus, avec un périmètre plus large, parfois toute l'ingénierie. Les intitulés varient d'une entreprise à l'autre, développeur expert ou ingénieur logiciel principal reviennent aussi. Vérifiez sur le terrain technique que le périmètre annoncé dans le CV correspond à ce que la personne a réellement décidé.
Six compétences techniques d'un staff / principal engineer
- System design et arbitrages d'architecture
- Écriture technique : design docs, RFC, ADR
- Fiabilité, SLO et incidents
- Performance, capacité et coûts
- Migrations multi-équipes et dette technique
- Standards d'API et outillage commun
Architecture, SLO, migration : cinq questions de niveau staff
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · expert
Un monolithe tient 2 000 requêtes par seconde, le produit en prévoit dix fois plus dans dix-huit mois. Quelle démarche proposez-vous avant de parler de microservices ?
Une bonne réponseD'abord savoir où le système cassera : profil de charge, test de charge, requêtes les plus coûteuses, contention sur la base. Ensuite des réponses graduées : cache, réplicas en lecture, traitements déplacés en asynchrone, partitionnement de la base. Il n'extrait un domaine que si une limite précise le justifie, de charge ou de cadence de livraison, et il chiffre le coût d'exploitation des services séparés : réseau, observabilité, cohérence des données.
Signal d'alerte« On passe en microservices » sans mesure. Une réécriture complète proposée comme premier pas.
Question 2 · senior à expert
Que doit contenir un design doc pour qu'une design review d'une heure aboutisse à une décision ?
Une bonne réponseLe problème et le contexte, les objectifs et les non-objectifs, les contraintes chiffrées, la solution proposée, les alternatives écartées avec la raison, les risques, le plan de migration et de retour arrière, l'impact sur les SLO, les coûts et la sécurité, les questions ouvertes. Le document part plusieurs jours avant, les relecteurs sont nommés, les commentaires se font par écrit et la décision finit dans un ADR.
Signal d'alerteUn diaporama sans alternatives. Une réunion où les participants découvrent le document en séance.
Question 3 · senior à expert
Comment fixez-vous le SLO d'une API de paiement, et que se passe-t-il quand le budget d'erreur est épuisé ?
Une bonne réponseUn SLI mesuré au plus près de l'utilisateur, en ratio de requêtes réussies et sous un seuil de latence. Un SLO fixé à partir de l'historique et du besoin réel, par exemple 99,9 % sur 28 jours, soit une quarantaine de minutes de budget. Une politique écrite à l'avance pour le budget épuisé : gel des changements risqués et priorité à la fiabilité jusqu'au retour dans l'objectif. Les alertes portent sur la vitesse de consommation du budget.
Signal d'alerteUn objectif de 100 %. Un SLO sur l'usage CPU des machines.
Question 4 · senior
La latence p99 d'un service a doublé depuis la dernière mise en production, la moyenne n'a pas bougé. Comment cherchez-vous ?
Une bonne réponseLa moyenne cache la queue de distribution. Il compare avant et après le déploiement, isole les requêtes lentes par endpoint, client ou taille de requête grâce aux traces, puis regarde les causes typiques de queue : pauses du ramasse-miettes, pool de connexions saturé, verrous en base, cache froid, requêtes en cascade sur certains cas. Un profilage en production et un retour arrière ciblé confirment l'hypothèse.
Signal d'alerteRegarder la moyenne et ajouter des machines.
Question 5 · expert
Vous devez remplacer une base de données partagée par quinze services, sans arrêt de service. Quel plan proposez-vous ?
Une bonne réponseL'inventaire des accès, qui lit et écrit quoi. Puis l'encapsulation derrière une API ou une propriété claire par service, la copie vers la nouvelle base par double écriture ou capture des changements, des lectures comparées pour vérifier les données, une bascule service par service sous feature flag avec critères de retour arrière, une réconciliation chiffrée et une date de retrait de l'ancien chemin. Un tableau de bord suit l'avancement de chaque équipe.
Signal d'alerteUne bascule de tous les services pendant un week-end. Aucun plan de retour arrière.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Staff ou principal engineer : les points à clarifier
Staff engineer ou tech lead : où passe la frontière ?
Le tech lead porte les choix techniques d'une équipe et code avec elle au quotidien. Le staff engineer travaille à l'échelle de plusieurs équipes : un domaine d'architecture, une migration transverse, un standard commun. Certains staff engineers tiennent aussi le rôle de tech lead d'une équipe importante. En entretien, la différence se voit dans le périmètre des exemples : un service, ou un système dont dépendent d'autres équipes.
Faut-il faire passer un test technique à un staff engineer ?
Un exercice de code reste utile pour vérifier que la personne code encore, sans en faire le cœur de l'entretien. Le plus parlant est un exercice de system design de 45 minutes sur un problème ouvert, suivi de la revue d'un design doc qu'elle a écrit. Prévoyez deux évaluateurs de niveau équivalent ou supérieur, l'un pour l'architecture, l'autre pour la fiabilité et l'exploitation.
Comment vérifier le périmètre réel annoncé sur un CV ?
Demandez une décision technique précise, son contexte et ce qui s'est passé six mois après. Faites citer les équipes touchées, les alternatives écartées, les chiffres avant et après : latence, coût, nombre d'incidents. Une personne qui a porté le sujet connaît les détails du plan de migration et les compromis faits en route. Une personne qui l'a observé reste à un niveau général.
Principal engineer : est-ce le même entretien ?
La structure reste la même, le périmètre grandit. Un principal engineer intervient sur des sujets qui touchent toute l'ingénierie : choix de stockage, stratégie de migration vers le cloud, standards de sécurité. Les questions de system design portent alors sur plusieurs systèmes à la fois et sur des horizons de plusieurs années. Attendez des exemples où ses décisions ont changé la façon de travailler de nombreuses équipes.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.