Un ingénieur stockage SAN / NAS peut passer dans la même semaine d'une baie Dell PowerStore à une IBM FlashSystem, puis à un NAS PowerScale ou NetApp. Il crée des volumes, les masque pour les bons hôtes, règle le zoning sur la fabric Fibre Channel, suit la latence et la capacité, et prépare les bascules du PRA. Les offres parlent d'ingénieur stockage et sauvegarde, d'expert stockage N3 ou d'architecte stockage, avec souvent Veeam, Commvault ou NetBackup dans le même poste.
Les CV alignent beaucoup de constructeurs. Le constructeur compte moins que la compréhension du trajet d'une écriture : du serveur au HBA, à travers deux fabrics, jusqu'au cache de la baie et à sa copie distante. Un profil qui l'a compris change de console en quelques semaines. Un profil qui a surtout suivi des procédures bloque dès qu'un chemin tombe ou qu'une réplication prend du retard.
Une migration de baie menée de bout en bout est le meilleur récit : nombre d'hôtes, méthode, coupure obtenue. Sur les postes qui incluent du stockage logiciel, Ceph s'ajoute au SAN sans le remplacer. Le PDF contient un cas de 20 minutes sur un PRA entre deux salles.
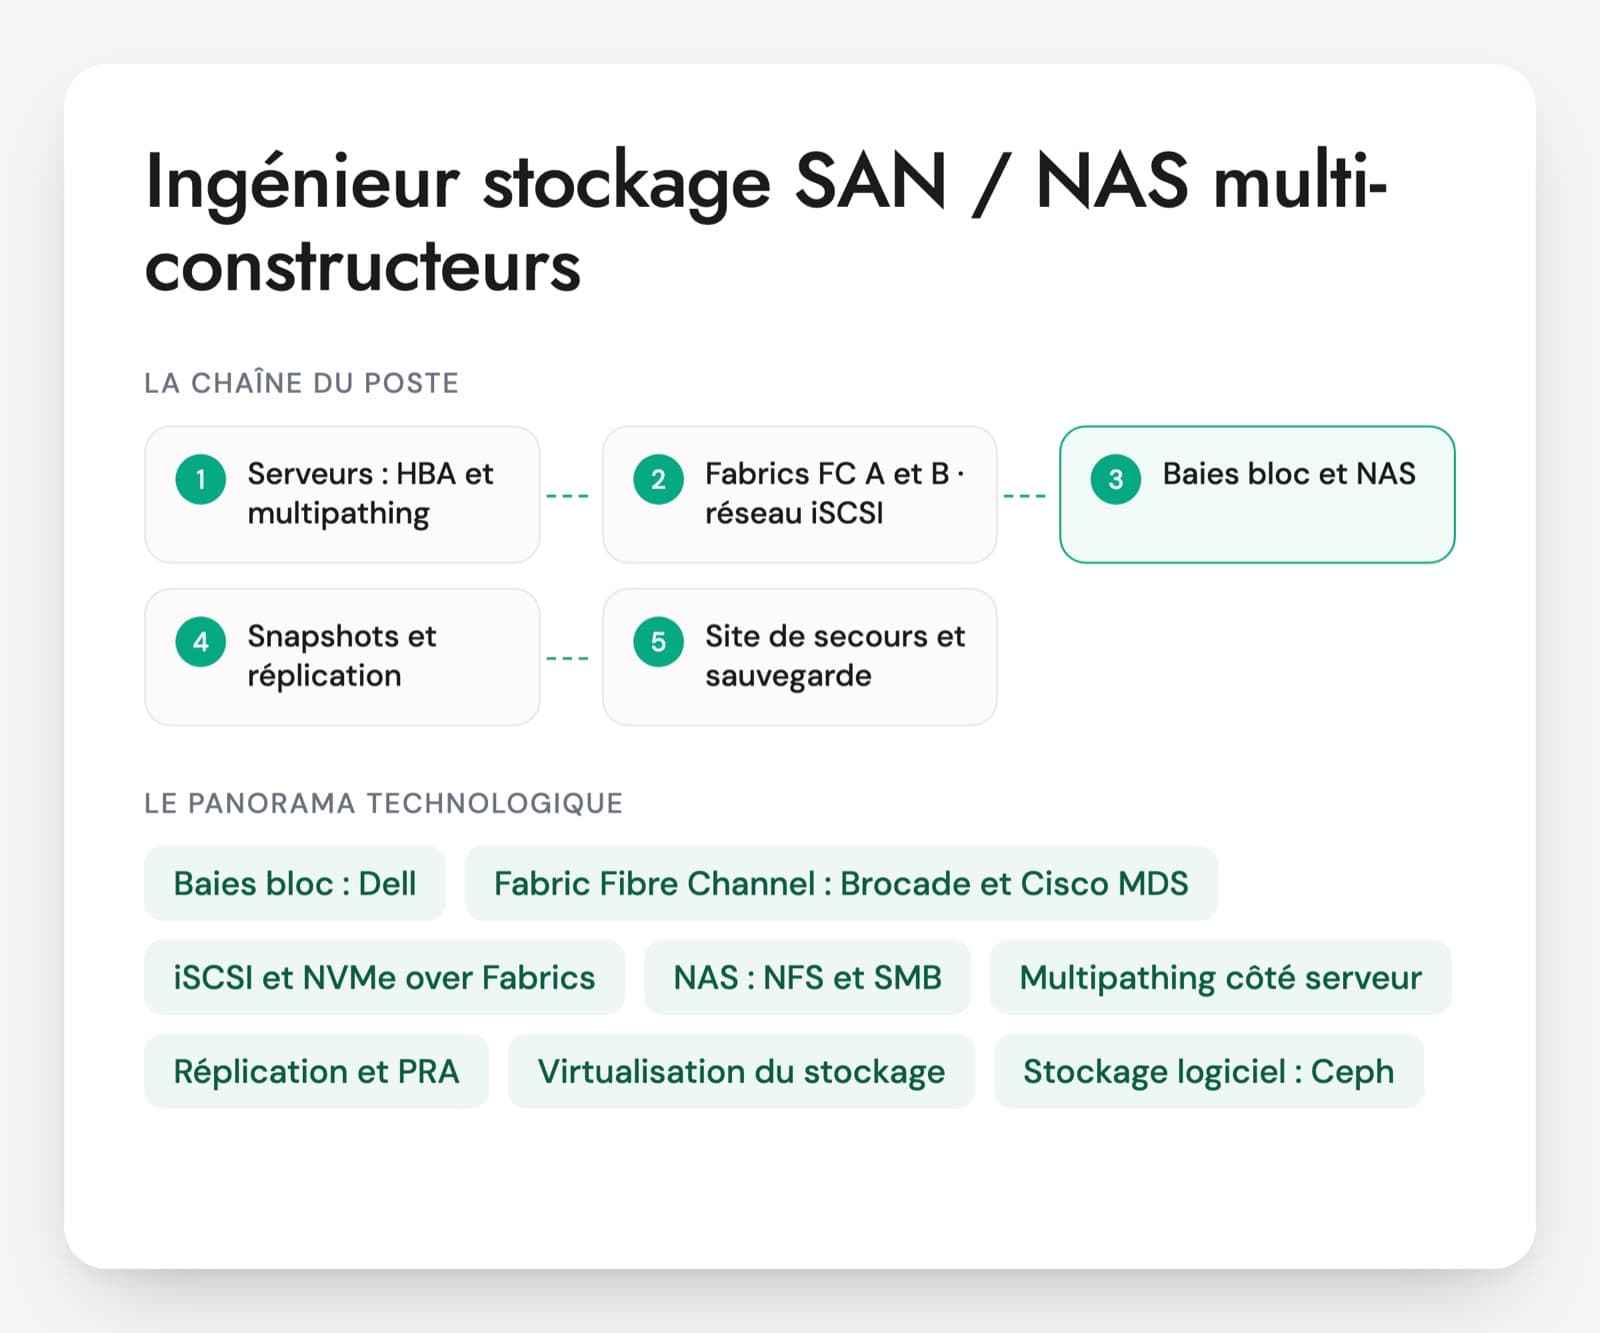
Baies, fabrics et protocoles d'un ingénieur stockage SAN / NAS
Baies bloc : Dell, IBM, HPE, Everpure, Hitachi
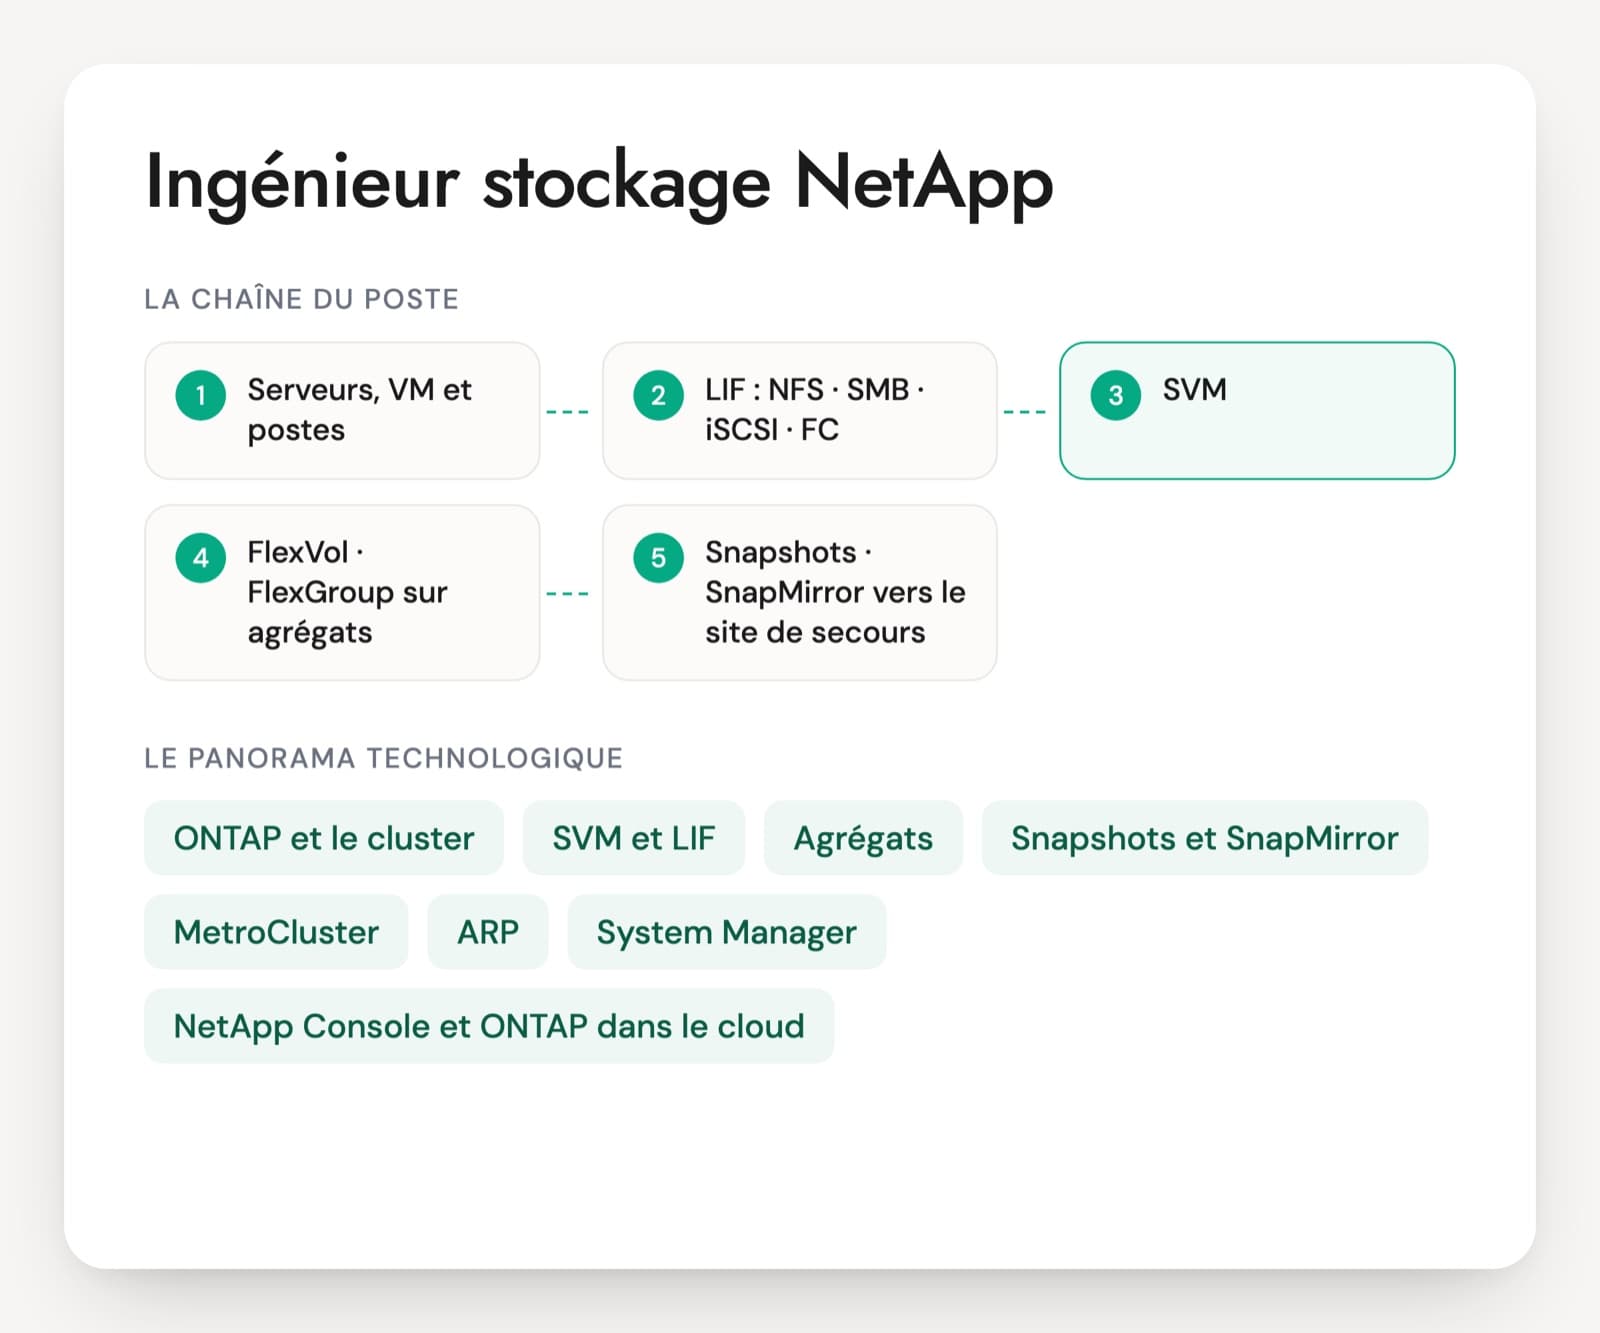
PowerStore et PowerMax chez Dell, FlashSystem chez IBM, Alletra chez HPE, FlashArray chez Everpure (le nom de Pure Storage depuis février 2026), VSP chez Hitachi. Chaque constructeur a ses termes (pool, volume, groupe d'hôtes), mais les notions se ressemblent : protection RAID ou distribuée, provisionnement fin, déduplication, snapshots. La personne doit dire sur quelles gammes elle a travaillé, et en exploitation ou seulement en installation.
Fabric Fibre Channel : Brocade et Cisco MDS
Deux réseaux SAN séparés, les fabrics A et B, relient serveurs et baies. Le zoning décide quel port de serveur voit quel port de baie, par WWPN. Fabric OS chez Brocade et NX-OS chez Cisco n'ont pas la même syntaxe, mais un ingénieur qui comprend alias, zones et configuration active passe de l'un à l'autre.
iSCSI et NVMe over Fabrics
iSCSI transporte le bloc sur Ethernet, avec un réseau dédié et du multipathing. NVMe sur Fibre Channel ou sur TCP apparaît sur les baies récentes et réduit la latence. Le candidat doit savoir ce qu'il faut vérifier côté hôte et côté réseau avant de l'activer.
NAS : NFS et SMB
Les partages de fichiers servis par PowerScale, NetApp ou les fonctions fichier des baies unifiées. NFS côté Linux et VMware, SMB côté Windows avec les droits NTFS et Active Directory. Les droits, les quotas et les verrous prennent souvent plus de temps que le volume lui-même.
Multipathing côté serveur
MPIO sous Windows, DM-Multipath sous Linux, le multipathing natif d'ESXi ou un logiciel constructeur comme PowerPath. Un hôte mal réglé perd ses disques quand une fabric redémarre. Le candidat doit expliquer ce que voit le système quand un chemin tombe.
Réplication et PRA
Copie synchrone entre deux salles proches, asynchrone vers un site éloigné, ou baies en actif-actif dans certaines gammes (SRDF/Metro chez Dell, ActiveCluster chez Everpure, HyperSwap chez IBM). Le choix dépend de la distance, de la perte de données acceptée et de la bande passante disponible.
Virtualisation du stockage
IBM Storage Virtualize, le logiciel des FlashSystem et de SAN Volume Controller, ou des fonctions équivalentes placent une couche entre les hôtes et plusieurs baies. Elle sert surtout aux migrations sans coupure et à regrouper des baies de constructeurs différents.
Stockage logiciel : Ceph
Sur certains postes, Ceph complète les baies : blocs RBD pour OpenStack ou Proxmox, objet compatible S3, système de fichiers CephFS. Le métier change (serveurs standards, réseau, placement des données par CRUSH) et ne remplace pas la connaissance du SAN.
Automatisation et API
Les baies récentes exposent des API REST, des modules Ansible et des commandes PowerShell. Un ingénieur confirmé scripte la création des volumes, le zoning type et les rapports de capacité au lieu de tout faire à la main dans les consoles.
Le poste se trouve dans les organisations qui gardent leurs propres datacenters, chez les hébergeurs et dans les équipes d'infogérance qui tiennent les baies de plusieurs clients. Le parc mélange souvent plusieurs générations et plusieurs constructeurs, achetés au fil des appels d'offres. Le stockage est fréquemment associé à la sauvegarde dans la même fiche de poste, et parfois à la virtualisation VMware ou Hyper-V. Les certifications des constructeurs (Dell, NetApp, Everpure, IBM, Brocade) attestent une gamme précise, pas la maîtrise d'un parc mixte. Les interventions de nuit pour les micrologiciels et les astreintes font partie du métier.
Le socle stockage attendu quel que soit le constructeur
- Protocoles bloc et fichier : FC, iSCSI, NFS, SMB
- Zoning, masquage de LUN et multipathing
- Performance et capacité des baies
- Snapshots, réplication et PRA
- Migration de baies et virtualisation du stockage
- Exploitation multi-constructeurs et automatisation
Cinq questions de production pour un ingénieur stockage
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Un nouvel hôte ESXi doit voir un volume de 4 To sur la baie. Décrivez les étapes, du câblage au datastore.
Une bonne réponseRelever les WWPN des deux HBA, créer les alias et une zone par initiateur sur chaque fabric (un port de serveur avec les ports cibles de la baie), ajouter les zones à la configuration et l'activer. Sur la baie, déclarer l'hôte avec ses WWPN et le bon type de système, créer le volume et le présenter à l'hôte ou au groupe d'hôtes du cluster avec le même numéro de LUN. Côté ESXi, réanalyser les adaptateurs, vérifier le nombre de chemins et la stratégie recommandée par le constructeur (souvent Round Robin), puis créer le datastore.
Signal d'alerteUne seule zone qui contient tous les serveurs et toutes les baies, ou une seule fabric configurée. Mettre en production sans avoir compté les chemins.
Question 2 · senior
Les applications se plaignent de lenteurs et la baie affiche 15 ms de latence en lecture. Comment trouvez-vous la cause ?
Une bonne réponseIl situe d'abord la latence : côté hôte (esxtop, iostat, compteurs Windows), sur la fabric ou dans la baie, en comparant la latence vue par l'hôte et celle mesurée par la baie. Un écart oriente vers la file d'attente du HBA, le multipathing ou la fabric (erreurs de port, crédits épuisés, un port lent qui freine les autres). Si la baie elle-même est lente : contrôleur ou volume saturé, taille d'IO inhabituelle liée à une sauvegarde ou à un traitement lourd, cache saturé, pool trop rempli. Il croise avec l'heure de début et le dernier changement.
Signal d'alerte« On ajoute des disques », ou regarder les IOPS sans regarder la taille des IO ni d'où vient la latence.
Question 3 · confirmé
Après la mise à jour du micrologiciel d'un commutateur de la fabric A, plusieurs serveurs Linux ont perdu leurs disques. Qu'est-ce qui n'allait pas ?
Une bonne réponseUn hôte qui ne survit pas à la perte d'une fabric n'avait pas de chemins sur les deux, ou son multipathing était mal réglé : DM-Multipath absent, systèmes de fichiers montés sur /dev/sdX au lieu du périphérique multipath, délais de bascule inadaptés. Avant l'intervention, il contrôle le nombre de chemins actifs de chaque hôte et prévient les équipes systèmes. Après, il vérifie que tous les chemins sont revenus avant de toucher à la fabric B.
Signal d'alerteAccuser le commutateur sans regarder les hôtes, ou enchaîner les deux fabrics le même soir sans contrôle entre les deux.
Question 4 · confirmé
Réplication synchrone ou asynchrone entre deux sites : comment choisissez-vous ?
Une bonne réponseEn synchrone, l'écriture n'est confirmée au serveur qu'une fois copiée sur l'autre site : aucune perte en cas de sinistre, mais la latence de la liaison s'ajoute à chaque écriture, ce qui limite la distance. En asynchrone, la copie part après coup : la latence applicative ne change pas, et l'on accepte une perte de quelques secondes à quelques minutes selon le cycle. Il part du RPO et du RTO demandés, de la distance, de la bande passante et du volume d'écritures. Il cite les groupes de cohérence pour une application répartie sur plusieurs volumes.
Signal d'alerte« Le synchrone, c'est mieux », sans parler de distance ni de latence. Ou des volumes d'une même base répliqués chacun de leur côté.
Question 5 · confirmé à senior
Un rançongiciel a chiffré des partages NAS et des VM. Qu'est-ce qui, côté stockage, permet de repartir ?
Une bonne réponseDes snapshots immuables, que personne ne peut supprimer avant leur échéance, même avec un compte administrateur, avec une fréquence et une rétention connues. Des comptes d'administration des baies protégés par MFA et indépendants du domaine compromis. Il sait restaurer depuis un snapshot antérieur à l'infection, vérifier sur un réseau isolé avant la remise en ligne, et rappelle que ces snapshots ne remplacent pas une sauvegarde hors de la baie. Il cite la fonction de sa gamme : SafeMode chez Everpure (ex-Pure Storage), Safeguarded Copy chez IBM, ou l'équivalent du constructeur.
Signal d'alerte« On a des snapshots », sans savoir si un administrateur compromis peut les effacer. Ou une restauration directe en production sans contrôle.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Profils SAN et NAS : les questions fréquentes
Un expert d'un seul constructeur peut-il tenir un parc multi-constructeurs ?
Souvent oui, s'il maîtrise le fond commun : zoning, masquage, multipathing, réplication, lecture d'une latence. La syntaxe d'une autre baie s'apprend en quelques semaines avec la documentation. Le risque vient des profils qui connaissent les menus d'une console sans comprendre ce qu'ils déclenchent. Il décrit une opération sur sa baie habituelle, puis ce qui changerait sur une autre gamme. Les bons profils parlent de notions, pas d'écrans.
Stockage et sauvegarde : un seul profil ou deux personnes ?
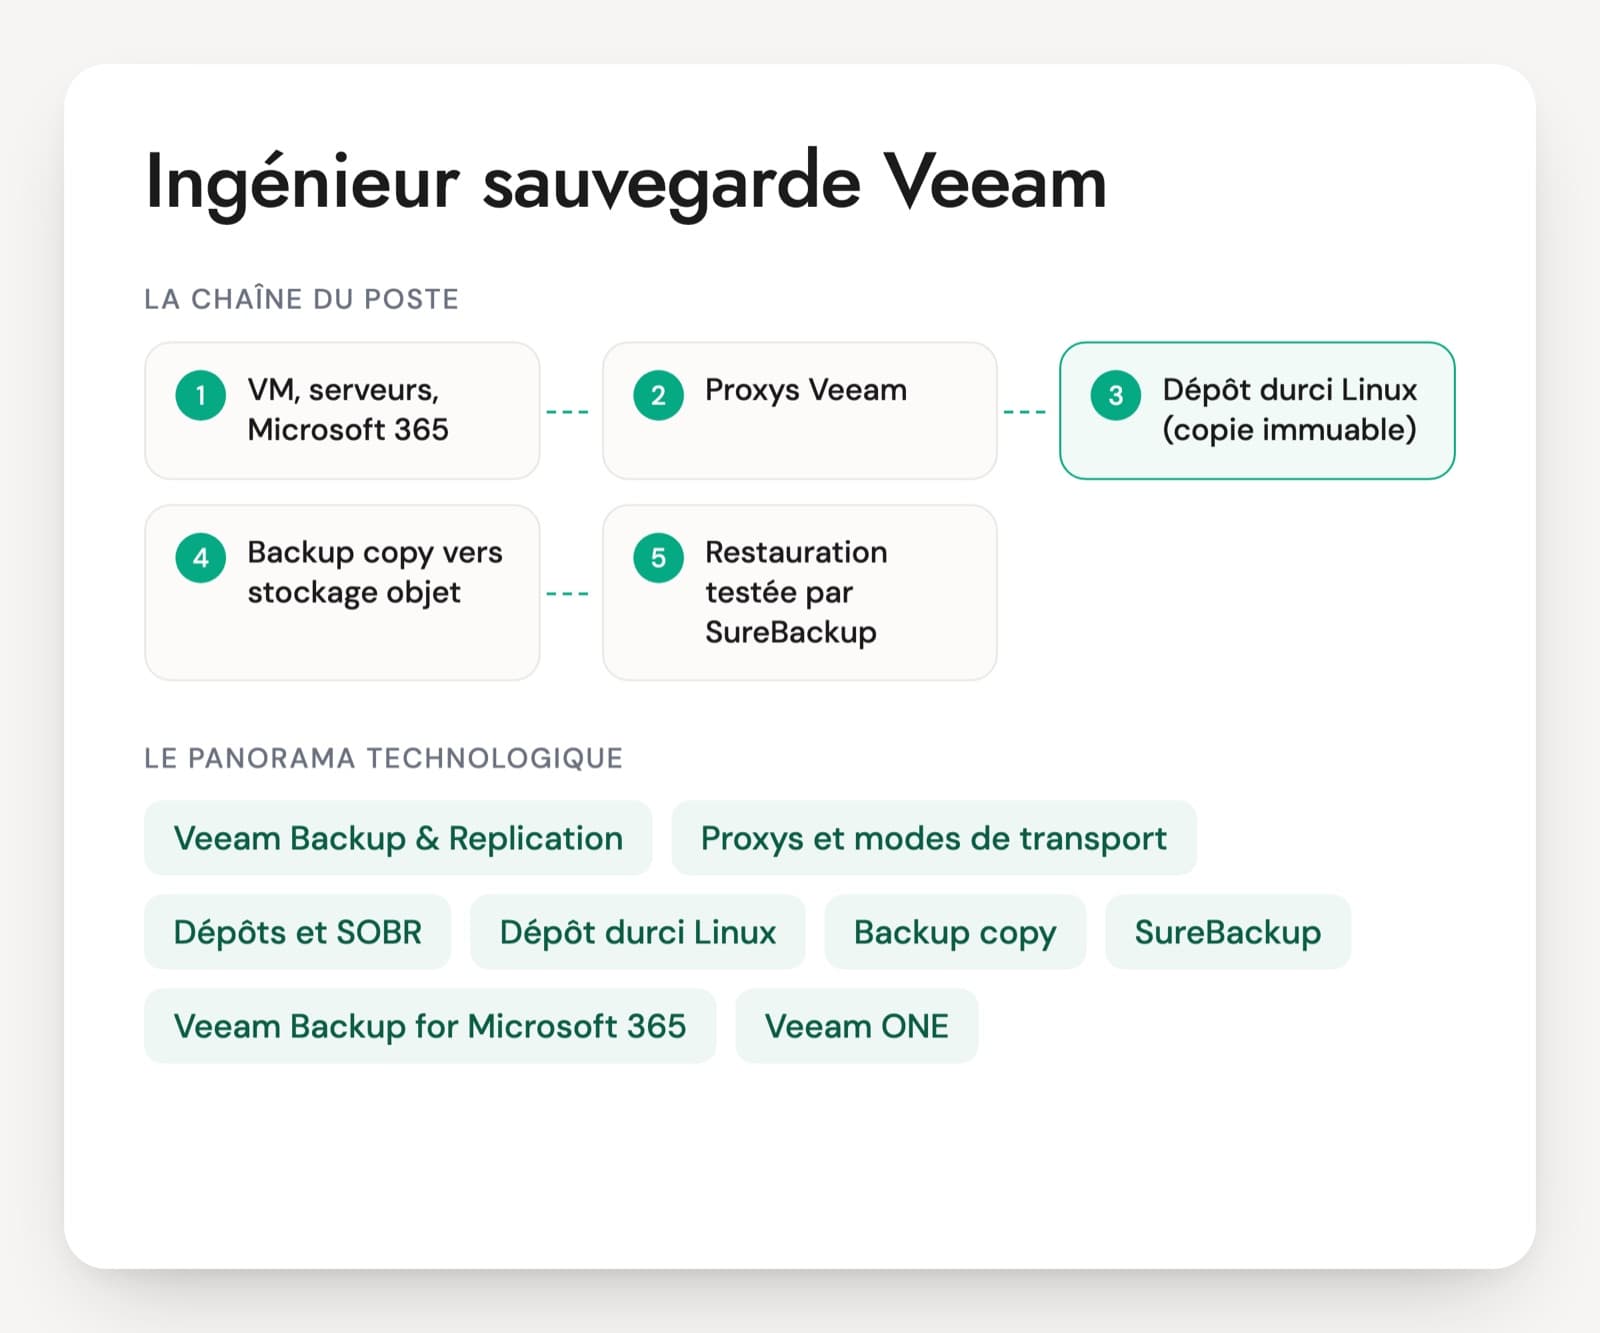
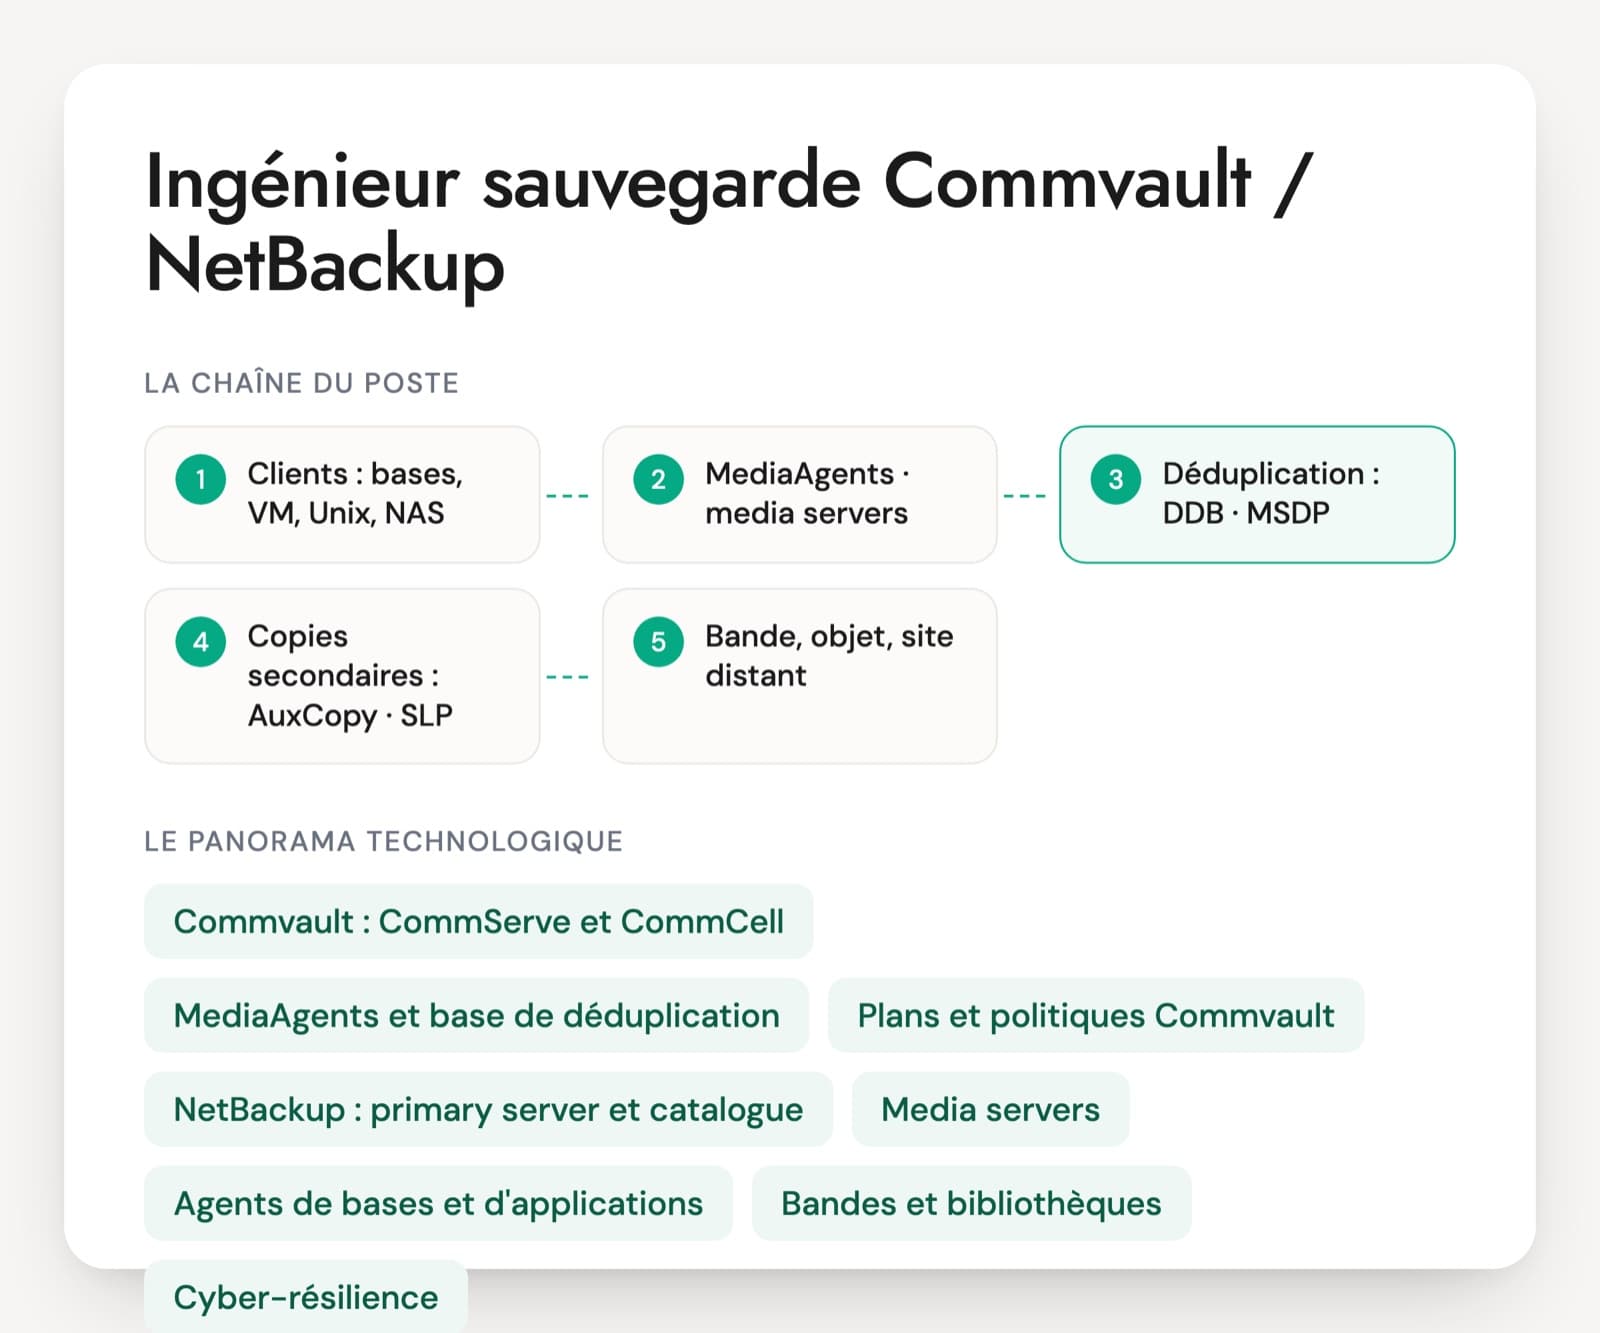
Beaucoup d'offres réunissent les deux, parce que les snapshots, la réplication et la sauvegarde se répondent dans un PRA. Sur un petit parc, un seul profil suffit souvent. Sur un parc large ou très réglementé, le volume de travail justifie deux spécialistes. L'entretien établit de quel côté la personne a vraiment exploité : un ingénieur sauvegarde qui n'a jamais fait de zoning n'est pas encore un ingénieur stockage.
Quel test technique est donné à un ingénieur stockage SAN / NAS ?
Un exercice sur papier ou au tableau fonctionne bien : un schéma avec deux fabrics, une baie et trois hôtes, dont l'un n'a qu'un chemin. Le candidat repère le problème, écrit les étapes pour présenter un volume, puis choisit un mode de réplication pour une contrainte donnée. Une sortie d'esxtop ou un export de statistiques de baie à commenter montre aussi vite la méthode de diagnostic.
Ceph est-il indispensable sur le CV d'un ingénieur stockage ?
Seulement si le poste l'exploite déjà ou prévoit de le faire. Ceph demande des compétences Linux et réseau qui ne recoupent qu'en partie celles du SAN. Un ingénieur stockage solide peut s'y former, mais le premier incident sur un cluster dégradé se passe mieux avec quelqu'un qui en a déjà vu. Pour un poste centré sur les baies, c'est un plus, pas une condition.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.