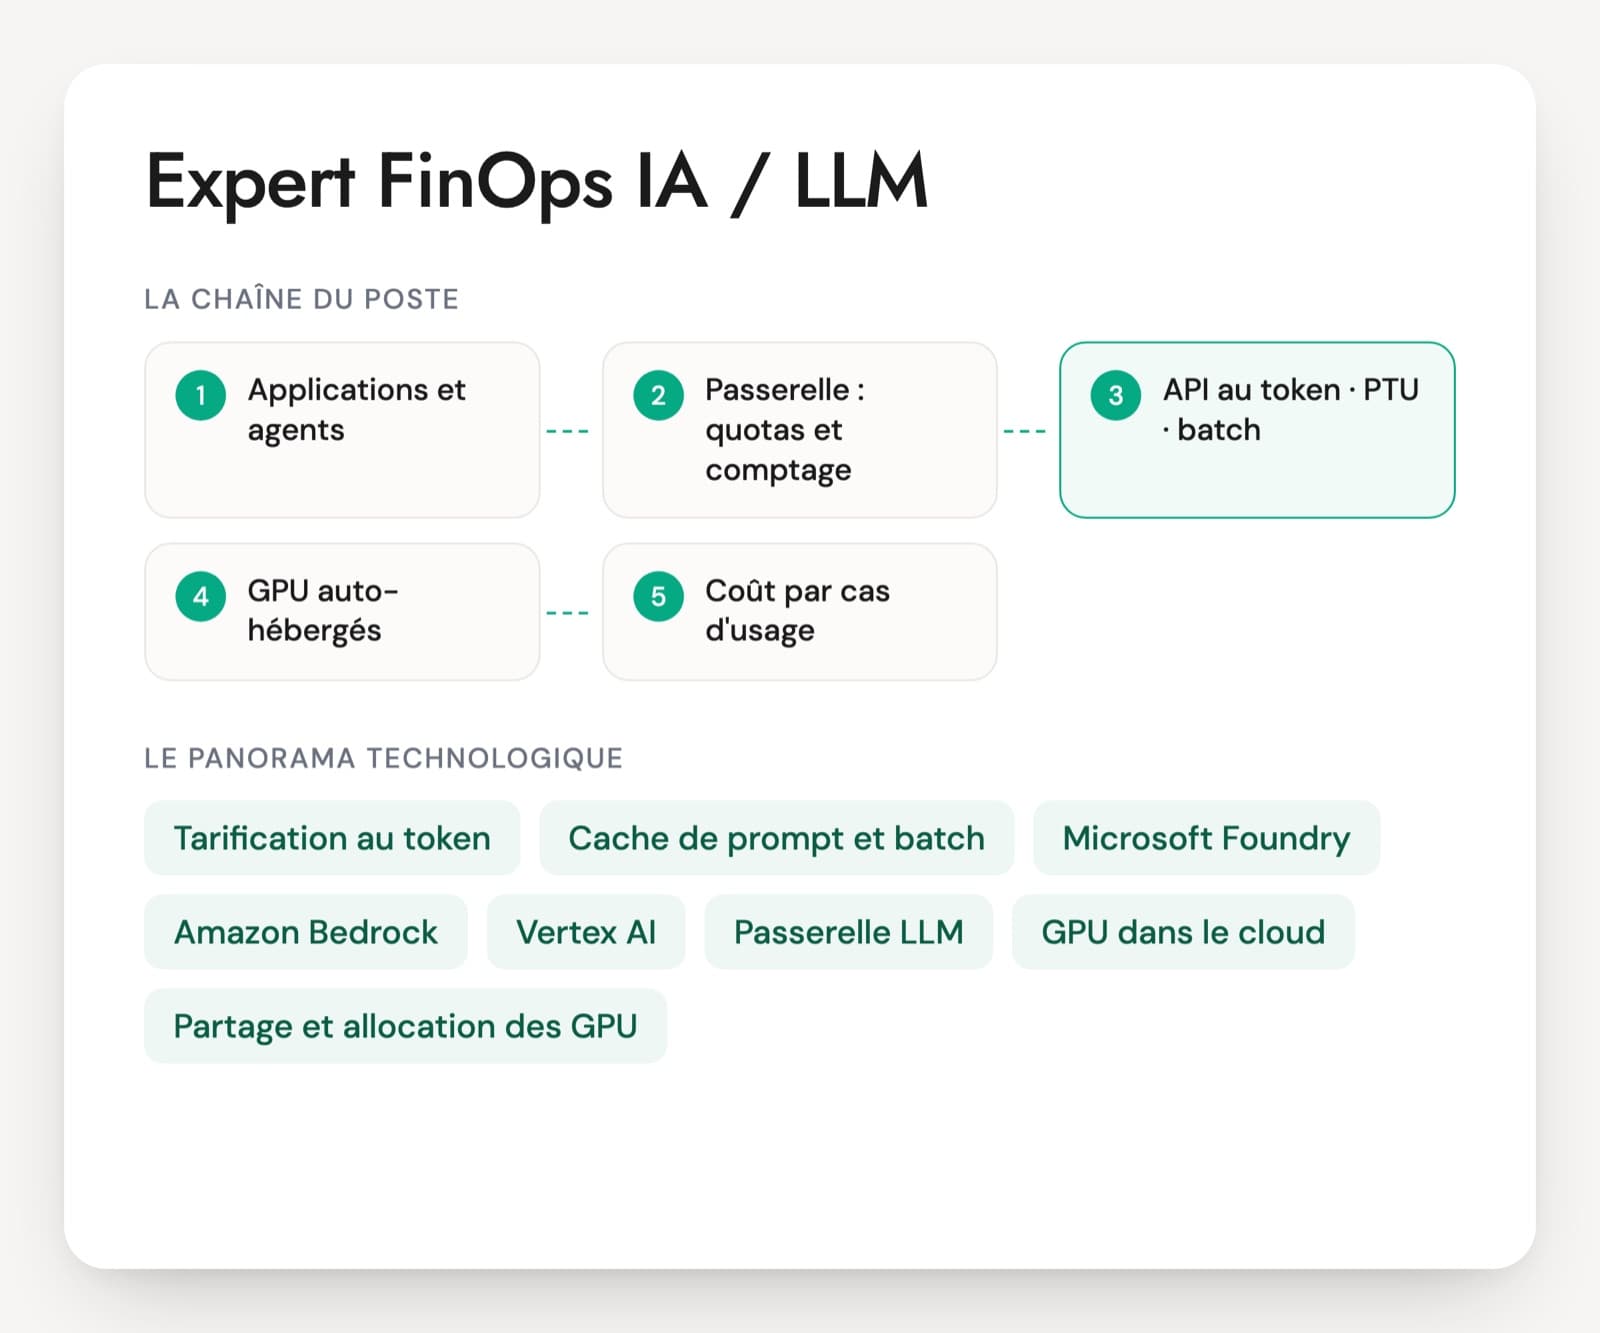
Les missions d'expert FinOps IA publiées en France demandent d'analyser l'usage des modèles d'IA générative, d'aider les équipes à maîtriser le coût des LLM, de construire des modèles TCO et ROI et de mettre en place showback et chargeback pour les plateformes IA. Elles citent Azure, AWS ou GCP, les modèles GPT, Claude, Gemini ou Mistral, Power BI ou Grafana, Python et SQL, et souvent les GPU des plateformes de machine learning.
Le poste demande deux cultures. Un consultant FinOps classique connaît l'allocation et les engagements, mais une facture au token ne se lit pas comme une facture d'instances : les tokens de raisonnement se paient comme de la sortie, le cache et le batch changent le prix, et un PTU se paie à l'heure qu'il serve ou non. Un ingénieur IA connaît les modèles sans toujours savoir répartir une facture entre directions.
Un cas d'usage suivi en production sert de fil : le coût par conversation ou par document traité, ce qui l'a fait baisser, et comment la qualité a été contrôlée après le changement de modèle. Le PDF contient la grille de 1 à 4 et un cas de 20 minutes sur un assistant interne qui dépasse son budget.
Les modèles de prix qu'un expert FinOps IA doit connaître
Tarification au token
Les API de modèles facturent séparément les tokens d'entrée et de sortie, la sortie coûtant plusieurs fois plus cher. Les tokens de raisonnement des modèles qui réfléchissent avant de répondre sont facturés comme de la sortie, même s'ils ne s'affichent pas. Les prix changent souvent et varient selon la région et le mode de routage.
Cache de prompt et batch
Le cache de prompt facture à prix réduit la partie d'un prompt déjà envoyée récemment, avec parfois un surcoût à l'écriture. Le batch traite les requêtes de façon asynchrone, dans un délai pouvant aller jusqu'à vingt-quatre heures, à prix réduit, environ moitié prix chez Azure et Bedrock. Les deux font baisser une facture sans changer de modèle.
Microsoft Foundry (Azure OpenAI)
Le service d'Azure qui sert les modèles OpenAI et d'autres fournisseurs. Il propose des déploiements standard au token, avec les options Flex et priority processing, des déploiements provisionnés en PTU et du batch. Standard et provisionné existent en version globale, par zone de données (UE, États-Unis ou Asie-Pacifique) ou régionale, le batch en version globale ou par zone de données. Ce choix pèse sur le prix et sur la résidence des données.
Amazon Bedrock
Bedrock donne accès aux modèles d'Anthropic, Meta, Mistral, Amazon et d'autres. Il propose plusieurs niveaux de service (Standard, Flex, Priority), un mode batch, un débit provisionné sans engagement ou sur un ou six mois, et des profils d'inférence d'application qu'on tague pour attribuer les coûts à une équipe.
Vertex AI
Sur Google Cloud, Gemini et les modèles partenaires se paient au token, avec des niveaux Standard, Priority et Flex et un débit provisionné acheté en GSU pour une durée fixée. La consommation remonte dans l'export de facturation BigQuery, comme le reste du cloud.
Passerelle LLM
Une passerelle placée devant les modèles (Azure API Management, LiteLLM, Portkey ou un développement interne) identifie chaque application, compte les tokens par équipe, applique des quotas et route vers le modèle adapté. C'est souvent la seule source fiable pour découper une facture que les tags ne découpent pas.
GPU dans le cloud
Instances GPU à la demande, spot, réservées ou en blocs de capacité, comme Capacity Blocks for ML chez AWS, réservables jusqu'à huit semaines à l'avance et non annulables. Un GPU se paie à l'heure, qu'il calcule ou non : son taux d'utilisation est le premier chiffre à demander.
Partage et allocation des GPU
MIG découpe un GPU NVIDIA récent en instances isolées, le time-slicing partage une carte sans isolation de la mémoire. Dans Kubernetes, ils font tenir plusieurs petits modèles sur un GPU. Côté coûts, les données d'allocation fractionnée d'AWS pour EKS attribuent aussi les GPU à chaque pod.
L'expert FinOps IA / LLM travaille entre l'équipe FinOps, la plateforme IA et les équipes produit qui lancent des cas d'usage. Il suit la consommation des API de modèles et des GPU, l'attribue aux équipes, conseille le choix entre paiement au token, débit provisionné et auto-hébergement, et construit les indicateurs de coût par résultat. La FinOps Foundation a ajouté l'IA aux catégories de technologies de son framework et publie des travaux sur le FinOps de l'IA : coût par inférence, coût par million de tokens, taux de cache, coût par résultat réussi. La pratique de ces calculs sur une facture réelle se vérifie en entretien.
Les compétences FinOps propres à l'IA
- Lecture d'une facture au token
- Allocation de la consommation IA
- Débit provisionné, quotas et engagements
- Coûts GPU d'entraînement et d'inférence
- Unit economics et choix du modèle
- Prévisions et anomalies propres à l'IA
Tokens, débit provisionné, GPU : questions pour un expert FinOps IA
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Une équipe passe d'un modèle classique à un modèle de raisonnement affiché au même prix par million de tokens. Pourquoi sa facture monte-t-elle quand même ?
Une bonne réponseLes tokens de raisonnement sont facturés comme des tokens de sortie, alors qu'ils n'apparaissent pas dans la réponse. Selon l'effort demandé, ils dépassent souvent de loin la réponse visible. Il mesure les tokens de sortie réels par requête dans le détail d'usage de l'API ou les métriques, règle le niveau d'effort de raisonnement et réserve ce modèle aux requêtes qui en ont besoin.
Signal d'alerteComparer deux modèles sur le seul prix affiché par million de tokens.
Question 2 · confirmé
Douze applications appellent Claude sur Bedrock avec le même identifiant de modèle. Comment attribuez-vous la facture à chacune ?
Une bonne réponseUn profil d'inférence d'application par application ou par équipe, tagué avec le centre de coûts, et chaque application appelle son profil au lieu de l'identifiant du modèle. Une fois activés comme tags de répartition, ces tags apparaissent dans le CUR. La journalisation des invocations et les métriques CloudWatch par profil donnent le volume de tokens. Sans profils, il reste la passerelle ou des comptes séparés.
Signal d'alerteRépartir selon le nombre d'utilisateurs déclaré par chaque application.
Question 3 · senior
À partir de quand un déploiement provisionné en PTU devient-il plus intéressant que le paiement au token ?
Une bonne réponseIl convertit le trafic en tokens par minute normalisés (sortie pondérée, cache déduit), regarde le profil sur la journée et la semaine, calcule le nombre de PTU pour la pointe et le coût mensuel, avec et sans réservation, puis compare au coût au token du même trafic. Le PTU se paie vingt-quatre heures sur vingt-quatre : un trafic concentré sur les heures de bureau le rentabilise mal, sauf si la latence garantie est le vrai besoin. Le débordement vers le standard absorbe les pointes.
Signal d'alertePasser en PTU dès qu'un montant mensuel est dépassé, sans regarder le profil horaire.
Question 4 · senior
Un entraînement de deux semaines sur huit GPU H100 est prévu le mois prochain. Comment achetez-vous la capacité ?
Une bonne réponseIl compare la demande (si la capacité existe), le spot avec des points de reprise fréquents, et les blocs de capacité réservés à l'avance : Capacity Blocks for ML chez AWS, réservables jusqu'à huit semaines avant et non annulables, Dynamic Workload Scheduler chez Google Cloud. Une réservation d'un an ne se justifie que si le parc sert ensuite en continu. Il chiffre aussi le stockage des données et des checkpoints et le transfert.
Signal d'alerteLancer des instances à la demande le jour prévu sans vérifier la disponibilité.
Question 5 · confirmé
Quel indicateur de coût proposez-vous pour un assistant de support client, et comment le calculez-vous ?
Une bonne réponseLe coût par demande résolue, plutôt que le coût par requête ou par token : coût total du cas d'usage (modèles, embeddings, recherche, infrastructure, part de la plateforme) divisé par les demandes qui atteignent le critère de qualité convenu avec le métier. Il le présente en distribution et pas seulement en moyenne, car le coût varie beaucoup d'une conversation à l'autre. Il le compare au coût du traitement sans IA quand le métier le connaît.
Signal d'alerteLe coût par million de tokens comme seul indicateur.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Expert FinOps IA : questions fréquentes
En quoi le FinOps de l'IA diffère-t-il du FinOps cloud classique ?
Les unités changent : tokens d'entrée, de sortie et en cache, unités de débit provisionné, heures de GPU, sièges d'assistants. Les prix bougent souvent, les lignes au token ne portent pas de tags par application, et un changement de prompt peut doubler la consommation d'un jour à l'autre. Le coût se juge aussi avec la qualité : le modèle le moins cher n'a d'intérêt que s'il atteint le niveau attendu par le métier.
Faut-il un profil FinOps ou un profil IA pour ce poste ?
Il faut les deux bases, et les profils complets restent rares. Un consultant FinOps apporte l'allocation, les engagements et le dialogue avec la finance ; il doit apprendre la tarification des modèles et le fonctionnement d'une passerelle LLM. Un ingénieur IA connaît les modèles et les GPU ; il doit apprendre l'allocation et les prévisions. L'entretien cherche le côté le plus faible et vérifie qu'il a déjà servi en production.
Quel exercice donner à un expert FinOps IA ?
Un extrait de journal de passerelle ou de métriques de tokens sur une semaine, avec les prix des modèles. Le candidat calcule le coût par application, le coût moyen d'une demande et une estimation du nombre de PTU pour le même trafic. Vingt minutes suffisent pour voir s'il pondère la sortie, déduit le cache et tient compte du profil horaire. Cet exercice dit plus qu'un test technique générique sur le cloud.
Quels fournisseurs et outils doit-il connaître ?
Au moins un des trois grands services de modèles, Microsoft Foundry, Amazon Bedrock ou Vertex AI, avec ses modes de facturation : au token, batch, niveaux de priorité, débit provisionné. Côté infrastructure, les instances GPU et leurs modes d'achat. Côté données, l'export de facturation de son cloud, SQL et un outil de reporting comme Power BI ou Grafana. Une passerelle LLM déjà exploitée en production est un vrai plus.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.