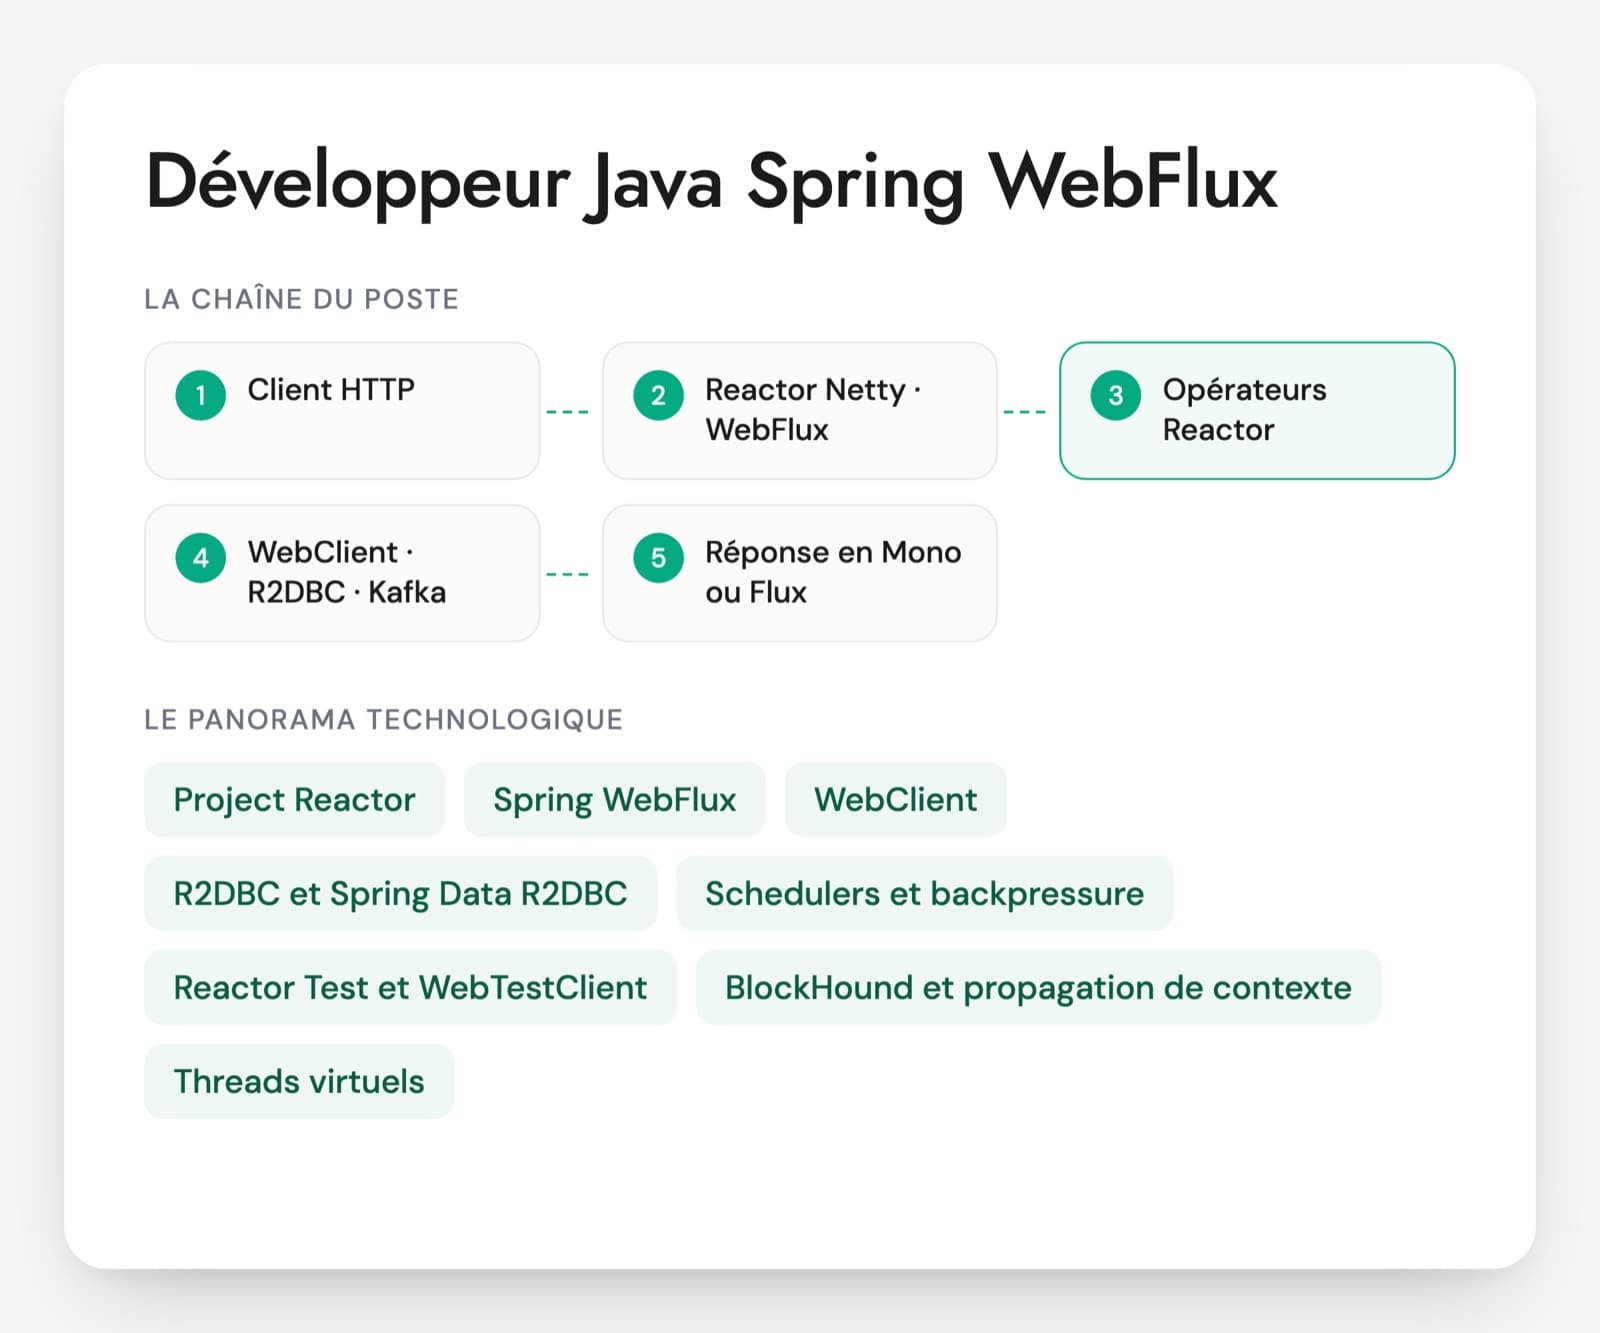
Le développeur Java réactif travaille sur des services Spring Boot écrits avec WebFlux et Project Reactor : des API qui renvoient des Mono et des Flux, des appels sortants avec WebClient, une base lue en R2DBC ou en MongoDB réactif, souvent du Kafka derrière. Les offres de développeur Spring WebFlux sont moins nombreuses que celles en Spring MVC, et une bonne partie des missions porte sur un code réactif existant à maintenir ou à faire évoluer.
L'écart à mesurer se situe entre un code qui compile et un code qui tient la charge. Beaucoup de CV citent WebFlux pour un projet où chaque méthode finissait par un block(). Un profil qui a tenu un service réactif en production parle sans qu'on le relance de backpressure, de schedulers, de traces de pile illisibles et de contexte perdu entre deux threads.
Depuis Java 21, les threads virtuels changent la discussion. Spring Boot les active par une simple propriété, et un service bloquant classique encaisse alors beaucoup de connexions simultanées. Un senior sait dire ce que le réactif apporte encore (streaming, backpressure, composition d'appels) et ce qu'il coûte en lisibilité. Le PDF déroule l'entretien complet sur six axes.
Ce qu'il y a sous un service Spring WebFlux
Project Reactor (Mono, Flux)
La bibliothèque réactive de Spring. Mono porte zéro ou un élément, Flux une suite d'éléments. Rien ne s'exécute avant l'abonnement, et les opérateurs (map, flatMap, concatMap, zip) décident de l'ordre et du parallélisme. C'est la base du poste, à vérifier en premier.
Spring WebFlux
Le framework web non bloquant de Spring, en version 7 avec Spring Boot 4. Il tourne par défaut sur Reactor Netty avec peu de threads, en général un par cœur. Il propose des contrôleurs annotés comme Spring MVC, ou des routes fonctionnelles.
WebClient
Le client HTTP réactif. On le trouve aussi dans des applications Spring MVC pour paralléliser des appels sortants. Délais, nouvelles tentatives et pool de connexions se règlent explicitement, sinon un service lent entraîne tout le reste.
R2DBC et Spring Data R2DBC
L'accès réactif aux bases SQL (PostgreSQL, MySQL, SQL Server, Oracle). Pas de chargement paresseux ni de relations gérées comme en JPA : les jointures s'écrivent à la main. Les transactions passent par un gestionnaire réactif.
Schedulers et backpressure
Les schedulers (boundedElastic, parallel) décident sur quels threads tourne chaque partie de la chaîne. La backpressure permet au consommateur d'indiquer combien d'éléments il peut recevoir. Les deux notions reviennent dans presque tous les incidents de charge.
Reactor Test et WebTestClient
StepVerifier vérifie les éléments émis, les erreurs et la fin d'un flux, y compris avec un temps virtuel pour tester des délais sans attendre. WebTestClient teste les endpoints sans démarrer de vrai client HTTP.
BlockHound et propagation de contexte
BlockHound détecte en test les appels bloquants sur un thread non bloquant. Micrometer et la bibliothèque context-propagation transportent l'identifiant de trace et le MDC à travers les changements de thread, ce que les ThreadLocal ne font pas seuls.
Threads virtuels (Java 21 et plus)
L'alternative au réactif pour les services d'API. Avec Spring MVC et spring.threads.virtual.enabled, le code reste bloquant et lisible tout en tenant beaucoup de connexions. Un bon candidat compare les deux modèles sans parti pris.
Le réactif en Java s'est diffusé avec les passerelles d'API, les services qui agrègent plusieurs appels sortants et les flux continus (server-sent events, WebSocket, consommation de messages). Spring Cloud Gateway, par exemple, a d'abord été construit sur WebFlux. Beaucoup de postes portent sur un code réactif écrit il y a quelques années, parfois par une équipe partie depuis, et sur la décision de le garder ou d'en sortir. Les compétences se transposent en partie vers Mutiny (Quarkus), RxJava ou les coroutines Kotlin. Reactor Kafka, souvent utilisé pour consommer Kafka en réactif, n'est plus maintenu : son support open source a pris fin le 30 juin 2026 et le dépôt est archivé.
Les acquis à contrôler chez un développeur Java réactif
- Opérateurs Reactor et composition de flux
- Threads, schedulers et code bloquant
- Backpressure et flux continus
- Accès aux données réactif (R2DBC)
- Gestion des erreurs et résilience des appels
- Tests, débogage et observabilité
Cinq questions sur Reactor et WebFlux
Chaque question vient avec ce qu'une bonne réponse contient et le signal qui doit vous alerter. Pas besoin d'être technique pour les poser : écoutez si le candidat raconte du vécu.
Question 1 · confirmé
Dans un contrôleur WebFlux, un collègue appelle un repository JPA puis renvoie Mono.just(résultat). Les temps de réponse explosent dès 200 requêtes simultanées. Expliquez.
Une bonne réponseL'appel JPA bloque un thread de la boucle d'événements de Reactor Netty, et ces threads sont peu nombreux, en général un par cœur. Mono.just n'y change rien : la valeur est calculée avant même la création du Mono. Les options sont un accès réactif (R2DBC), un Mono.fromCallable avec subscribeOn(Schedulers.boundedElastic()) en solution de transition, ou un retour à Spring MVC si toute la pile est bloquante. Il cite BlockHound pour repérer ce genre d'appel en test.
Signal d'alerte« C'est réactif puisque ça renvoie un Mono », ou augmenter le nombre de threads de Netty.
Question 2 · confirmé
flatMap, concatMap ou flatMapSequential : lequel utilisez-vous pour appeler un service distant pour chacun des 10 000 identifiants d'un Flux ?
Une bonne réponseflatMap lance les appels en parallèle et rend les résultats dans l'ordre d'arrivée, concatMap les fait un par un en gardant l'ordre, flatMapSequential parallélise et restitue l'ordre d'origine. Pour 10 000 appels, il limite la concurrence avec le second paramètre de flatMap (16 ou 32 appels à la fois, par exemple) pour ne saturer ni le service appelé ni le pool de connexions de WebClient.
Signal d'alerteUn flatMap sans limite, qui lance jusqu'à 256 appels simultanés (la valeur par défaut) sans que la personne le sache, ou un block() à chaque élément.
Question 3 · senior
Un Flux produit des événements plus vite que le client ne peut les lire. Que se passe-t-il, et quelles stratégies de backpressure connaissez-vous ?
Une bonne réponseDans Reactor, l'abonné demande un nombre d'éléments (request(n)) et l'émetteur respecte cette demande quand il le peut. Pour une source qu'on ne contrôle pas, il faut choisir : onBackpressureBuffer avec une taille bornée, onBackpressureDrop, onBackpressureLatest ou un échantillonnage. Sur HTTP, la backpressure passe par TCP et son contrôle de flux, et un client lent finit par remplir des tampons côté serveur.
Signal d'alerteUn buffer sans limite, qui repousse le problème jusqu'à l'OutOfMemoryError, ou aucune notion de request(n).
Question 4 · confirmé
Un appel WebClient vers une API externe échoue de temps en temps. Comment écrivez-vous le délai, les nouvelles tentatives et la valeur de repli ?
Une bonne réponseUn délai de réponse sur le client HTTP et l'opérateur timeout, puis retryWhen avec Retry.backoff limité en nombre et filtré sur les erreurs passagères (5xx, délai dépassé), seulement si l'appel est idempotent. Enfin onErrorResume ou onErrorReturn pour une réponse dégradée, ou un circuit breaker Resilience4j avec son module Reactor. Les erreurs 4xx ne se rejouent pas.
Signal d'alerteretry() sans argument, qui rejoue à l'infini, ou un try/catch autour de la chaîne qui ne capte rien.
Question 5 · senior
Les logs perdent l'identifiant de trace dès qu'une requête passe dans un flatMap. Pourquoi, et comment le corrigez-vous ?
Une bonne réponseLes ThreadLocal, dont le MDC des logs, sont attachés à un thread, et la chaîne Reactor change de thread. Le Context de Reactor (contextWrite) transporte ces informations le long de la chaîne. Avec Micrometer Tracing et la bibliothèque context-propagation, Hooks.enableAutomaticContextPropagation() restaure les ThreadLocal à chaque opérateur ; Spring Boot l'active avec la propriété spring.reactor.context-propagation=auto.
Signal d'alertePasser l'identifiant en paramètre de chaque méthode, ou ne pas savoir que la chaîne change de thread.
Recevez la fiche d'entretien complète en PDF
La fiche pour mener l'entretien de bout en bout, prête à imprimer ou à partager avec le manager.
- 30 questions sur 6 axes, avec la bonne réponse, le signal d'alerte et la relance
- Le niveau visé pour chaque question
- Une mise en situation de 20 minutes et ce qu'on attend du candidat
- La grille d'évaluation de 1 à 4, axe par axe
Questions fréquentes sur le recrutement d'un profil WebFlux
Quels signes montrent qu'un candidat a vraiment travaillé en WebFlux ?
Il parle des problèmes avant les avantages : un appel bloquant trouvé dans une bibliothèque, une trace de pile sans son propre code, un identifiant de trace perdu dans les logs, un flatMap qui saturait un service appelé. Il sait dire quel scheduler tournait à quel endroit. Un profil qui n'a fait que lire des tutoriels décrit Mono et Flux correctement, mais reste vague dès que vous demandez ce qui a cassé en production.
WebFlux a-t-il encore un intérêt depuis les threads virtuels ?
Oui, pour certains usages. Les threads virtuels permettent d'écrire du code bloquant qui tient beaucoup de connexions, ce qui couvre une grande partie des API classiques. WebFlux reste pertinent pour le streaming vers le client, la backpressure de bout en bout, les passerelles et la composition de nombreux appels sortants. Un candidat senior doit savoir défendre l'un ou l'autre sur un cas précis, et dire ce que coûterait une migration.
Faut-il aussi connaître RxJava, Mutiny ou les coroutines Kotlin ?
Non, sauf si votre projet les utilise. Les notions sont les mêmes : flux paresseux, opérateurs, backpressure, choix du thread d'exécution. Un développeur solide en Reactor passe à Mutiny ou à RxJava en apprenant de nouveaux noms d'opérateurs. Les coroutines Kotlin demandent un peu plus d'adaptation, car le code s'écrit de façon séquentielle. Vérifiez la compréhension du modèle plutôt que la liste des bibliothèques.
Comment construire un test technique sur Reactor ?
Partez d'un code réel plutôt que d'un exercice d'algorithme. Un contrôleur WebFlux qui appelle un service lent et une méthode bloquante, avec trois défauts à corriger : un block(), un flatMap sans limite de concurrence, un retry() sans fin. Ajoutez un test StepVerifier à écrire. En 45 minutes, commenté à voix haute, l'exercice montre la lecture d'une chaîne, le placement du code bloquant et la gestion des erreurs.
Pour structurer vos autres entretiens, consultez aussi nos pages sur les questions d'entretien de recrutement, la méthode de l'entretien structuré et la grille d'évaluation d'entretien.